本专题将聚焦“AI Infra、推理工程与异构计算”领域... 展开 >
AI Infra、推理工程与异构计算
会议室:大宴会厅C出品人:黄之鹏
- Topic 1
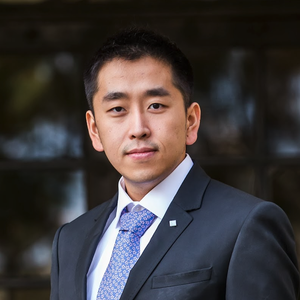
黄之鹏
华为 AI 开源生态总监 - Topic 2
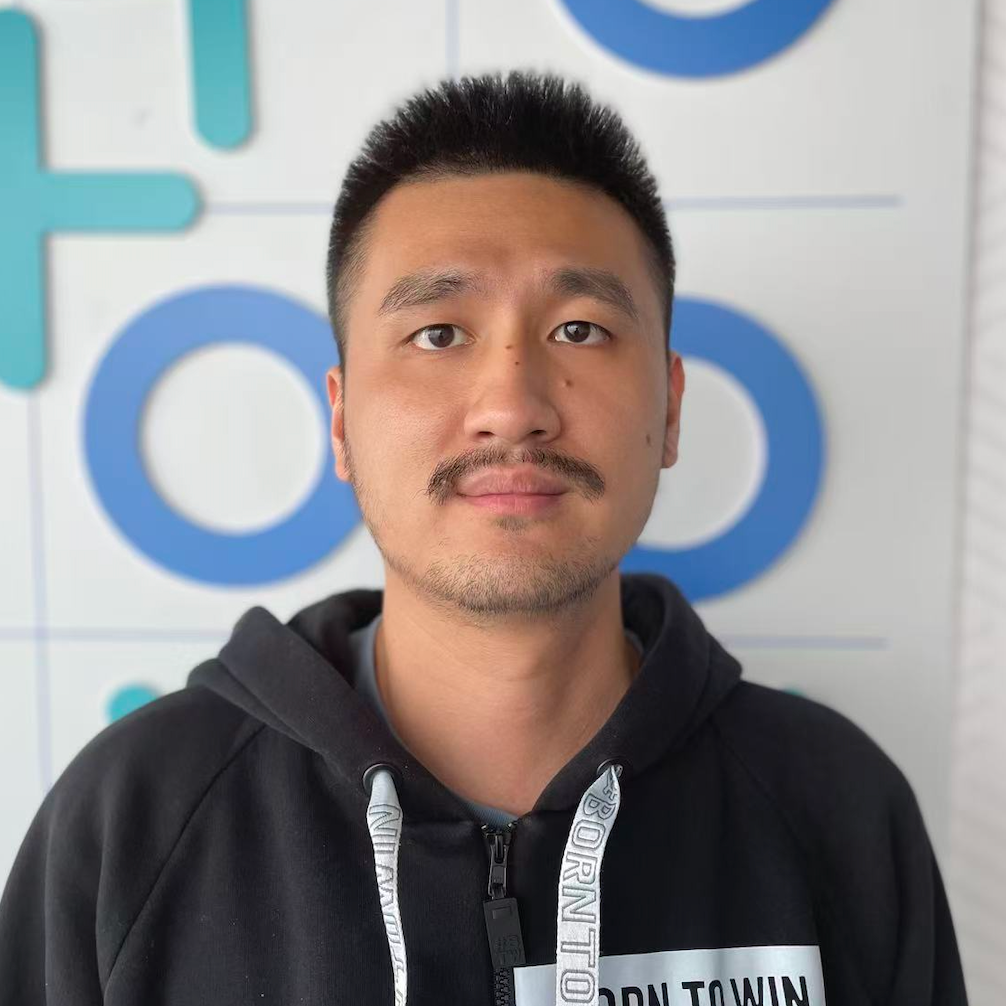
杨守仁
范式智能 系统研发专家 - Topic 3
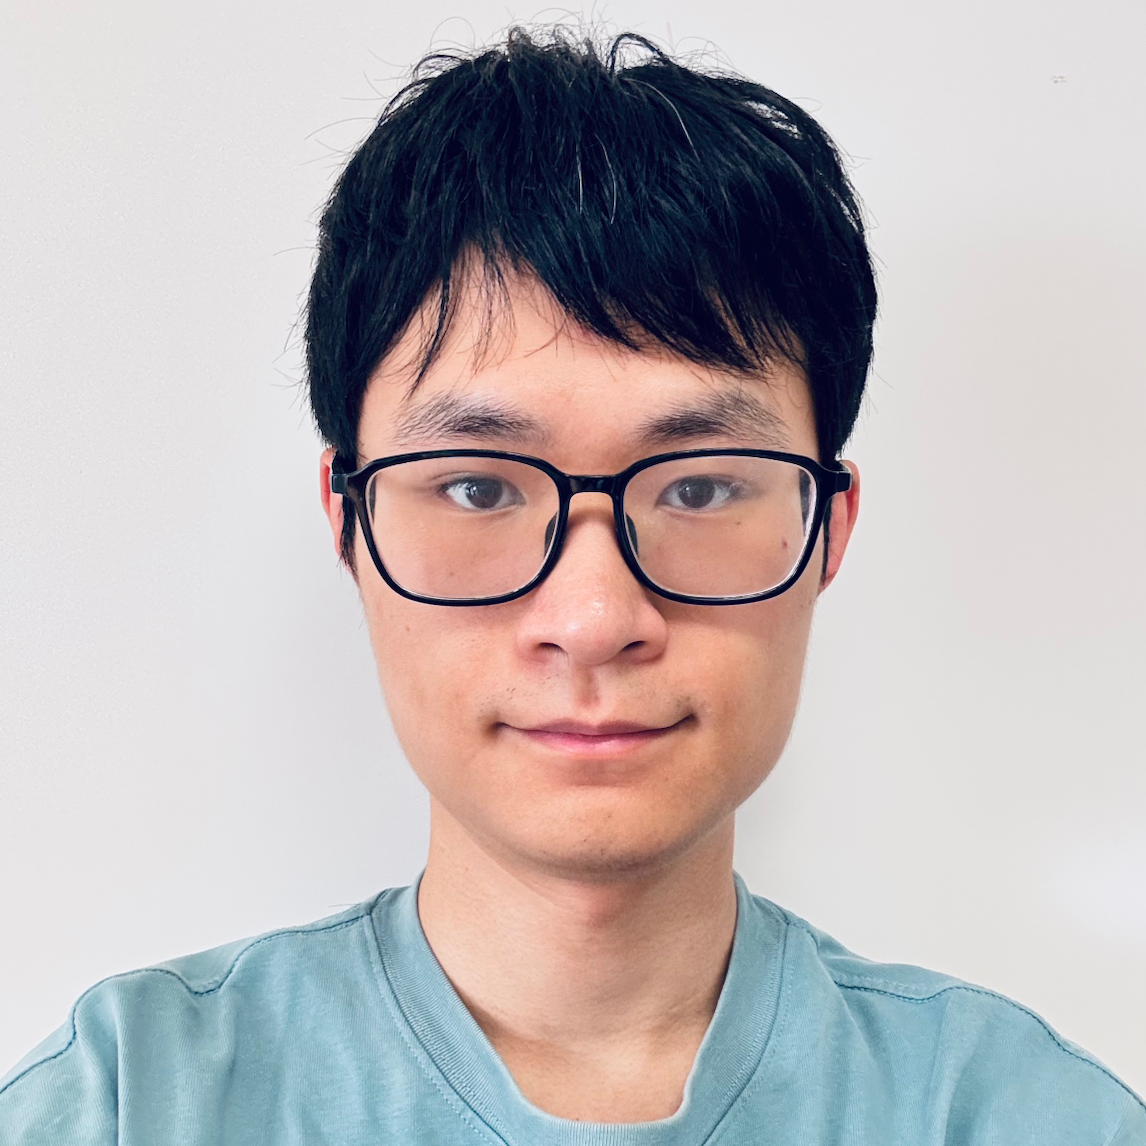
章程瑞东
阿里巴巴 Qwen 团队算法工程师 - Topic 4
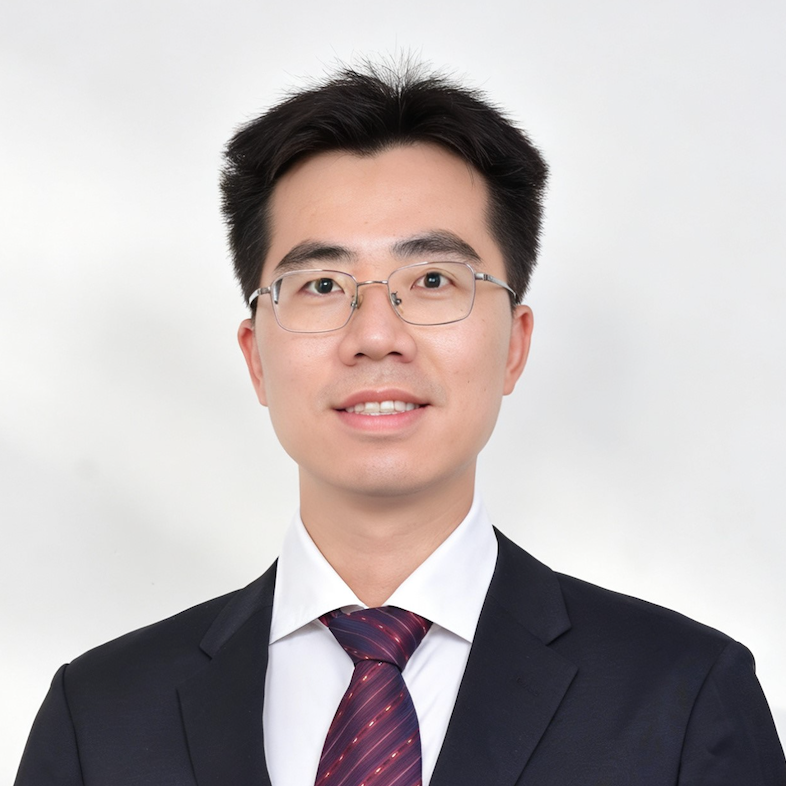
李柏潮 博士
华为 2012 实验室 大模型系统工程技术专家 - Topic 5
莫梓峰
Inferact vLLM committer - Topic 6
尚旭春
TokenSpeed 独立贡献者 - Topic 7
杨雨豪
SGLang, RadixArk Engineer
专题出品人:黄之鹏
华为AI 开源生态总监
黄之鹏,目前担任华为 AI 开源生态总监。同时担任 LFAI & Data 基金会主席,Open Model Initiative 社区技术委员会主席,CCF 开源发展委员会执委,启智 OpenI 社区等开源组织的技术委员会的委员职务, Kubernetes Policy 工作组以及 CNCF 基金会安全兴趣组中 Policy 团队负责人, OpenStack Cyborg 项目创始人, 并且带领团队参与 ONNX, Kubeflow, Akraino 等开源社区。曾经在 OpenStack Summit、Cloud Native Con/KubeCon 等国际顶级开源峰会进行过 Keynote 主题演讲,此外也在 LinuxCon、RISC-V Summit 等多个国际峰会进行议题分享。
地点:大宴会厅C
专题:AI Infra、推理工程与异构计算
本专题将聚焦“AI Infra、推理工程与异构计算”领域的关键技术演进与产业实践,重点关注大模型推理架构、异构算力协同、推理性能优化、模型服务化、AI 集群调度、AI 原生基础设施以及下一代 AI 数据中心等方向。拟邀请来自模型厂商、云计算平台、芯片公司、开源社区及 AI 应用企业的技术负责人与行业专家,共同探讨 AI 基础设施从“可用”走向“高效可规模化”的关键路径。
拟讨论的方向 / 拟解决的问题包括但不限于:
- 大模型推理成本持续攀升,如何通过系统级优化实现降本增效?
- 推理框架、编译器与 Runtime 如何协同优化模型性能?
- MoE、多模态与长上下文场景下,AI Infra 面临哪些新的挑战?
- Agent 时代 AI Infra 的新挑战和新机遇
- 国产芯片与国产 AI Infra 软件栈如何构建生态协同能力?
- AI Infra 主流开源社区在 Agent 时代的最佳实践
本专题希望搭建一个连接“芯片、系统、框架、平台与应用”的交流场域,不仅关注前沿技术趋势,更强调真实业务场景中的工程实践与产业落地。我们期待通过跨领域的观点碰撞,推动 AI 基础设施能力从“支撑模型”进一步迈向“定义 AI 生产力”,共同探索大模型时代高性能、低成本与可持续演进的基础设施未来。
by 黄之鹏
华为
AI 开源生态总监随着 AI 开源项目快速增长,如何让一个开源项目真正形成社区、吸引开发者持续参与,并进一步连接更多项目与产业伙伴,成为 AI 开源走向规模化过程中需要解决的实际问题。本次分享将结合 LFAI&Data 基金会与 Omni-AI 开源社区的实践,介绍从开源项目运营、开发者协作到社区生态建设的具体探索。
by 杨守仁
范式智能
系统研发专家随着国产算力的发展,算力集群的从单一的 NVIDIA 设备逐步走向有更多不同国产厂商设备构成的异构算力集群,异构算力的管理这个问题逐步浮出水面。HAMi 作为范式参与发起的项目,是范式在异构算力管理上的实践的成果。HAMi 在易用性和管理能力上取得了一个较好的平衡,但是受限于 Kubernetes 的 Device Plugin 本身的缺陷,调度性能和精细化分配的能力面临瓶颈。但是随着 Kubernetes v1.34 将 Dynamic Resource Allocation(DRA) 特性正式推进至 GA,集群设备资源管理从以节点为中心的分配模型,逐步演进为以资源对象为核心的声明式管理模式,相比传统 Device Plugin 接口仅能暴露简单容量信息,DRA 通过引入 ResourceClaim 使设备资源能够在 Pod 创建之前完成表达与约束,为 GPU 等复杂硬件资源的精细化调度提供了新的基础能力。
HAMi-DRA 是 HAMi 社区在 DRA 方向上的最新实践,结合范式自身的异构算力管理实践,HAMi-DRA 能在不牺牲核心调度能力的前提下,将现有 GPU 虚拟化调度体系平滑迁移至 DRA 资源模型。从范式的实践结果来看 HAMi-DRA 在调度性能和精细化管理方面带来了显著的提升。
本次分享将从 Kubernetes 设备资源模型演进的视角出发,向大家介绍范式以及 HAMi 社区在异构设备管理的面临的挑战和实践,同时详细解析 HAMi-DRA 的整体架构设计与关键实现细节,展示如何基于 DRA 构建面向 AI 工作负载的可扩展 GPU 调度方案,并且综合说明在落地 HAMi-DRA 的过程中范式以及社区遇到的挑战。
演讲提纲
1. 背景和动机
- 异构设备管理的挑战
- 传统 Device Plugin 的局限性
2. HAMi 的如何解题
- HAMi 设计思路和关键实现
- HAMi 的问题和挑战
3. Kubernetes DRA 介绍
- DRA API
- Consumable Capacity 特性
4. HAMi-DRA 设计和实践
- 整体架构和设计理念
- HAMi-DRA 的落地挑战
- Kubernetes 版本
- 学习成本
- 有限的设备支持
- 基于 HAMi-DRA 的 GPU 调度方案
- 调度性能提升
- 完善的设备生命周期管理
- 差异化的设备资源分配
5. 总结和展望
- HAMi-DRA 后续规划
- 多个 DRA Driver 联动支持
实践痛点
- 依赖高版本的 Kubernetes,生产环境推动困难
- DRA API 还在持续演进,部分特性还不是特性稳定,有一定的集成成本
- 开箱即用的 DRA Driver 数量较少,支持的异构设备的数量有限
听众收益
- 详细解析异构算力管理上的挑战
- 深度拆解 HAMi 和 HAMi-DRA 的设计和关键实现
- 完整介绍基于 DRA 的 GPU 调度方案的挑战和实践
by 章程瑞东
阿里巴巴
Qwen 团队算法工程师自 Qwen-3.5 采用混合注意力结构以来,Qwen 系列模型的线性注意力层 Gated Delta Network(GDN)在训练与推理中的开销日益显著。现有实现面临两大难题:一是多步算子需要反复读写 HBM,访存瓶颈严重;二是状态递推的串行性使算子并行度受限于注意力头数,在长序列、小 batch 或 TP 场景下 GPU 利用率低下。为此,我们提出 FlashQLA —— 基于 TileLang 的高性能线性注意力算子库。核心方案包括:将 GDN Chunked Prefill 的前向与反向流程各拆分为两个融合算子,通过数据复用降低访存开销,并在算子内通过 warp-specialization 实现不同计算的重叠;基于门控衰减的自动化卡内序列并行,并建立数学模型动态调节并行粒度;针对具有指数衰减特性的注意力头,舍弃昂贵的修正矩阵计算,改用轻量级预热获得精确状态。在 Hopper 显卡上,FlashQLA 相比 FLA Triton kernel 实现前向 2–3 倍、反向 2 倍加速,且在 TP 增大时加速比持续提升,显著优化了预训练与端侧推理效率。
演讲提纲
1. 背景与挑战
- Qwen 模型训练与推理 Prefill 过程中 GDN 模块的耗时
- 性能瓶颈剖析:
- 访存密集型:分步 kernel 大量读写 HBM,中间变量开销大
- 并行度受限:状态递推依赖导致 thread block 数量不足,SM 利用率低(尤其在 TP、小 batch 场景)
2. 优化方案
- 设计目标:兼顾访存优化与序列并行,避免极端方案(Fully-fused / 多步算子)的缺陷
- 核心策略:
- 拆分为两个 fused kernel,在 kernel 间插入 CP 预处理,平衡数据重用与并行度
- 门控驱动的动态并行:根据 batch_size × num_heads 和序列长度自动开启卡内序列并行
- 利用门控衰减性质:采用 warmup 替代昂贵的修正矩阵计算,大幅降低预处理开销
3. 系统设计思路
- 对前向与反向流程做等价的代数改写,降低计算复杂度
- 从门控衰减到滑动窗口及背后的代数原理
- 自动卡内序列并行的参数设计
4. 算子实现细节
- 计算与访存负载分析
- 片上资源分析
- 如何用 Tilelang 手动实现 warp-specialization
5. 性能评估
6. 开放问题
- GDN 模块剩余的优化空间
- KDA 及其他线性注意力结构的优化方案
- 芯片硬件方面对线性注意力算子的限制
实践痛点
- 不能覆盖所有场景
- 算子复用性较差
听众收益
- 线性注意力模块在系统上的一些性质
- 与算法创新相结合的系统优化流程
- 复习线性代数
by 李柏潮 博士
华为
2012 实验室 大模型系统工程技术专家通信开销是大模型训练和推理中不可忽视的性能瓶颈。在 MoE 模型中,AllToAll 通信占总端到端时间的 30% 以上,是一直以来的优化重点;而 1M 超长上下文场景下,Host to Device 的 KV Cache 传输延迟已成为推理 TTFT 的新“拦路虎”。深度亲和昇腾硬件进行通信优化,才能最大化将昇腾算力潜能转化为模型训练/推理性能提升。
本次分享围绕昇腾平台的两类通信优化展开。第一部分聚焦 MoE 场景下的 AllToAll,通过适配昇腾 950 的网络拓扑和 CCU 通信加速器,在盘古模型的 EP 通信域 AllToAll 上实现了 10% 以上的性能提升。第二部分关注超长序列推理中的 KV Cache 卸载,通过 Omni Cache 高效的 H2D 和 D2H 通信,实现 TTFT 提升 10 %以上。更进一步,我们将展望如何通过昇腾亲和实现最优的通算掩盖,使得通信不再成为暴露在训练/推理端到端时延中的短板。
希望本次分享能为业界其他模型在昇腾平台上优化通信性能提供借鉴,共同繁荣昇腾软件硬件生态。
演讲提纲
1. 大模型的训练/推理在通信方面面临哪些技术挑战?
- MoE 阶段的 AllToAll 通信是长期以来的关键瓶颈
- 在超长上下文场景,H2D 通信成为推理场景新出现的性能瓶颈
2. 亲和昇腾硬件,加速 EP 域的 AllToAll
- 拓扑亲和案例:DeepEP 方案不适用于昇腾 910A3
- 算力亲和案例:发挥昇腾 950 专门通信加速引擎 CCU 的最大效用
- 模型亲和案例:使用自定义通信算子实现灵活的集合通信新语义
3. 硬件软件双管齐下,加速 H2D(Host to Device)的通信交互
- 硬件优化:昇腾 950 为每个 NPU 提供专用的 H2D 通路
- 软件优化:Omni Cache 实现高效 KV cache 卸载
4. 总结和展望
- 优化抓手:尽量减少未被掩盖的通信时间
- 进一步优化:亲和昇腾硬件实现融合算子/多流并行的流水编排
实践痛点
- 针对昇腾 950 硬件平台进行通信优化,牺牲普适性,换取性能提升
- 同样的策略用到其他平台上(例如昇腾910A2/A3,NVIDIA H20)会失效,甚至带来性能劣化
听众收益
- 了解昇腾 950 的硬件特性,帮助其他模型的训练/推理部署亲和硬件,提供模型端到端性能
- 了解盘古模型在通信算子、并行策略方面的优化方面的实践,给其他模型的部署优化提供借鉴
by 莫梓峰
Inferact
vLLM committer如今开源大语言模型的迅速发展,随着 Kimi-K2.6、 Qwen3.6 及 cosmos3 等支持原生多模态的大语言模型发布,多模态大语言模型已成为未来发展趋势。
vLLM 作为主流开源推理框架之一,其针对多模态模型结构引发的性能瓶颈,进行了包括 Encoder cache、Encoder DP 及 Encoder Cuda Graph 在内的一系列性能优化,本演讲将深入讲解 vLLM 用于优化多模态模型的关键技术,并展示如何使用最新版本 vLLM 高效部署多模态模型。
演讲大纲
1. vLLM 的核心优化技术
- PagedAttention
- Continuous Batching
2. 多模态模型推理在 Continuous Batching 框架下面临的挑战
3. 针对多模态模型的多级缓存设计
- Encoder cache
- Processor Cache
4. 针对多模态模型 encoder 的优化
- ViT DP
- Encoder Cuda Graph
5. vLLM 的社区生态及其如何面对未来的多模态发展趋势
实践痛点
- 性能瓶颈在整个推理系统中的转移
- 开发人员人手严重匮乏
听众收益
- vLLM 的多项核心优化技术
- vLLM 的社区生态
by 尚旭春
TokenSpeed 独立贡献者
随着 AI Agent 从 Demo 逐步走向生产环境,LLM 推理负载正在发生根本性变化。相比传统聊天场景,Agentic 工作负载具有高并发、短请求、多轮工具调用、逐 Token 生成等特点,推理引擎的优化目标也从追求极限吞吐,转向在保证低延迟的同时实现更高的 GPU Token 输出效率。
与此同时,模型架构和硬件平台也在快速演进。以 DeepSeek、Kimi 等新一代模型为代表,MoE、MLA、异构并行逐渐成为主流;Blackwell 等新一代 GPU 又引入了 TMEM、tcgen05 等全新的计算能力。这意味着,仅依靠 Kernel 优化已经无法充分释放模型性能,推理 Runtime、调度系统、通信编译以及底层 Kernel 都需要进行系统性的协同设计。
本次分享将结合 TokenSpeed 的研发实践,从 Runtime 与 Kernel 两个层面介绍面向 Agentic 推理场景的新一代推理引擎设计。
演讲大纲
一、为什么 Agentic 推理需要新的推理引擎
1.1 Agentic 工作负载带来的新挑战
- Agent 与 Chat 的推理模式差异
- Token Throughput 与 User Latency 的重新平衡
- KV Cache 成为核心资源
1.2 模型与硬件复杂度同步提升
- MoE、MLA、异构并行成为主流
- Blackwell 带来的新硬件能力
- Runtime 与 Kernel 为什么必须协同设计
二、Runtime:构建可扩展的推理引擎架构
2.1 分层架构设计
- Control Plane
- Execution Plane
- Kernel Plane
2.2 自动并行编译
- Placement 类型系统
- Local-SPMD Compiler
- 自动生成通信
- Deferred Reduce 等优化
2.3 请求调度与资源管理
- C++ FSM 生命周期管理
- RAII 与类型安全
- KV Cache 生命周期
- Retraction 与 Prefix Cache
三、Kernel:让 MLA 真正跑满 GPU
- MLA Decode 的性能瓶颈
- Blackwell Kernel 优化
- Speculative Decoding 优化
- Prefill 优化
四、跨平台 Kernel 设计
- Registry + Selector:统一 API 如何支持多种硬件
- AMD GPU 实践:介绍 GPT-OSS 在 MI355X 上的 Kernel 适配经验,以及不同硬件如何共享同一套 Runtime
五、工程实践与性能收益
- Runtime 调度效率提升
- MLA Kernel 优化效果
- Speculative Decoding 加速
- 端到端推理性能提升
演讲痛点
- 架构抽象与性能优化
听众收益
- 理解 Agentic 推理场景与传统 LLM 推理在负载特征和优化目标上的核心差异
- 掌握面向 Agentic 场景的 Runtime 架构设计思路,包括分层架构、自动通信编译、请求生命周期管理以及 KV Cache 调度等关键技术
- 学习 Runtime 与 Kernel 协同优化的方法,以及跨平台 Kernel 抽象设计在异构算力环境中的工程实践
- 了解 TokenSpeed 在真实业务场景中的性能优化经验,为构建高性能、大规模 LLM 推理系统提供可借鉴的工程思路
by 杨雨豪
SGLang, RadixArk Engineer
DeepSeek V4 模型采用了由 SWA(滑窗注意力)、CSA(压缩稀疏注意力,4:1 压缩+TopK 筛选)和 HCA(高压缩注意力,128:1 压缩)组成的混合注意力架构,相较于 V3 单一的 MLA 结构更为复杂,同时模型支持百万级上下文长度,对推理框架的缓存管理、算子效率和并行策略提出了严苛挑战。
SGLang 通过全栈优化实现了对 DeepSeek V4 的 Day-0 支持。缓存层面,提出 ShadowRadix 机制,为三种注意力分别维护独立的 KV Cache 映射与页表,并通过 Tombstone 自动释放 SWA 过期缓存,配合 HiSparse 将溢出的 CSA KV Cache 卸载至 CPU 内存。算子层面,FlashCompressor 将 Compressor 流程的 HBM 读写次数从 5 次降至 2 次;Lightning TopK 利用 Cluster 内 SM 互联替代 HBM 通信完成归约,在百万上下文、Batch Size=1 场景下将 TopK 耗时从 100μs 降至 15μs。并行层面,支持 DP/TP/CP/EP 四种策略,其中 Context Parallelism 将长序列均匀分片至多卡,显著降低百万上下文下的首词时延;MegaMoE 将 dispatch、专家计算与 combine 融合为单一 kernel,进一步隐藏通信开销。投机采样方面,将元数据准备移入 CUDA Graph 并兼容重叠调度,4K 与 900K 上下文下的解码速度差异极小。
实测在 InferenceX 基准(Input 8K / Output 1K)上,开启 MTP 时单用户交互速度可达 180 token/s;GB300 NVL72 高吞吐场景下单 GPU 吞吐达 11500 token/s。
本次演讲我将分享 SGLang 团队如何通过缓存架构、算子融合和并行策略的全栈优化,实现 DeepSeek-V4 百万上下文推理的 Day-0 支持与持续性能提升,并结合 InferenceX 公开基准展示在 GB300 NVL72 上的实测结果。
演讲提纲
一、DeepSeek V4 推理的核心挑战
-
混合注意力架构的复杂性:SWA(滑窗 128)、CSA(4:1 压缩 + TopK 稀疏筛选)、HCA(128:1 纯压缩)三种异构 Attention 共存,每种有独立的 KV Cache 生命周期和索引逻辑
-
百万级上下文带来的内存与计算压力:KV Cache 显存占用激增,TopK 等索引操作在长序列下成为瓶颈
-
Compressor 机制引入跨 token 依赖:CSA/HCA 的 KV 计算需复用前序 token 中间状态,打破了传统逐 token 独立计算的假设
二、ShadowRadix:三套 KV Cache 的统一管理
-
在 RadixTree 上扩展虚拟地址表,每个 token 分配唯一虚拟位置,通过除法映射到三组 Shadow 页表(SWA 原始位置 / CSA 除以 4 / HCA 除以 128)
-
SWA 引入 Tombstone 机制,自动释放滑窗外过期 KV,Shadow B/C 无需淘汰
-
额外维护两个 Ring Buffer 管理 Compressor 中间状态,保证 CSA/HCA 跨 token 依赖的正确性
-
踩坑:三套 Cache 的页大小、淘汰策略、前缀匹配逻辑完全不同,SWA 为支持前缀缓存需保留多于 128 token 的 KV,不能简单按滑窗大小截断
三、算子级优化
-
FlashCompressor:将 Compressor 流程中 Softmax、bias、scale-dot 等零散操作融合为单一 kernel,HBM 读写从 5 次降至 2 次
-
Lightning TopK:序列分片到同一 Cluster 内的多个 CTA,各 CTA 用直方图做本地统计,通过 SM 互联(而非 HBM)完成 reduce;百万上下文 BS=1 下从 100μs 降至 15μs
-
MegaMoE(DeepSeek 官方):将 dispatch / group GEMM / combine 三阶段融合重叠为单一 kernel,直接调用 DeepGEMM 实现;限制:仅支持 FP8×FP4、仅 Blackwell SM100、仅 NVLink 互联
-
踩坑:Kernel 语言选型——Triton 开发快但优化上限有限,CUDA 可做极致优化但开发慢,TileLang 居中;FlashCompressor 用 Triton 即可,Lightning TopK 必须用 CUDA
四、并行策略与工程化
-
DP Attention:V3 延续方案,提升吞吐
-
CP(Context Parallelism):将长序列均匀分片到多卡,Attention 前 AllGather 所需 KV(因压缩后体积小,通信开销低);超长输入(90 万+)下 CP 优于 TP,短输入 TP 更优(CP 额外通信开销不划算)
-
EP(Expert Parallelism):GB300 NVL72 上大规模专家并行,AlltoAll 走 NVLink 带宽充足
-
多流并行:SWA/CSA/HCA 三种 Attention 无数据依赖,分配到不同 CUDA Stream;解码阶段 SM 利用率未饱和,多流收益明显;用 CUDA Event 控制依赖顺序
-
踩坑:FlashMLA 库专为 DP Attention 设计(头数完整),开启 TP 切分头数后只能 padding 到要求的头数,存在浪费,后续仍需优化;CP 的 KV AllGather 目前无法做 overlap(前后有数据依赖),计划用 Ring Attention 方案解决
五、投机采样适配
-
V4 MTP Layer 仅含 SWA,无 CSA/HCA,结构比主模型轻量
-
将 KV 位置等元数据准备移入 CUDA Graph,消除 CPU 开销;兼容 Overlap Scheduling 实现 CPU/GPU 完全并行
-
实测 4K 与 900K 上下文解码速度差异极小(TP=8, BS=1, MTP Len=3)
-
踩坑:大 Batch(512/1024)下投机采样收益下降,因 GPU 瓶颈从访存转为计算,投机采样本质优化的是访存
六、KV Cache Offloading 与 PD 分离
-
HiSparse:CSA pool 溢出时卸载至 CPU 内存,SWA/HCA 体积小暂留 GPU
-
PD 分离结合 ShadowRadix 虚拟索引,KV Cache 按配置从 P 节点传输至 D 节点
七、性能数据
-
InferenceX 基准(Input 8K / Output 1K):开启 MTP 单用户交互速度 180 token/s;GB300 NVL72 高吞吐场景单 GPU 吞吐 11,500 token/s
-
强化学习框架 Miles Day-0 支持:Rollout 阶段用 FP8、Training 用 BF16 混合精度,奖励值与 benchmark 分数随训练步数稳步提升
实践痛点
1. 架构复杂度换性能
ShadowRadix 为三种 Attention 各维护一套独立的页表、淘汰策略和前缀匹配逻辑,系统复杂度相比 V3 单一 MLA 大幅膨胀。例如 SWA 为支持前缀缓存必须保留多于 128 token 的 KV,不能按滑窗大小简单截断,即使是最基础的缓存管理也充满 corner case。三套 Cache 的联调、一致性维护和 bug 排查成本很高,后续每新增一个功能(如 PD 分离、CP)都要在三套系统上分别适配。
2. 并行策略没有通解
CP 在超长输入下优于 TP,但 AllGather 目前无法做 overlap(有数据依赖),且长上下文高并发容易 OOM;TP 在短输入下更好但受限于卡间通信;EP 依赖 NVLink 带宽。本质上不存在自动化策略选择,用户需要自己在 DP/TP/CP/EP 的组合空间里反复试参,调优成本不低。运行时动态切换并行策略也不可行,涉及 CUDA Graph 重建、元数据重建等问题。
3. Kernel 开发的工程代价
实际开发中 Triton、CUDA、TileLang 三种语言混用:Triton 开发快但优化上限有限,CUDA 能做极致优化但开发慢,TileLang 居中。Lightning TopK 必须用 CUDA,FlashCompressor 用 Triton,训练反向算子用 TileLang。三套工具链混合意味着团队需要同时维护三种代码风格和调试流程,且融合 kernel 一旦出现数值精度问题,排查难度远高于朴素 PyTorch 实现。
听众收益
- 复杂模型架构落地的工程方法论:DeepSeek V4 的三种异构 Attention 共存是业界新趋势,ShadowRadix 的虚拟地址映射 + 分层页表设计提供了一套可复用的思路——当模型架构变复杂时,如何在不重写整个缓存系统的前提下做扩展式适配,而非推倒重来。
- 性能优化的决策框架:分享覆盖了从算子融合(FlashCompressor 减少 HBM 读写)、到并行策略选型(短输入用 TP、超长输入用 CP、高吞吐用 EP)、再到投机采样适用边界(小 Batch 有效、大 Batch 收益下降)的完整决策链路,帮助参会者在自身业务场景中快速定位优化方向,避免盲目套用单一方案。
- 多硬件适配的实战经验:Kernel 语言选型(Triton 快速迭代 vs CUDA 极致优化 vs TileLang 折中)、MegaMoE 的硬件约束(仅 Blackwell + NVLink)、FlashMLA 在 TP 下的 padding 浪费等具体案例,为正在做跨平台部署或硬件选型的团队提供真实的 tradeoff 参考,减少试错成本。
关注主办方(InfoQ)
联系我们
交通指南
深圳湾万丽酒店
Shenzhen Bay Marriott Hotel
地址:深圳南山区粤海街道高新区社区科技南路18号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手