中山大学博士,在华为长期从事通信协议的研究工作,研究方向覆盖数据中心网络、广域网络、终端无线网络。当前聚焦优化盘古模型训练/推理的通信性能,主导盘古模型在昇腾 950 上的通信算子性能优化。
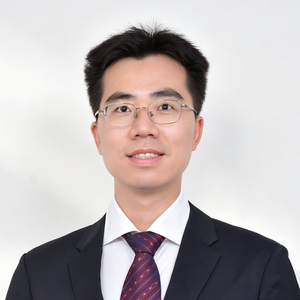
专题演讲嘉宾:李柏潮 博士
华为2012 实验室 大模型系统工程技术专家
by 李柏潮 博士
华为
2012 实验室 大模型系统工程技术专家通信开销是大模型训练和推理中不可忽视的性能瓶颈。在 MoE 模型中,AllToAll 通信占总端到端时间的 30% 以上,是一直以来的优化重点;而 1M 超长上下文场景下,Host to Device 的 KV Cache 传输延迟已成为推理 TTFT 的新“拦路虎”。深度亲和昇腾硬件进行通信优化,才能最大化将昇腾算力潜能转化为模型训练/推理性能提升。
本次分享围绕昇腾平台的两类通信优化展开。第一部分聚焦 MoE 场景下的 AllToAll,通过适配昇腾 950 的网络拓扑和 CCU 通信加速器,在盘古模型的 EP 通信域 AllToAll 上实现了 10% 以上的性能提升。第二部分关注超长序列推理中的 KV Cache 卸载,通过 Omni Cache 高效的 H2D 和 D2H 通信,实现 TTFT 提升 10 %以上。更进一步,我们将展望如何通过昇腾亲和实现最优的通算掩盖,使得通信不再成为暴露在训练/推理端到端时延中的短板。
希望本次分享能为业界其他模型在昇腾平台上优化通信性能提供借鉴,共同繁荣昇腾软件硬件生态。
演讲提纲
1. 大模型的训练/推理在通信方面面临哪些技术挑战?
- MoE 阶段的 AllToAll 通信是长期以来的关键瓶颈
- 在超长上下文场景,H2D 通信成为推理场景新出现的性能瓶颈
2. 亲和昇腾硬件,加速 EP 域的 AllToAll
- 拓扑亲和案例:DeepEP 方案不适用于昇腾 910A3
- 算力亲和案例:发挥昇腾 950 专门通信加速引擎 CCU 的最大效用
- 模型亲和案例:使用自定义通信算子实现灵活的集合通信新语义
3. 硬件软件双管齐下,加速 H2D(Host to Device)的通信交互
- 硬件优化:昇腾 950 为每个 NPU 提供专用的 H2D 通路
- 软件优化:Omni Cache 实现高效 KV cache 卸载
4. 总结和展望
- 优化抓手:尽量减少未被掩盖的通信时间
- 进一步优化:亲和昇腾硬件实现融合算子/多流并行的流水编排
实践痛点
- 针对昇腾 950 硬件平台进行通信优化,牺牲普适性,换取性能提升
- 同样的策略用到其他平台上(例如昇腾910A2/A3,NVIDIA H20)会失效,甚至带来性能劣化
听众收益
- 了解昇腾 950 的硬件特性,帮助其他模型的训练/推理部署亲和硬件,提供模型端到端性能
- 了解盘古模型在通信算子、并行策略方面的优化方面的实践,给其他模型的部署优化提供借鉴
关注主办方(InfoQ)


联系我们
交通指南
深圳湾万丽酒店
Shenzhen Bay Marriott Hotel
地址:深圳南山区粤海街道高新区社区科技南路18号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手