SGLang core contributor, RadixArk inference optimization engineer。
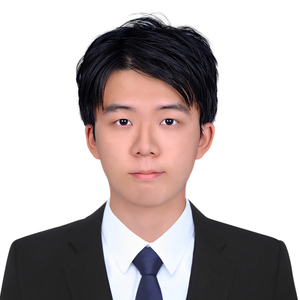
专题演讲嘉宾:杨雨豪
SGLang, RadixArk Engineer
by 杨雨豪
SGLang, RadixArk Engineer
DeepSeek V4 模型采用了由 SWA(滑窗注意力)、CSA(压缩稀疏注意力,4:1 压缩+TopK 筛选)和 HCA(高压缩注意力,128:1 压缩)组成的混合注意力架构,相较于 V3 单一的 MLA 结构更为复杂,同时模型支持百万级上下文长度,对推理框架的缓存管理、算子效率和并行策略提出了严苛挑战。
SGLang 通过全栈优化实现了对 DeepSeek V4 的 Day-0 支持。缓存层面,提出 ShadowRadix 机制,为三种注意力分别维护独立的 KV Cache 映射与页表,并通过 Tombstone 自动释放 SWA 过期缓存,配合 HiSparse 将溢出的 CSA KV Cache 卸载至 CPU 内存。算子层面,FlashCompressor 将 Compressor 流程的 HBM 读写次数从 5 次降至 2 次;Lightning TopK 利用 Cluster 内 SM 互联替代 HBM 通信完成归约,在百万上下文、Batch Size=1 场景下将 TopK 耗时从 100μs 降至 15μs。并行层面,支持 DP/TP/CP/EP 四种策略,其中 Context Parallelism 将长序列均匀分片至多卡,显著降低百万上下文下的首词时延;MegaMoE 将 dispatch、专家计算与 combine 融合为单一 kernel,进一步隐藏通信开销。投机采样方面,将元数据准备移入 CUDA Graph 并兼容重叠调度,4K 与 900K 上下文下的解码速度差异极小。
实测在 InferenceX 基准(Input 8K / Output 1K)上,开启 MTP 时单用户交互速度可达 180 token/s;GB300 NVL72 高吞吐场景下单 GPU 吞吐达 11500 token/s。
本次演讲我将分享 SGLang 团队如何通过缓存架构、算子融合和并行策略的全栈优化,实现 DeepSeek-V4 百万上下文推理的 Day-0 支持与持续性能提升,并结合 InferenceX 公开基准展示在 GB300 NVL72 上的实测结果。
演讲提纲
一、DeepSeek V4 推理的核心挑战
-
混合注意力架构的复杂性:SWA(滑窗 128)、CSA(4:1 压缩 + TopK 稀疏筛选)、HCA(128:1 纯压缩)三种异构 Attention 共存,每种有独立的 KV Cache 生命周期和索引逻辑
-
百万级上下文带来的内存与计算压力:KV Cache 显存占用激增,TopK 等索引操作在长序列下成为瓶颈
-
Compressor 机制引入跨 token 依赖:CSA/HCA 的 KV 计算需复用前序 token 中间状态,打破了传统逐 token 独立计算的假设
二、ShadowRadix:三套 KV Cache 的统一管理
-
在 RadixTree 上扩展虚拟地址表,每个 token 分配唯一虚拟位置,通过除法映射到三组 Shadow 页表(SWA 原始位置 / CSA 除以 4 / HCA 除以 128)
-
SWA 引入 Tombstone 机制,自动释放滑窗外过期 KV,Shadow B/C 无需淘汰
-
额外维护两个 Ring Buffer 管理 Compressor 中间状态,保证 CSA/HCA 跨 token 依赖的正确性
-
踩坑:三套 Cache 的页大小、淘汰策略、前缀匹配逻辑完全不同,SWA 为支持前缀缓存需保留多于 128 token 的 KV,不能简单按滑窗大小截断
三、算子级优化
-
FlashCompressor:将 Compressor 流程中 Softmax、bias、scale-dot 等零散操作融合为单一 kernel,HBM 读写从 5 次降至 2 次
-
Lightning TopK:序列分片到同一 Cluster 内的多个 CTA,各 CTA 用直方图做本地统计,通过 SM 互联(而非 HBM)完成 reduce;百万上下文 BS=1 下从 100μs 降至 15μs
-
MegaMoE(DeepSeek 官方):将 dispatch / group GEMM / combine 三阶段融合重叠为单一 kernel,直接调用 DeepGEMM 实现;限制:仅支持 FP8×FP4、仅 Blackwell SM100、仅 NVLink 互联
-
踩坑:Kernel 语言选型——Triton 开发快但优化上限有限,CUDA 可做极致优化但开发慢,TileLang 居中;FlashCompressor 用 Triton 即可,Lightning TopK 必须用 CUDA
四、并行策略与工程化
-
DP Attention:V3 延续方案,提升吞吐
-
CP(Context Parallelism):将长序列均匀分片到多卡,Attention 前 AllGather 所需 KV(因压缩后体积小,通信开销低);超长输入(90 万+)下 CP 优于 TP,短输入 TP 更优(CP 额外通信开销不划算)
-
EP(Expert Parallelism):GB300 NVL72 上大规模专家并行,AlltoAll 走 NVLink 带宽充足
-
多流并行:SWA/CSA/HCA 三种 Attention 无数据依赖,分配到不同 CUDA Stream;解码阶段 SM 利用率未饱和,多流收益明显;用 CUDA Event 控制依赖顺序
-
踩坑:FlashMLA 库专为 DP Attention 设计(头数完整),开启 TP 切分头数后只能 padding 到要求的头数,存在浪费,后续仍需优化;CP 的 KV AllGather 目前无法做 overlap(前后有数据依赖),计划用 Ring Attention 方案解决
五、投机采样适配
-
V4 MTP Layer 仅含 SWA,无 CSA/HCA,结构比主模型轻量
-
将 KV 位置等元数据准备移入 CUDA Graph,消除 CPU 开销;兼容 Overlap Scheduling 实现 CPU/GPU 完全并行
-
实测 4K 与 900K 上下文解码速度差异极小(TP=8, BS=1, MTP Len=3)
-
踩坑:大 Batch(512/1024)下投机采样收益下降,因 GPU 瓶颈从访存转为计算,投机采样本质优化的是访存
六、KV Cache Offloading 与 PD 分离
-
HiSparse:CSA pool 溢出时卸载至 CPU 内存,SWA/HCA 体积小暂留 GPU
-
PD 分离结合 ShadowRadix 虚拟索引,KV Cache 按配置从 P 节点传输至 D 节点
七、性能数据
-
InferenceX 基准(Input 8K / Output 1K):开启 MTP 单用户交互速度 180 token/s;GB300 NVL72 高吞吐场景单 GPU 吞吐 11,500 token/s
-
强化学习框架 Miles Day-0 支持:Rollout 阶段用 FP8、Training 用 BF16 混合精度,奖励值与 benchmark 分数随训练步数稳步提升
实践痛点
1. 架构复杂度换性能
ShadowRadix 为三种 Attention 各维护一套独立的页表、淘汰策略和前缀匹配逻辑,系统复杂度相比 V3 单一 MLA 大幅膨胀。例如 SWA 为支持前缀缓存必须保留多于 128 token 的 KV,不能按滑窗大小简单截断,即使是最基础的缓存管理也充满 corner case。三套 Cache 的联调、一致性维护和 bug 排查成本很高,后续每新增一个功能(如 PD 分离、CP)都要在三套系统上分别适配。
2. 并行策略没有通解
CP 在超长输入下优于 TP,但 AllGather 目前无法做 overlap(有数据依赖),且长上下文高并发容易 OOM;TP 在短输入下更好但受限于卡间通信;EP 依赖 NVLink 带宽。本质上不存在自动化策略选择,用户需要自己在 DP/TP/CP/EP 的组合空间里反复试参,调优成本不低。运行时动态切换并行策略也不可行,涉及 CUDA Graph 重建、元数据重建等问题。
3. Kernel 开发的工程代价
实际开发中 Triton、CUDA、TileLang 三种语言混用:Triton 开发快但优化上限有限,CUDA 能做极致优化但开发慢,TileLang 居中。Lightning TopK 必须用 CUDA,FlashCompressor 用 Triton,训练反向算子用 TileLang。三套工具链混合意味着团队需要同时维护三种代码风格和调试流程,且融合 kernel 一旦出现数值精度问题,排查难度远高于朴素 PyTorch 实现。
听众收益
- 复杂模型架构落地的工程方法论:DeepSeek V4 的三种异构 Attention 共存是业界新趋势,ShadowRadix 的虚拟地址映射 + 分层页表设计提供了一套可复用的思路——当模型架构变复杂时,如何在不重写整个缓存系统的前提下做扩展式适配,而非推倒重来。
- 性能优化的决策框架:分享覆盖了从算子融合(FlashCompressor 减少 HBM 读写)、到并行策略选型(短输入用 TP、超长输入用 CP、高吞吐用 EP)、再到投机采样适用边界(小 Batch 有效、大 Batch 收益下降)的完整决策链路,帮助参会者在自身业务场景中快速定位优化方向,避免盲目套用单一方案。
- 多硬件适配的实战经验:Kernel 语言选型(Triton 快速迭代 vs CUDA 极致优化 vs TileLang 折中)、MegaMoE 的硬件约束(仅 Blackwell + NVLink)、FlashMLA 在 TP 下的 padding 浪费等具体案例,为正在做跨平台部署或硬件选型的团队提供真实的 tradeoff 参考,减少试错成本。
关注主办方(InfoQ)


联系我们
交通指南
深圳湾万丽酒店
Shenzhen Bay Marriott Hotel
地址:深圳南山区粤海街道高新区社区科技南路18号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手