长期专注在大模型(LLM)软件栈在新硬件环境下的适配、性能调优与架构优化工作。在深耕工业界核心算力基础设施的同时,深度参与并活跃于顶尖的大模型开源基础设施(Infra)社区。作为 Mooncake 社区的 Maintainer,负责维护核心组件 Mooncake Store,该项目目前在 GitHub 上已获得超过 4k star;作为 SGLang 社区的 Committer,贡献了PD分离、流水线(PP)并行以及 HiCache 等多个提升长文本与高并发推理性能的核心特性;同时也是 TokenSpeed 社区的 Maintainer,负责 PD 分离、EPLB(弹性流水线负载均衡)以及 KVStore 等多个高吞吐核心子模块的架构与研发工作。
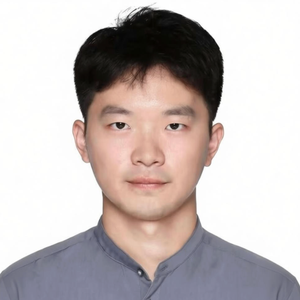
专题演讲嘉宾:尚旭春
TokenSpeed 独立贡献者
by 尚旭春
TokenSpeed 独立贡献者
随着 AI Agent 从 Demo 逐步走向生产环境,LLM 推理负载正在发生根本性变化。相比传统聊天场景,Agentic 工作负载具有高并发、短请求、多轮工具调用、逐 Token 生成等特点,推理引擎的优化目标也从追求极限吞吐,转向在保证低延迟的同时实现更高的 GPU Token 输出效率。
与此同时,模型架构和硬件平台也在快速演进。以 DeepSeek、Kimi 等新一代模型为代表,MoE、MLA、异构并行逐渐成为主流;Blackwell 等新一代 GPU 又引入了 TMEM、tcgen05 等全新的计算能力。这意味着,仅依靠 Kernel 优化已经无法充分释放模型性能,推理 Runtime、调度系统、通信编译以及底层 Kernel 都需要进行系统性的协同设计。
本次分享将结合 TokenSpeed 的研发实践,从 Runtime 与 Kernel 两个层面介绍面向 Agentic 推理场景的新一代推理引擎设计。
演讲大纲
一、为什么 Agentic 推理需要新的推理引擎
1.1 Agentic 工作负载带来的新挑战
- Agent 与 Chat 的推理模式差异
- Token Throughput 与 User Latency 的重新平衡
- KV Cache 成为核心资源
1.2 模型与硬件复杂度同步提升
- MoE、MLA、异构并行成为主流
- Blackwell 带来的新硬件能力
- Runtime 与 Kernel 为什么必须协同设计
二、Runtime:构建可扩展的推理引擎架构
2.1 分层架构设计
- Control Plane
- Execution Plane
- Kernel Plane
2.2 自动并行编译
- Placement 类型系统
- Local-SPMD Compiler
- 自动生成通信
- Deferred Reduce 等优化
2.3 请求调度与资源管理
- C++ FSM 生命周期管理
- RAII 与类型安全
- KV Cache 生命周期
- Retraction 与 Prefix Cache
三、Kernel:让 MLA 真正跑满 GPU
- MLA Decode 的性能瓶颈
- Blackwell Kernel 优化
- Speculative Decoding 优化
- Prefill 优化
四、跨平台 Kernel 设计
- Registry + Selector:统一 API 如何支持多种硬件
- AMD GPU 实践:介绍 GPT-OSS 在 MI355X 上的 Kernel 适配经验,以及不同硬件如何共享同一套 Runtime
五、工程实践与性能收益
- Runtime 调度效率提升
- MLA Kernel 优化效果
- Speculative Decoding 加速
- 端到端推理性能提升
演讲痛点
- 架构抽象与性能优化
听众收益
- 理解 Agentic 推理场景与传统 LLM 推理在负载特征和优化目标上的核心差异
- 掌握面向 Agentic 场景的 Runtime 架构设计思路,包括分层架构、自动通信编译、请求生命周期管理以及 KV Cache 调度等关键技术
- 学习 Runtime 与 Kernel 协同优化的方法,以及跨平台 Kernel 抽象设计在异构算力环境中的工程实践
- 了解 TokenSpeed 在真实业务场景中的性能优化经验,为构建高性能、大规模 LLM 推理系统提供可借鉴的工程思路
关注主办方(InfoQ)


联系我们
交通指南
深圳湾万丽酒店
Shenzhen Bay Marriott Hotel
地址:深圳南山区粤海街道高新区社区科技南路18号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手