莫梓峰,硕士毕业于中山大学,现就职于 Inferact。
作为 vLLM 多模态部分的几位核心开发者之一,深度参与了vLLM多模态模型的支持与优化特性维护。截至 2026 年 6 月,vLLM 已在 GitHub 上获得 82k star,并被广泛应用于 AWS、Meta、Digital Ocean 等大型厂商的生产环境中。
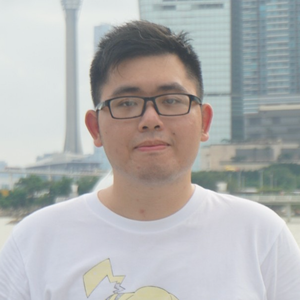
莫梓峰,硕士毕业于中山大学,现就职于 Inferact。
作为 vLLM 多模态部分的几位核心开发者之一,深度参与了vLLM多模态模型的支持与优化特性维护。截至 2026 年 6 月,vLLM 已在 GitHub 上获得 82k star,并被广泛应用于 AWS、Meta、Digital Ocean 等大型厂商的生产环境中。
如今开源大语言模型的迅速发展,随着 Kimi-K2.6、 Qwen3.6 及 cosmos3 等支持原生多模态的大语言模型发布,多模态大语言模型已成为未来发展趋势。
vLLM 作为主流开源推理框架之一,其针对多模态模型结构引发的性能瓶颈,进行了包括 Encoder cache、Encoder DP 及 Encoder Cuda Graph 在内的一系列性能优化,本演讲将深入讲解 vLLM 用于优化多模态模型的关键技术,并展示如何使用最新版本 vLLM 高效部署多模态模型。
演讲大纲
1. vLLM 的核心优化技术
2. 多模态模型推理在 Continuous Batching 框架下面临的挑战
3. 针对多模态模型的多级缓存设计
4. 针对多模态模型 encoder 的优化
5. vLLM 的社区生态及其如何面对未来的多模态发展趋势
实践痛点
听众收益




 京公网安备 11010502039052号 | 产品资质


微信咨询

电话咨询

微信联系我们