范式智能(原名第四范式)工程师,系统研发专家。在范式一直关注在 AI Infra 这个方向上,作为主要的负责人之一,参与范式的 GPU 集群的建设。目前是 HAMi 社区的 maintainer 之一,主要的贡献集中于 HAMi 调度器的性能优化和 HAMi-DRA 上,并且参与 HAMi 社区的维护工作。
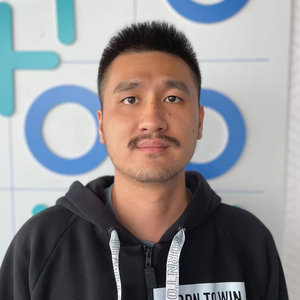
专题演讲嘉宾:杨守仁
范式智能系统研发专家
by 杨守仁
范式智能
系统研发专家随着国产算力的发展,算力集群的从单一的 NVIDIA 设备逐步走向有更多不同国产厂商设备构成的异构算力集群,异构算力的管理这个问题逐步浮出水面。HAMi 作为范式参与发起的项目,是范式在异构算力管理上的实践的成果。HAMi 在易用性和管理能力上取得了一个较好的平衡,但是受限于 Kubernetes 的 Device Plugin 本身的缺陷,调度性能和精细化分配的能力面临瓶颈。但是随着 Kubernetes v1.34 将 Dynamic Resource Allocation(DRA) 特性正式推进至 GA,集群设备资源管理从以节点为中心的分配模型,逐步演进为以资源对象为核心的声明式管理模式,相比传统 Device Plugin 接口仅能暴露简单容量信息,DRA 通过引入 ResourceClaim 使设备资源能够在 Pod 创建之前完成表达与约束,为 GPU 等复杂硬件资源的精细化调度提供了新的基础能力。
HAMi-DRA 是 HAMi 社区在 DRA 方向上的最新实践,结合范式自身的异构算力管理实践,HAMi-DRA 能在不牺牲核心调度能力的前提下,将现有 GPU 虚拟化调度体系平滑迁移至 DRA 资源模型。从范式的实践结果来看 HAMi-DRA 在调度性能和精细化管理方面带来了显著的提升。
本次分享将从 Kubernetes 设备资源模型演进的视角出发,向大家介绍范式以及 HAMi 社区在异构设备管理的面临的挑战和实践,同时详细解析 HAMi-DRA 的整体架构设计与关键实现细节,展示如何基于 DRA 构建面向 AI 工作负载的可扩展 GPU 调度方案,并且综合说明在落地 HAMi-DRA 的过程中范式以及社区遇到的挑战。
演讲提纲
1. 背景和动机
- 异构设备管理的挑战
- 传统 Device Plugin 的局限性
2. HAMi 的如何解题
- HAMi 设计思路和关键实现
- HAMi 的问题和挑战
3. Kubernetes DRA 介绍
- DRA API
- Consumable Capacity 特性
4. HAMi-DRA 设计和实践
- 整体架构和设计理念
- HAMi-DRA 的落地挑战
- Kubernetes 版本
- 学习成本
- 有限的设备支持
- 基于 HAMi-DRA 的 GPU 调度方案
- 调度性能提升
- 完善的设备生命周期管理
- 差异化的设备资源分配
5. 总结和展望
- HAMi-DRA 后续规划
- 多个 DRA Driver 联动支持
实践痛点
- 依赖高版本的 Kubernetes,生产环境推动困难
- DRA API 还在持续演进,部分特性还不是特性稳定,有一定的集成成本
- 开箱即用的 DRA Driver 数量较少,支持的异构设备的数量有限
听众收益
- 详细解析异构算力管理上的挑战
- 深度拆解 HAMi 和 HAMi-DRA 的设计和关键实现
- 完整介绍基于 DRA 的 GPU 调度方案的挑战和实践
关注主办方(InfoQ)


联系我们
交通指南
深圳湾万丽酒店
Shenzhen Bay Marriott Hotel
地址:深圳南山区粤海街道高新区社区科技南路18号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手