探讨多模态模型在实际应用中的最新实践与创新,涵盖多模态理解与生成技术的前沿进展。... 展开 >
多模态实践与应用
会议室:203出品人:张磊
- Topic 1
DUANGE
腾讯 视觉大模型中心Tech Lead - Topic 2
唐家声
阿里巴巴达摩院 高级算法专家 - Topic 3
潘滢炜
智象未来 算法科学家 - Topic 4
韩剑
字节跳动 AIGC 算法工程师
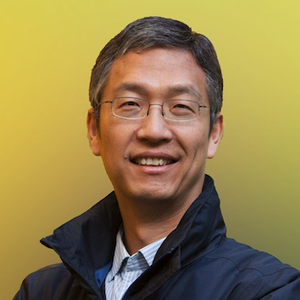
专题出品人:张磊
IDEA 研究院计算机视觉与机器人研究中心讲席科学家
张磊博士任 IDEA 研究院计算机视觉与机器人研究中心讲席科学家、IEEE Fellow,曾任微软亚洲研究院、微软总部研究院首席研究员,长期带领研究组从事计算机视觉基础研究和大规模图像分析、物体检测、视觉语言多模态理解的应用研究,其研究成果广泛用于微软必应搜索及认知服务云计算平台。他于2021年加入IDEA研究院并创立计算机视觉与机器人研究中心,在物体检测方向做出一系列研究工作,其中DINO算法首次奠定了DETR类算法在物体检测领域的SOTA地位,Grounding DINO及后续的DINO-X等工作成为视觉领域性能最好的开集物体检测模型。他在计算机视觉等相关领域发表论 150 多篇,并拥有 60 多项美国授权专利。
地点:203
专题:多模态实践与应用
探讨多模态模型在实际应用中的最新实践与创新,涵盖多模态理解与生成技术的前沿进展。此外,也关注RAG在多模态场景下的应用,比如跨模态搜索、智能问答、个性化推荐等。
by DUANGE
腾讯
视觉大模型中心Tech Lead本次分享将基于混元多模态基础大模型,深入探讨腾讯在多模态技术领域的最新研发进展。混元多模态大模型技术覆盖文本、图像、视频和音频理解与生成多种技术。特别值得一提的是,图像到文本模型包含三个关键组件:视觉变换器(ViT)用于视觉编码、视觉-语言适配器,以及采用专家混合(MoE)架构的大型语言模型。团队高度重视数据质量和多样性,开发了一套高效的自动化数据处理管道。选择MoE架构得益于其在性能和可扩展性方面的卓越表现。通过分阶段训练和推理优化技术,模型的能力得到了进一步加强。为确保模型满足用户需求,团队在强化学习中对偏好进行了对齐,并采用真实用户的A/B测试。目前,该模型已在司内多个业务场景中部署应用。展望未来,计划扩展模型能力,覆盖更多模态,并进一步提升智能性和可靠性。
演讲提纲
- 混元多模态模型发展概况
- 模型架构:视觉变换器(ViT)、视觉-语言适配器、专家混合(MoE)架构
- 支持的模态:文本、图像、视频、音频
- 关键技术特点与创新点
- 混元多模态模型技术实践与挑战
- 数据处理:高效的自动化数据处理管道
- 训练优化:分阶段训练与推理优化技术
- 用户反馈机制:强化学习对偏好对齐、A/B测试
- 面临的技术挑战与解决方案
- 混元多模态模型应用探索
- 图像与文本理解提升推荐系统准确性
- 多模态内容的自动生成与审核
- 其他业务场景中的应用实例
- 未来展望
- 模型能力的扩展方向
- 提升智能性与可靠性的策略
您认为,这样的技术在实践过程中有哪些痛点?
- 模型输出暂未达到绝对的准确,例如存在幻觉等问题。
您的演讲有哪些前沿亮点?
- 介绍大模型实践的经验与思考。
听众收益
- 了解多模态大模型的实验经验
- 了解在实际业务中的应用场景
by 唐家声
阿里巴巴达摩院
高级算法专家以扩散模型为代表的多模态模型在近两年成为生成领域的基础模型,也使得文生图、文生视频等真正走入 C 端用户,推动澎湃的 AIGC 社区形成。但是随着模型的 Scale 越来越大,模型推理时间过长、显存占用过高仍旧是难以忍受的问题,以 Flux 和 Wan2.1 为例。但是过去在模型架构上的剪枝等手段不够适配扩散模型的特性,在此背景下,达摩院从算法设计与系统优化等不同的角度构建了多维度的扩散模型加速的方法,包括动态计算的DyDiT、引入强化学习的联合动态范式RAPID、FP8与稀疏化的联合感知优化的FPSAttention。面向未来,结合高效算法设计与系统优化的极致加速,将使得视频边播放边生成,用户不再感知延迟!
演讲提纲
- 问题背景
- 扩散模型的演进与多模态生成的效率挑战
- 解构效率问题——算法设计与系统优化
- 算法设计
- 动态化思想加速DiT——DyDiT
- 多维度动态计算联合「强化」——RAPID3
- 系统优化
- FP8 & 稀疏化的联合感知训练——FPS Attention
- 总结与展望
听众收益
- 了解生成效率问题的技术挑战
- 了解达摩院在这一方向的思考与 best practice
演讲亮点
基于团队 ICLR-2025 的最新工作 DyDiT 及其演进工作,讲述扩散模型推理加速的一个重要方向。
by 潘滢炜
智象未来
算法科学家在人工智能的浪潮中,多模态内容生成技术正成为创意产业的全新引擎。它融合文本、图像、音频、视频等多种模态,打破单一模态的限制,为内容创作带来前所未有的灵活性和丰富性。本次演讲将深入探讨国际上最近几年多模态内容生成的核心技术突破,包含扩散模型UNet结构到Diffusion Transformer(DiT)架构的演进,智象未来自主研发的智象多模态大模型在图像和视频生成能力上的技术升级,以及如何突破用户最后一公里。同时,还将分享多模态生成技术在设计、营销、影视、文旅等领域的创新应用案例,揭示多模态内容生成如何赋能相关产业,推动内容创作的智能化和创意的个性化发展。
演讲提纲
- 大模型发展和竞争态势
- 多模态AIGC市场空间
- 多模态生成模型技术演进:扩散模型UNet结构、Diffusion Transformer(DiT)架构、智象多模态大模型的扩散自回归模型(DiT+AR)
- 多模态生成技术在相关领域的创新应用
- 展望和未来
技术实践痛点
不需要等到多模态基础模型达到 100 分才去做应用。在现有的基础模型能力之上,如果能找到真正解决用户痛点的场景,并在应用上做得很深,真正做到端到端的 95 分以上,用户就会买单。这就需要我们去对多模态基础模型做很多场景驱动的优化,特别关注基础模型在上层应用中的表现,去解决用户「最后一公里」的问题。
听众收益
- 最新的多模态内容生成技术前沿动态
- 智象未来自主研发的智象多模态大模型技术升级
- 多模态内容生成技术如何赋能相关产业
by 韩剑
字节跳动
AIGC 算法工程师以 ChatGPT、DeepSeek 为代表的大语言模型(LLM)取得了巨大的成功,掀起了全球新一轮 AI 浪潮。但是在视觉生成领域,目前主流的方法却是一直以扩散模型为主导。与大语言模型采取相同技术路线的视觉自回归方法因为具有更好的scaling特性,能够统一理解&生成任务,隐藏着巨大的潜力,正受到人们越来越多的重视。
本次演讲中,我将以被选为 CVPR 2025 Oral 的工作 Infinity 为例,详细介绍自回归视觉生成的底层技术原理。并以图像生成和视频生成两个具体场景,分享最新的研究成果和相关思考。
演讲提纲
- 自回归模型和Scaling Law
- 视觉自回归 v.s. 扩散模型
- Infinity:视觉自回归生成新路线
- 离散 Visual Tokenizer
- Bitwise AutoRegressive Modeling
- 图像生成实践
- 视频生成实践
- 分析和思考
您认为,这样的技术在实践过程中有哪些痛点?
目前看以 Infinity 为代表的视觉自回归模型在视频生成任务上相比 SOTA 的扩散模型生成速度具有明显优势,但是效果上还有一些差距。
您的演讲有哪些前沿亮点?
这是一个非常详尽的视觉自回归技术分享,通过这次分享,读者可以深入了解到视觉自回归的底层技术实现、目前达到的效果水位,以及未来可能的研究方向。
听众收益
- 视觉自回归的技术原理、实现方法、目前达到的生成效果
- 视觉自回归技术的优缺点以及未来的发展方向
- 如何基于视觉自回归构建图像/视频生成模型
关注主办方(InfoQ)
联系我们
交通指南
北京国际会议中心
Beijing International Convention Center
地址:北京市朝阳区北辰东路8号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手