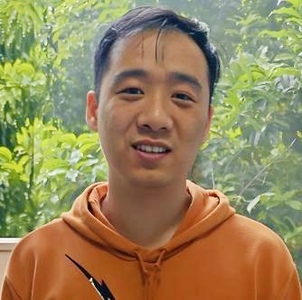
在阿里巴巴达摩院长期从事机器学习与计算机视觉领域的研究与应用,在视觉表征学习、目标跟踪与系统、分布式训练与高效推理等方向有丰富的项目与科研经历。多次获得 CVPR/ICCV/ECCV 上的多目标跟踪顶级竞赛冠军和 MOTChallenge 排行榜第一名。目前负责达摩院视觉技术实验室的 EfficientAIGC 方向,专注于视觉生成模型的高效分布式训练、高效微调与推理的算法系统联合优化等问题。
讲师介绍
议题介绍
地点:203
所属专题:多模态实践与应用
演讲:实现多模态生成“极致”加速的算法与系统挑战
以扩散模型为代表的多模态模型在近两年成为生成领域的基础模型,也使得文生图、文生视频等真正走入 C 端用户,推动澎湃的 AIGC 社区形成。但是随着模型的 Scale 越来越大,模型推理时间过长、显存占用过高仍旧是难以忍受的问题,以 Flux 和 Wan2.1 为例。但是过去在模型架构上的剪枝等手段不够适配扩散模型的特性,在此背景下,达摩院从算法设计与系统优化等不同的角度构建了多维度的扩散模型加速的方法,包括动态计算的DyDiT、引入强化学习的联合动态范式RAPID、FP8与稀疏化的联合感知优化的FPSAttention。面向未来,结合高效算法设计与系统优化的极致加速,将使得视频边播放边生成,用户不再感知延迟!
演讲提纲
- 问题背景
- 扩散模型的演进与多模态生成的效率挑战
- 解构效率问题——算法设计与系统优化
- 算法设计
- 动态化思想加速DiT——DyDiT
- 多维度动态计算联合「强化」——RAPID3
- 系统优化
- FP8 & 稀疏化的联合感知训练——FPS Attention
- 总结与展望
听众收益
- 了解生成效率问题的技术挑战
- 了解达摩院在这一方向的思考与 best practice
演讲亮点
基于团队 ICLR-2025 的最新工作 DyDiT 及其演进工作,讲述扩散模型推理加速的一个重要方向。
关注主办方(InfoQ)


联系我们
交通指南
北京国际会议中心
Beijing International Convention Center
地址:北京市朝阳区北辰东路8号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手