潘滢炜博士,生成式人工智能初创公司智象未来算法科学家,研发了智象视觉多模态基础模型、十亿级商品图像搜索引擎(京东拍照购)、体育赛事智能导播系统、智能机械臂等多项产品和服务。相关研究领域得到国际学术界的广泛认可,曾获评微软学者奖学金、ACM SIGMM China最佳博士论文奖和新星奖、ACM Multimedia 最佳开源项目奖和北京市科技新星计划创新新星,先后6次获得国际学术竞赛冠军。在 CCF A 类刊物上发表学术论文 60 余篇,谷歌学术引用一万余次。
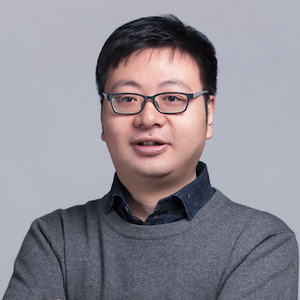
专题演讲嘉宾:潘滢炜
智象未来算法科学家
by 潘滢炜
智象未来
算法科学家在人工智能的浪潮中,多模态内容生成技术正成为创意产业的全新引擎。它融合文本、图像、音频、视频等多种模态,打破单一模态的限制,为内容创作带来前所未有的灵活性和丰富性。本次演讲将深入探讨国际上最近几年多模态内容生成的核心技术突破,包含扩散模型UNet结构到Diffusion Transformer(DiT)架构的演进,智象未来自主研发的智象多模态大模型在图像和视频生成能力上的技术升级,以及如何突破用户最后一公里。同时,还将分享多模态生成技术在设计、营销、影视、文旅等领域的创新应用案例,揭示多模态内容生成如何赋能相关产业,推动内容创作的智能化和创意的个性化发展。
演讲提纲
- 大模型发展和竞争态势
- 多模态AIGC市场空间
- 多模态生成模型技术演进:扩散模型UNet结构、Diffusion Transformer(DiT)架构、智象多模态大模型的扩散自回归模型(DiT+AR)
- 多模态生成技术在相关领域的创新应用
- 展望和未来
技术实践痛点
不需要等到多模态基础模型达到 100 分才去做应用。在现有的基础模型能力之上,如果能找到真正解决用户痛点的场景,并在应用上做得很深,真正做到端到端的 95 分以上,用户就会买单。这就需要我们去对多模态基础模型做很多场景驱动的优化,特别关注基础模型在上层应用中的表现,去解决用户「最后一公里」的问题。
听众收益
- 最新的多模态内容生成技术前沿动态
- 智象未来自主研发的智象多模态大模型技术升级
- 多模态内容生成技术如何赋能相关产业
关注主办方(InfoQ)


联系我们
交通指南
北京国际会议中心
Beijing International Convention Center
地址:北京市朝阳区北辰东路8号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手