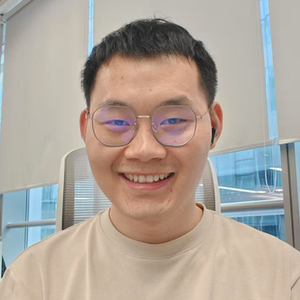
韩剑,硕士毕业于清华大学电子系,现就职于字节跳动商业化技术团队,该团队在视觉生成领域先后推出了 VAR、LllamaGen、Infinity、Goku 等多项重要研究成果。韩剑的主要研究方向为图像生成和视频生成,在自回归图像生成和视频生成领域积累了丰富的经验,其最新研究成果 Infinity 被选中在 CVPR 2025 上做口头报告。
讲师介绍
议题介绍
地点:203
所属专题:多模态实践与应用
演讲:Infinity:视觉自回归生成新路线
以 ChatGPT、DeepSeek 为代表的大语言模型(LLM)取得了巨大的成功,掀起了全球新一轮 AI 浪潮。但是在视觉生成领域,目前主流的方法却是一直以扩散模型为主导。与大语言模型采取相同技术路线的视觉自回归方法因为具有更好的scaling特性,能够统一理解&生成任务,隐藏着巨大的潜力,正受到人们越来越多的重视。
本次演讲中,我将以被选为 CVPR 2025 Oral 的工作 Infinity 为例,详细介绍自回归视觉生成的底层技术原理。并以图像生成和视频生成两个具体场景,分享最新的研究成果和相关思考。
演讲提纲
- 自回归模型和Scaling Law
- 视觉自回归 v.s. 扩散模型
- Infinity:视觉自回归生成新路线
- 离散 Visual Tokenizer
- Bitwise AutoRegressive Modeling
- 图像生成实践
- 视频生成实践
- 分析和思考
您认为,这样的技术在实践过程中有哪些痛点?
目前看以 Infinity 为代表的视觉自回归模型在视频生成任务上相比 SOTA 的扩散模型生成速度具有明显优势,但是效果上还有一些差距。
您的演讲有哪些前沿亮点?
这是一个非常详尽的视觉自回归技术分享,通过这次分享,读者可以深入了解到视觉自回归的底层技术实现、目前达到的效果水位,以及未来可能的研究方向。
听众收益
- 视觉自回归的技术原理、实现方法、目前达到的生成效果
- 视觉自回归技术的优缺点以及未来的发展方向
- 如何基于视觉自回归构建图像/视频生成模型
关注主办方(InfoQ)


联系我们
交通指南
北京国际会议中心
Beijing International Convention Center
地址:北京市朝阳区北辰东路8号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手