腾讯混元视觉大模型中心Tech Lead,目前专注于多模态基础模型研发。曾任微软亚洲研究院主管研究员,在人工智能领域国际期刊和会议如TPAMI、CVPR、NeurIPS等发表学术论文30余篇,Google Scholar他引10,000余次。研究成果多次作为核心技术应用于业界知名产品与业务中,曾多次获得国际算法竞赛奖项,包括物体跟踪竞赛VOT冠军,HACS Temporal Action Localization竞赛冠军等。担任模式识别领域国际知名期刊Pattern Recognition副主编,多媒体领域学术会议ACM Multimedia领域主席。
讲师介绍
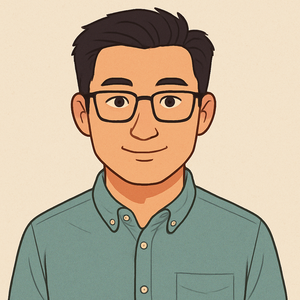
专题演讲嘉宾:DUANGE
腾讯视觉大模型中心Tech Lead
议题介绍
地点:203
所属专题:多模态实践与应用
演讲:腾讯混元多模态大模型技术实践与思考
本次分享将基于混元多模态基础大模型,深入探讨腾讯在多模态技术领域的最新研发进展。混元多模态大模型技术覆盖文本、图像、视频和音频理解与生成多种技术。特别值得一提的是,图像到文本模型包含三个关键组件:视觉变换器(ViT)用于视觉编码、视觉-语言适配器,以及采用专家混合(MoE)架构的大型语言模型。团队高度重视数据质量和多样性,开发了一套高效的自动化数据处理管道。选择MoE架构得益于其在性能和可扩展性方面的卓越表现。通过分阶段训练和推理优化技术,模型的能力得到了进一步加强。为确保模型满足用户需求,团队在强化学习中对偏好进行了对齐,并采用真实用户的A/B测试。目前,该模型已在司内多个业务场景中部署应用。展望未来,计划扩展模型能力,覆盖更多模态,并进一步提升智能性和可靠性。
演讲提纲
- 混元多模态模型发展概况
- 模型架构:视觉变换器(ViT)、视觉-语言适配器、专家混合(MoE)架构
- 支持的模态:文本、图像、视频、音频
- 关键技术特点与创新点
- 混元多模态模型技术实践与挑战
- 数据处理:高效的自动化数据处理管道
- 训练优化:分阶段训练与推理优化技术
- 用户反馈机制:强化学习对偏好对齐、A/B测试
- 面临的技术挑战与解决方案
- 混元多模态模型应用探索
- 图像与文本理解提升推荐系统准确性
- 多模态内容的自动生成与审核
- 其他业务场景中的应用实例
- 未来展望
- 模型能力的扩展方向
- 提升智能性与可靠性的策略
您认为,这样的技术在实践过程中有哪些痛点?
- 模型输出暂未达到绝对的准确,例如存在幻觉等问题。
您的演讲有哪些前沿亮点?
- 介绍大模型实践的经验与思考。
听众收益
- 了解多模态大模型的实验经验
- 了解在实际业务中的应用场景
关注主办方(InfoQ)


联系我们
交通指南
北京国际会议中心
Beijing International Convention Center
地址:北京市朝阳区北辰东路8号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手