随着企业 AI 从 Copilot 走向 Agent,数据系统的角色正在发生变化... 展开 >
智能体时代的数据供给与治理
会议室:大宴会厅A出品人:陈廷梁(王贲)
- Topic 1
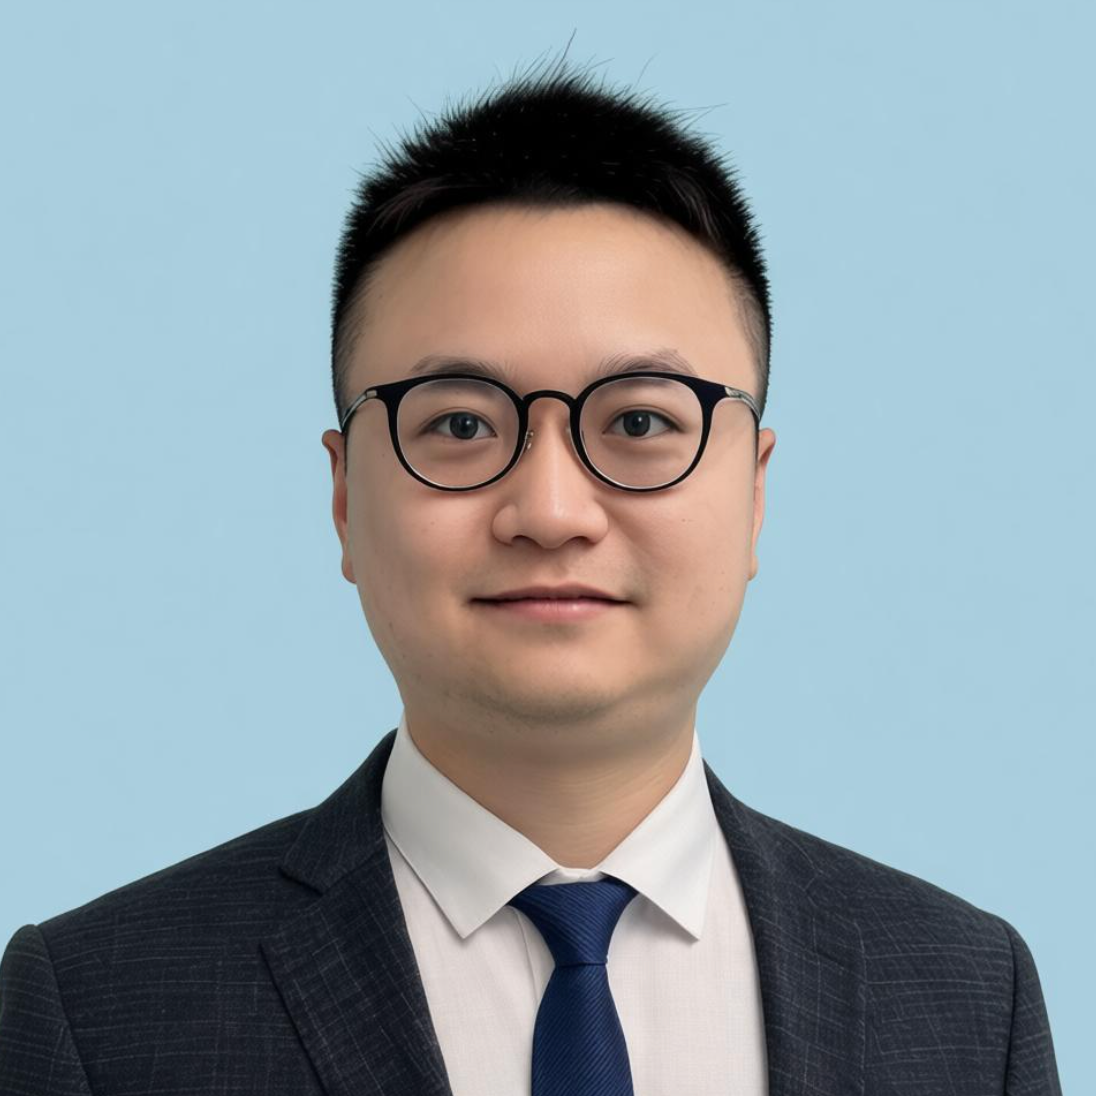
王璟尧
阿里云智能集团 高级技术专家 - Topic 2
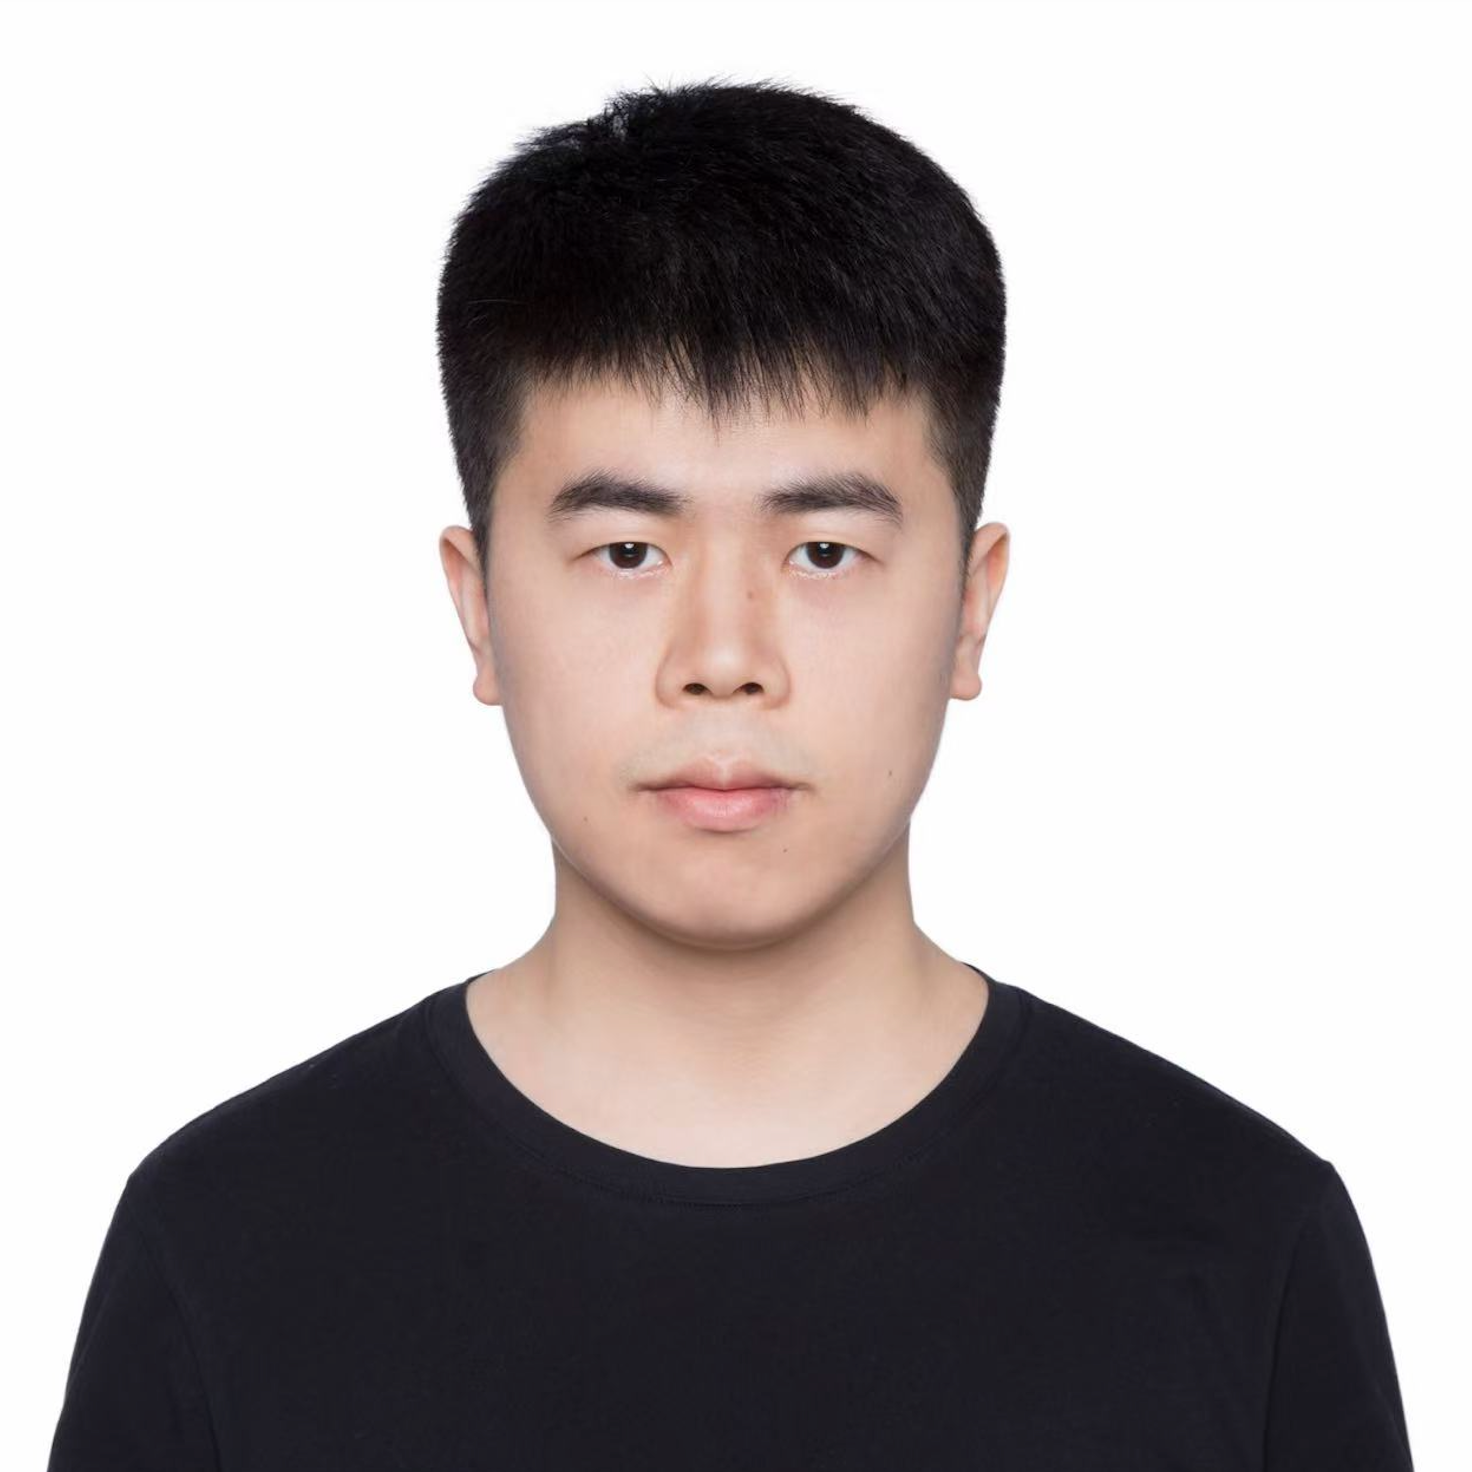
彭锦文
腾讯 DataBuddy Harness 工程负责人 - Topic 3
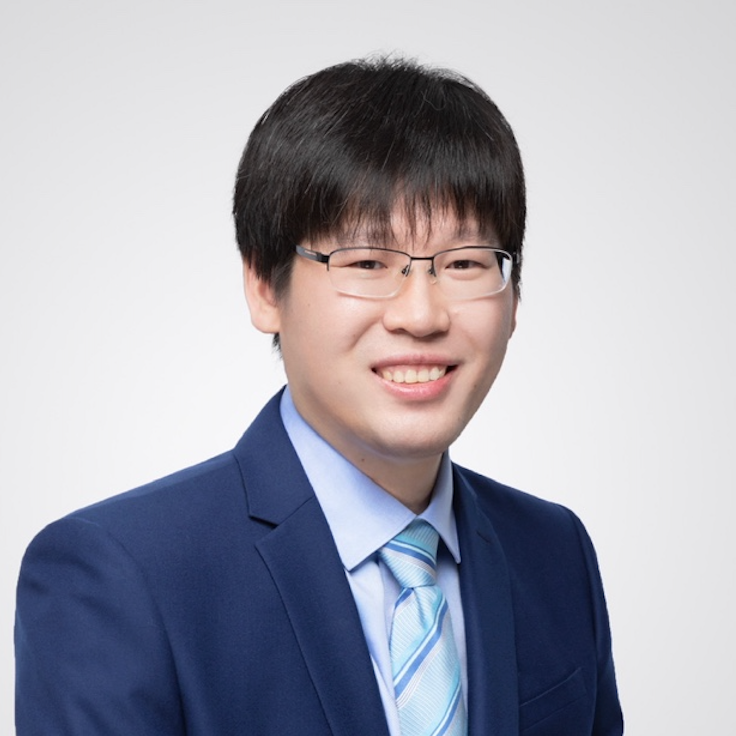
许锡彬
数新智能 总架构师 - Topic 4
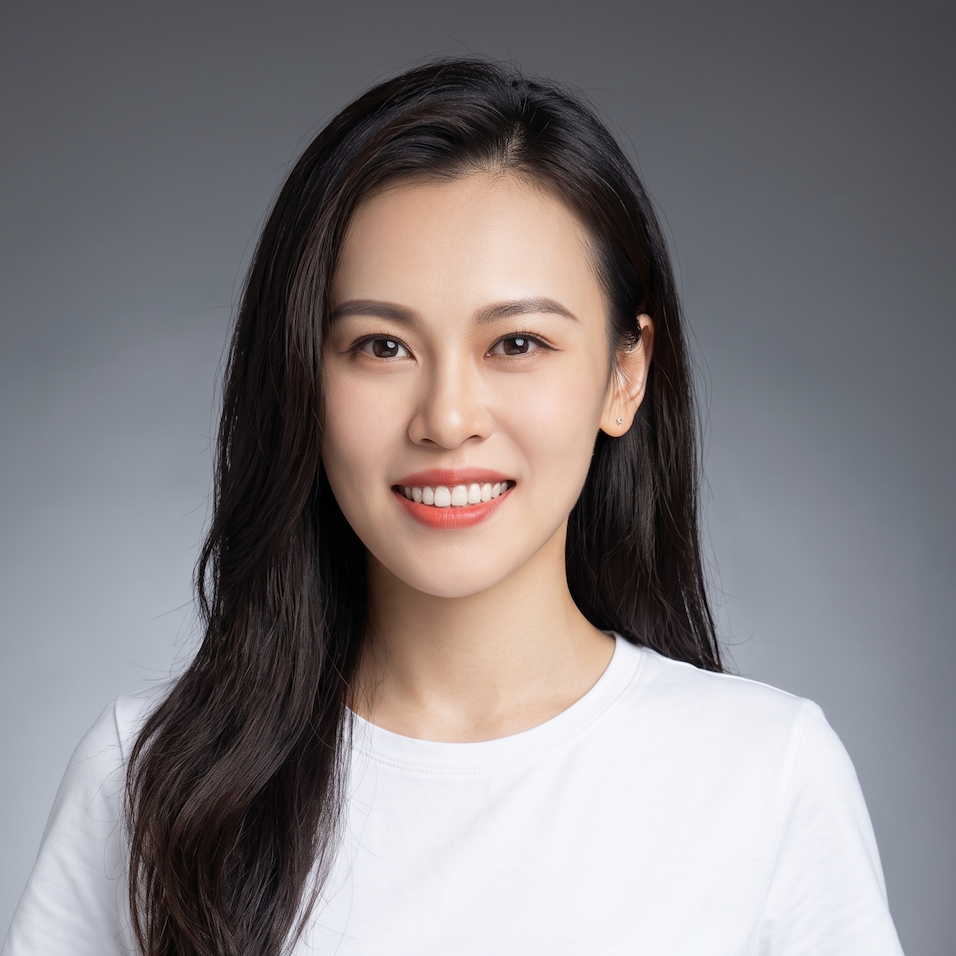
巴志欣
云器科技 AI 产品总监
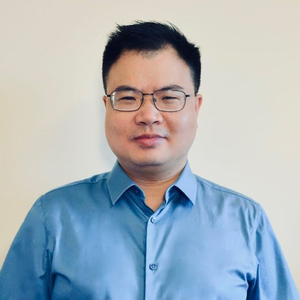
专题出品人:陈廷梁(王贲)
数新智能创始人兼CEO
陈廷梁(花名:王贲),数新智能创始人兼CEO,CCF TF AI+生物医药SIG主席、大数据专委会执委、数据治理与发展技术委员会执委员,哈工大计算学部浙江校友会会长。
原阿里云研发总监,阿里大数据平台DataWorks创始人和人工智能平台PAI的工程开发负责人。
2020年创立数新智能,开创云数据平台,致力于构建全球领先的一站式多云AI原生数据智能平台、大模型时代Data+ AI一体化的底座平台。带领公司自主研发的DataCyber产品体系已获Gartner、IDC、中国信通院相关荣誉奖项,并已服务金融、央国企、大型制造、能源电力、零售、出海等行业头部客户。
地点:大宴会厅A
专题:智能体时代的数据供给与治理
随着企业 AI 从 Copilot 走向 Agent,数据系统的角色正在发生变化:它不再只是支撑报表、分析和训练,而是要为智能体提供可理解、可访问、可追溯、可治理的数据服务。本专题关注智能体时代的数据基础设施,覆盖非结构化与多模态数据处理、业务语义层、Data Agent、数据权限与血缘、AI 数据质量和评估闭环等方向。
by 王璟尧
阿里云智能集团
高级技术专家数据智能体从"能对话"到"能信赖",瓶颈从模型推理能力已逐渐转到数据的可理解性和系统的可控性上。当分析场景从单一数仓的 ChatBI 扩展到多源异构数据的混合查询——Agent 面临的不再只是 NL2SQL 的准确性问题,而是"在大量的表、文件、内部知识中找到正确的那部分、用正确的口径、给出数据权限范围内可验证的答案"。
本次分享将基于 QuickBI AI Pro 的落地实践,围绕三个核心问题展开:第一,如何用 BI 语义层消除数据歧义,让 Agent 在海量异构资产中精准路由;第二,如何设计数据分析的 Harness 架构,让 Agent 在分析等行为上可编排、可溯源,并内嵌权限;第三,端到端评测闭环如何覆盖从意图理解到业务可解释性的全链路,驱动 Agent 持续进化而非漂移。
演讲提纲
1. 数据智能体落地的真实困境
- 几个典型失败模式
- 待解决的关键问题
2. 数据基础设施:语义层和数据质量
- 为什么自动化元数据检索不够
- 面向 BI 的语义设计和分层架构
- 指标、血缘和溯源
- 多源异构及非结构化数据的分析
- 数据治理:数据如何被 Agent 理解的更好
3. Quick BI 的数据智能体设计
- 数据分析 Harness 架构
- 多步推理编排和上下文窗口管理
- 数据权限与安全
- 知识与记忆
- 多源异构数据的融合分析
4. 端到端评测:数据智能体的进化引擎
- 数据分析评测为什么难
- 四层评测维度设计
- 评测体系和纠错飞轮
5. 用户实践和展望
- 用户实践案例
- 能力边界和未来发展展望
演讲痛点
- Demo 惊艳,生产翻车。在演示时数准确率 90%,一上生产就掉到 50% 以下。同一个"销售额",销售部门和财务部门问出两个不同的数,业务方追问"到底哪个对",答不上来。POC 拿到预算,规模化后被投诉——这是绝大多数 Data Agent 项目正经历的窘境
- Agent "越用越飘"。上周还答对的问题,这周突然错了。是模型漂了还是 Schema 变了?或是知识库里写脏了?没有评测体系时,团队只能靠"用户投诉→人工救火"来发现问题,永远在追着 bug 跑
- 结构化数据都还没搞定,非结构化数据又压过来。业务开始要求 Agent 分析 PDF 合同、销售录音、客户评论、Excel、CRM 数据。多源异构不是简单叠加,是把每类失败模式都放大一个数量级
- 从" Agent 说了什么"到"业务敢用",中间隔着一道天堑。老板问"这个数怎么来的",Agent 答不出,业务方问"我能信这个结论吗"也给不出置信度。数据权限在 Agent 环节形同虚设——不该看的数据混进了推理链
听众收益
- 基于 BI 的语义层的构建、数据治理的落地顺序
- 数据智能体的 Harness 架构设计要点和工程落地
- 多源异构数据在推理分析中协同的编排模式
- DataAgent 评测体系、构建方法及纠错飞轮
- 一份真实的踩坑清单、边界、案例启发和实践经验
by 彭锦文
腾讯
DataBuddy Harness 工程负责人企业数据场景对 Agent 的要求远高于通用问答或代码辅助:它要访问元数据、生成 SQL、调用治理平台、修改任务配置、触发调度发布,全程还要处理敏感数据、权限边界和审计要求。一旦出错,代价不是「答错一句话」,而是「在有权限的环境里执行了错误动作」。
本次分享拆解 DataBuddy 如何用一套 Agent Runtime 回答三个核心问题:执行可控、语义可信、系统可进化。以真实的端到端案例让大家看到 Agent 跑起来的样子,再自底向上讲清背后的架构及承载这一切的 Agent Runtime 执行内核;随后重点放在「语义」这条主线:语义如何冷启动、如何越用越准、如何用 Text-to-SQL 进行安全兜底;并介绍支撑语义可信的知识记忆与安全两大底座。既有设计取舍,也坦诚当前边界。
演讲提纲
1. 为什么企业数据 Agent 更难
- 数据 Agent 不止是 Text-to-SQL 封装
- 从「答错一句话」到「在有权限的环境里执行错误动作」的风险跃迁
- 三个核心设计问题:执行可控、语义可信、系统可进化
2. 「建仓 + 同步」端到端案例
- 一句话诉求「接入 MySQL 销售库、建 ODS/DWD/DWS 三层、配置每日增量同步」的完整链路
- 从案例中直观感受 Agent 的动态行为:自主规划 + 能力契约 + Hook Guardrail + Trace 产物
- 这条链路为什么可控、可信、可进化,后续逐层展开
3. 总体架构
- 控制面与数据面分离
- 五层架构与 Runtime 隔离设计
- 推理与执行解耦、能力与安全解耦、短期状态与长期知识解耦
4. Agent Runtime
- WorkBuddy 同源 Harness
- Agent Runtime 生命周期与可观测性
- 能力组织:专家能力与业务语义、执行契约、安全等级
- 数据领域loop的特点和差异
- 数据领域专有工具能力
5. 语义:让 SQL 从能跑到可信
- 语义的冷热启动——冷启动期元数据缺失、口径未沉淀,靠约定与人工兜底;热启动后语义资产累积,准确率与自动化程度同步抬升
- 抽象沉淀——把一次次临时查询与口径修正萃取为可复用的语义抽象,让语义覆盖度随使用持续增长
- 语义 coverage——划定可信边界、选择执行路径与人工确认强度,让 Agent 清楚自己哪里可信、哪里该谨慎
- Text-to-SQL 兜底——语义层未覆盖时降级至受约束的 Text-to-SQL,并进入静态分析、语义对齐、权限收敛的防护链路
- 覆盖度与降级决策沿 ReAct Loop 逐步收敛
6. 知识:分层记忆 + 数据图谱
- 纵向分层——Session、Personal、Team、Enterprise 四层记忆,按作用域 × 生命周期定位,权威性逐层增强
- 横向成图——表/列、指标/维度、血缘、质量规则、SQL 模板互连成资产关系图;检索融合文本相关性 + 资产热度 + 血缘中心度 + 权威性
- 经验复利闭环——使用、修正、沉淀、审核、复用,Agent 既是知识消费者也是生产者,越用越准
7. 安全体系
- 风险三要素
- 多层纵深防御,Agent 识别 + 规则引擎 + 审计 Agent 异步协同
- SQL 多段防护:Prompt、Text-to-SQL、静态分析、语义对齐、权限、改写、HITL、执行、结果脱敏、审计
- 敏感隔离:敏感信息不进对话、不进上下文、不进记忆
8. 评测
- 离线回归 + 在线观测双体系
- 确定性校验 + LLM-as-Judge + 人工标注三层评判
- 数据 Agent 评测三难题:语义正确性、确认门自动化、防作弊
演讲痛点
- 语义正确性难验证——SQL 能跑通不代表口径对,join 漏条件、粒度翻倍这类错误不报错却最致命,且没法全自动校验,最终仍靠人对数
- 知识冷启动悖论——"越用越准"的前提是有人先用,但初期元数据缺失、口径未沉淀导致准确率低,没人敢用,早期信任低谷难熬
- 安全与体验对立——纵深防御累加延迟,确认太多变手工、太少会出事,HITL 的"度"要在生产里反复磨
- 动作可控性——长链路任务中途失败,有副作用的写/调度难回滚、难幂等
- 组织信任——"敢把核心数据交给 Agent"本质是责任归属和信任问题,从只读分析到可写生产循序渐进建立
听众收益
- 一套可复用的数据 Agent 架构心智:模型推理、Harness 执行、知识与记忆、安全边界
- 语义可信的工程主线:冷热启动、抽象沉淀、语义 coverage、Text-to-SQL 兜底,全部跑在同一套 Agent Runtime 上,让 Agent 越用越准且知道自己边界
- 数据 Agent 的安全方法论:风险三要素、纵深防御
- 让 Agent「越用越准」的知识路径:知识与记忆 + 数据图谱 + 经验萃取的治理闭环
by 许锡彬
数新智能
总架构师随着企业 AI 从 Copilot 走向 Agent,数据系统的角色正在被重写:它不再只是支撑报表与训练,而是要为智能体提供可理解、可访问、可追溯、可治理的数据服务。企业真正的困境往往不是「没有模型」,而是数据沉睡与 AI 悬浮并存——资产存而不通、通而不用;通用 Agent 会聊天、会调工具,却进不了核心数据研发与治理流程,更不敢被委派目标后自主跑通闭环。
本次分享围绕 DataCyber 中的 Data Agent,提出构建企业数据智能中枢的工程范式。我们将给出一个可记忆的公式 SRW + GPME:用 Skill · Role · Workflow(执行三角)把数据研发做成可复制的系统能力;用 Goal · Policy · Memory · Eval(治理四件套)回答如何从「人机协同操作」工程化走到「目标委派、结果审阅」的自主阶段。分享会明确与同场「分析可信」「Runtime 可控」议题的边界:本场聚焦数据供给与治理中枢,以及研发/治理闭环如何被 Agent 安全地规模化。
演讲提纲
1. 智能体时代,为何需要数据智能中枢
- 从 Copilot 到 Agent:数据平台角色变迁
- 双重困境:数据沉睡与 AI 悬浮
- 三阶段定位:辅助 → 协同 → 自主,当前关键在 2→3
2. 中枢最小架构:让 Agent「吃得到、用得对、留得住痕迹」
- DataCyber 底座:湖仓一体、统一调度、资产与元数据工具面
- 语义与资产层:口径、血缘、指标——中枢大脑
- MCP 工具面:业务增强优先、平台原生兜底
- 一图看懂:底座 → 语义 → Agent → 研发/治理/运维闭环
3. 范式内核 SRW:把专家经验变成可执行系统
通用 AI 在数据研发上的四个失败:不稳、难学、无闭环、无语义
- Skill:原子能力 + 契约与规范前置(可测、可追溯)
- Role:研发动线身份 + 权限与协作边界
- Workflow:主链完整 / 分支敏捷,节点级 I/O 与门禁
- 微案例:从需求文档到建模产物的分钟级闭环切片
4. 治理四件套 GPME:工程化走到阶段 3 的钥匙
- Goal:产品单元从「会话」升级为「目标 + 验收」
- Policy:按读/写/生产变更等风险分级放权,HITL 从逐步确认变为少而硬的门禁
- Memory:组织口径、纠错与最佳实践分层沉淀
- Eval:用达成率/介入率等指标解锁自主度,外环回写 Skill(人审合入)
- 公式收束:SRW 负责做完,GPME 负责做对、做稳、做越来越强
5. 实践收益、能力边界与行动建议
- 效能与规范:端到端达成率、规范执行率、人日到分钟的跃迁
- 坦诚边界:语义冷启动、写生产强门禁、跨域自进化未完成
实践痛点
1. 会聊天不等于能进生产。 通用 Agent 可以生成 SQL、调用工具,但缺业务语义、缺规范门禁、缺发布闭环时,结果是「可用但不可信」——研发仍要人肉托底,管理者看到的只是 Demo 效率,不是生产效率。
2. 协同很忙,自主不敢。 人机协同阶段 Agent 已能接管大量操作,但目标拆解、写生产、上线发布仍处处人工点头。不敢放权,是因为没有 Goal 验收、没有风险策略、没有评测仪表盘——自主变成了「更长的 ReAct」,不是可委派系统。
3. 规范靠人,规模化必垮。 命名、分层、生命周期、质量规则若只写在文档和专家脑子里,Agent 跑得越快,低水平重复和口径漂移越快。没有「规范进 Skill / 校验进门禁」,提效与「做对」必然打架。
4. 分析可信、执行可控之外,供给中枢缺位最致命。 问数要准、动作要稳,前提都是底层数据可理解、可治理、可审计。若中枢缺位,两端都会在真实业务里翻车——企业缺的往往不是又一个 Bot,而是 Agent 时代的数据供给与治理操作系统。
听众收益
1. 一套可对外复述的中枢心智:数据智能中枢 = 可调用底座 + 语义大脑 + Agent 闭环
2. 一个记忆锚点公式:SRW + GPME(执行三角 · 治理四件套),可用于设计自家 Data Agent 范式
3. 一条从阶段 2 到阶段 3 的工程路径:Goal 对象化、Policy 门禁、Memory 沉淀、Eval 解锁自主度
4. MCP 双向集成策略:业务增强优先、平台原生兜底,兼顾贴合度与完备性
5. 一份可执行的起步清单:Skill 拆解、Role 定义、主链 Workflow、HITL 风险分级与评测看板
by 巴志欣
云器科技
AI 产品总监本次演讲主要分享如何在数据平台内构建生产级 Data Agent:通过语义层完成数据加工管道生成,通过知识库构建智能任务运维能力,通过三层递进的 DQC 治理闭环提升数据质量规则建设效率,并在统一安全边界和行业规则库下实现可控落地。
演讲提纲
1、从一个真实问题开始:为什么今天报表没数据
- Tool-calling Agent 能查日志、查状态、执行 SQL,但很快会卡住
- 因为真实数据问题不是单点操作,而是跨报表、指标、任务、血缘、质量和权限的综合判断
- 引出主论点:生产级 Data Agent 的核心能力是 Context + 长工作流闭环
2、生产级 Data Agent 的设计原则:Context + 闭环
- Context:让 Agent 更懂用户、业务、数据对象、指标口径、血缘依赖、任务状态和权限边界
- 闭环:让 Agent 不只生成建议,还能诊断、执行、验证、修复、发布、监控和留痕
- 安全边界:Agent 默认不直接访问原始明细数据,而是优先使用元数据、语义层、血缘、任务状态、日志摘要和 profiling 统计信息
- 这个安全原则贯穿全篇:既提升 Agent 判断能力,也避免它越权访问、误操作生产数据或泄露敏感信息
3、场景一:基于语义层构建数据加工管道
- 用户表达的是业务目标,不是表名和字段名
- Agent 通过语义层理解指标、维度、口径、过滤条件和数据对象映射
- 基于上下文判断应该生成临时查询、ETL 任务、Pipeline、动态表还是调度任务
- 闭环包括:生成 SQL/管道配置、试运行、修复报错、校验结果、创建任务、配置调度和依赖
- 证明点:语义层提供 Context,执行链路提供闭环
4、场景二:基于知识库构建智能任务运维
- 回到开场问题:“今天报表没数据”
- Agent 需要结合任务日志、错误码、历史处理记录、调度依赖、血缘链路、资源状态和平台规则
- 它不只是解释报错,而是沿着链路定位根因:报表任务、ADS 表、DWD 表、上游同步、调度依赖、资源队列、质量拦截
- 闭环包括:定位原因、生成修复方案、执行或引导修复、验证数据恢复、输出诊断报告
- 证明点:知识上下文决定 Agent 是否能从“解释错误”升级为“解决问题”
5、场景三:DQC 治理闭环:三层递进的质量规则生成
DQC 的目标不是让 Agent 随意扫描数据,而是在安全边界内降低质量规则建设成本
- 第一层:普通规则创建。用户用自然语言描述规则,Agent 转成空值、唯一性、值域、波动阈值等 DQC 配置
- 第二层:字段类型推荐。Agent 基于字段名、字段类型、字段注释、主键/分区属性等元数据推荐规则
- 第三层:Profiling 生成。Agent 基于空值率、唯一值数、分布、最大最小值、分位数、数据量趋势等统计画像生成更贴近业务的规则
- 补充能力:行业规则库可作为增强项,针对金融、零售、制造、互联网等场景提供规则模板
- 证明点:DQC 场景体现了“安全 Context + 治理闭环”的产品化能力
6、产品体验:让闭环真正可用
- 用户不需要知道底层工具和参数,只需要表达业务问题
- Agent 在关键步骤提供预览、确认、风险提示和回退
- 长工作流支持检查点、中断恢复、执行记录、审批确认、失败重试和结果验证
- 好体验不是界面包装,而是让用户相信 Agent 能稳定、可控地完成数据工作
7、效果评估与指标
- 数据开发:Pipeline 创建数、任务创建数、SQL 生成采纳率、开发周期缩短
- 智能运维:诊断次数、平均定位时长缩短、自动修复/辅助修复成功率
- DQC 治理:规则创建数、规则覆盖率、异常发现率、误报率、问题闭环率
- 平台经营:Token 消耗、查询增长、计算资源消耗、Agent 活跃用户数
演讲痛点
- 工具调用只能完成单步操作:很多 Agent Demo 能查表、跑 SQL、调用 API,但一旦进入真实数据开发、任务运维、质量治理场景,就缺少持续推进复杂流程的能力
- Agent 不懂业务语义:用户说的是“新增用户”“转化率”“今天报表没数据”,但平台里对应的是指标口径、字段、任务、血缘、调度和质量规则,普通工具无法自动建立映射
- 数据平台上下文割裂:元数据、血缘、任务日志、知识库、DQC 规则、权限审计分散在不同模块,Agent 如果只会调用工具,就很难综合判断问题原因
- 生产环境不敢放手给 Agent 执行:企业担心 Agent 访问原始数据、误改生产任务、生成错误 SQL、影响下游报表,因此需要安全边界、审批、审计、回滚和验证机制
- 数据治理建设成本高:DQC 规则依赖人工经验,规则创建慢、覆盖率低、行业适配弱,导致质量问题经常在报表或业务侧暴露后才被发现
- 长工作流无法闭环:真实数据工作不是一次问答,而是“理解需求 → 生成方案 → 执行 → 验证 → 失败重试 → 发布 → 复盘”,普通 Agent 很难保留状态并持续推进
听众收益
- 理解生产级 Data Agent 与工具调用的本质差异:听众可以明确判断,什么场景适合三方工具调用,什么场景必须在数据平台内构建专属 Data Agent
- 获得一套 Data Agent 能力框架:从 Data for AI 和 AI for Data 两个维度,理解语义层、知识库、元数据、血缘、任务状态如何共同支撑 Agent 落地
- 看到三个可落地场景:包括基于语义层生成数据加工管道、基于知识库做智能任务运维、基于三层递进方法构建 DQC 治理闭环
- 掌握 Data Agent 的产品壁垒设计思路:重点理解 Context、长工作流、安全边界和产品体验,如何让 Agent 从 POC 走向生产可用
- 获得可参考的建设路径和指标体系:知道如何从 Pipeline 创建、任务诊断、DQC 规则生成等场景切入,并用任务创建数、规则创建数、诊断采纳率、Token 消耗等指标衡量效果
- 降低企业落地风险:通过“不直接访问原始数据,只基于元数据、统计信息、知识库和规则模板工作”的设计,帮助听众理解如何在安全合规前提下引入 Agent
关注主办方(InfoQ)
联系我们
交通指南
深圳湾万丽酒店
Shenzhen Bay Marriott Hotel
地址:深圳南山区粤海街道高新区社区科技南路18号
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手