10 余年研发经历,曾参与 QQ 兴趣部落/腾讯看点/ QQ 浏览器/ QQ /腾讯云大数据等业务,长期负责核心业务与技术体系建设,覆盖 C 端高并发场景与 B 端平台。近年聚焦 Agent 与工程治理提效,主导了团队自研 Agent 与 AI Coding 体系落地。擅长在复杂组织与跨域场景中,持续产出可量化结果并沉淀可复用方法论。
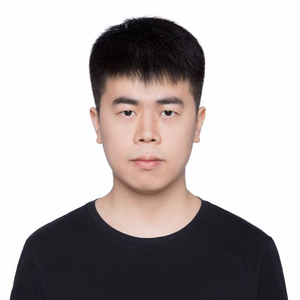
专题演讲嘉宾:彭锦文
腾讯DataBuddy Harness 工程负责人
by 彭锦文
腾讯
DataBuddy Harness 工程负责人企业数据场景对 Agent 的要求远高于通用问答或代码辅助:它要访问元数据、生成 SQL、调用治理平台、修改任务配置、触发调度发布,全程还要处理敏感数据、权限边界和审计要求。一旦出错,代价不是「答错一句话」,而是「在有权限的环境里执行了错误动作」。
本次分享拆解 DataBuddy 如何用一套 Agent Runtime 回答三个核心问题:执行可控、语义可信、系统可进化。以真实的端到端案例让大家看到 Agent 跑起来的样子,再自底向上讲清背后的架构及承载这一切的 Agent Runtime 执行内核;随后重点放在「语义」这条主线:语义如何冷启动、如何越用越准、如何用 Text-to-SQL 进行安全兜底;并介绍支撑语义可信的知识记忆与安全两大底座。既有设计取舍,也坦诚当前边界。
演讲提纲
1. 为什么企业数据 Agent 更难
- 数据 Agent 不止是 Text-to-SQL 封装
- 从「答错一句话」到「在有权限的环境里执行错误动作」的风险跃迁
- 三个核心设计问题:执行可控、语义可信、系统可进化
2. 「建仓 + 同步」端到端案例
- 一句话诉求「接入 MySQL 销售库、建 ODS/DWD/DWS 三层、配置每日增量同步」的完整链路
- 从案例中直观感受 Agent 的动态行为:自主规划 + 能力契约 + Hook Guardrail + Trace 产物
- 这条链路为什么可控、可信、可进化,后续逐层展开
3. 总体架构
- 控制面与数据面分离
- 五层架构与 Runtime 隔离设计
- 推理与执行解耦、能力与安全解耦、短期状态与长期知识解耦
4. Agent Runtime
- WorkBuddy 同源 Harness
- Agent Runtime 生命周期与可观测性
- 能力组织:专家能力与业务语义、执行契约、安全等级
- 数据领域loop的特点和差异
- 数据领域专有工具能力
5. 语义:让 SQL 从能跑到可信
- 语义的冷热启动——冷启动期元数据缺失、口径未沉淀,靠约定与人工兜底;热启动后语义资产累积,准确率与自动化程度同步抬升
- 抽象沉淀——把一次次临时查询与口径修正萃取为可复用的语义抽象,让语义覆盖度随使用持续增长
- 语义 coverage——划定可信边界、选择执行路径与人工确认强度,让 Agent 清楚自己哪里可信、哪里该谨慎
- Text-to-SQL 兜底——语义层未覆盖时降级至受约束的 Text-to-SQL,并进入静态分析、语义对齐、权限收敛的防护链路
- 覆盖度与降级决策沿 ReAct Loop 逐步收敛
6. 知识:分层记忆 + 数据图谱
- 纵向分层——Session、Personal、Team、Enterprise 四层记忆,按作用域 × 生命周期定位,权威性逐层增强
- 横向成图——表/列、指标/维度、血缘、质量规则、SQL 模板互连成资产关系图;检索融合文本相关性 + 资产热度 + 血缘中心度 + 权威性
- 经验复利闭环——使用、修正、沉淀、审核、复用,Agent 既是知识消费者也是生产者,越用越准
7. 安全体系
- 风险三要素
- 多层纵深防御,Agent 识别 + 规则引擎 + 审计 Agent 异步协同
- SQL 多段防护:Prompt、Text-to-SQL、静态分析、语义对齐、权限、改写、HITL、执行、结果脱敏、审计
- 敏感隔离:敏感信息不进对话、不进上下文、不进记忆
8. 评测
- 离线回归 + 在线观测双体系
- 确定性校验 + LLM-as-Judge + 人工标注三层评判
- 数据 Agent 评测三难题:语义正确性、确认门自动化、防作弊
演讲痛点
- 语义正确性难验证——SQL 能跑通不代表口径对,join 漏条件、粒度翻倍这类错误不报错却最致命,且没法全自动校验,最终仍靠人对数
- 知识冷启动悖论——"越用越准"的前提是有人先用,但初期元数据缺失、口径未沉淀导致准确率低,没人敢用,早期信任低谷难熬
- 安全与体验对立——纵深防御累加延迟,确认太多变手工、太少会出事,HITL 的"度"要在生产里反复磨
- 动作可控性——长链路任务中途失败,有副作用的写/调度难回滚、难幂等
- 组织信任——"敢把核心数据交给 Agent"本质是责任归属和信任问题,从只读分析到可写生产循序渐进建立
听众收益
- 一套可复用的数据 Agent 架构心智:模型推理、Harness 执行、知识与记忆、安全边界
- 语义可信的工程主线:冷热启动、抽象沉淀、语义 coverage、Text-to-SQL 兜底,全部跑在同一套 Agent Runtime 上,让 Agent 越用越准且知道自己边界
- 数据 Agent 的安全方法论:风险三要素、纵深防御
- 让 Agent「越用越准」的知识路径:知识与记忆 + 数据图谱 + 经验萃取的治理闭环
关注主办方(InfoQ)


联系我们
交通指南
深圳湾万丽酒店
Shenzhen Bay Marriott Hotel
地址:深圳南山区粤海街道高新区社区科技南路18号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手