聚焦人工智能核心前沿赛道,锚定定义下一代智能边界的关键技术突破,深度探讨AI f... 展开 >
人工智能前沿技术探索
会议室:源福厅1+2+3出品人:张铭
- Topic 1
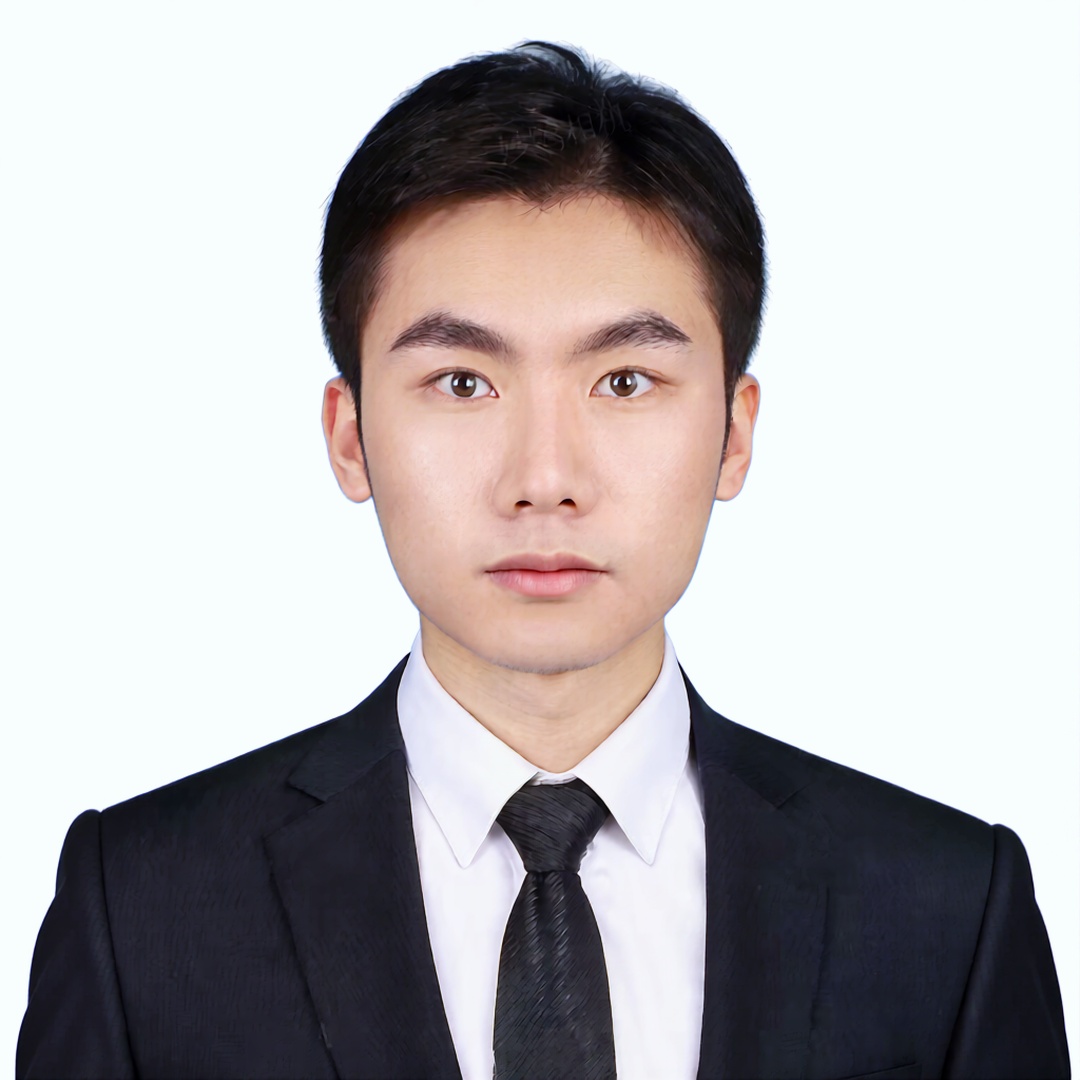
杨祥辉
腾讯 资深技术专家 - Topic 2
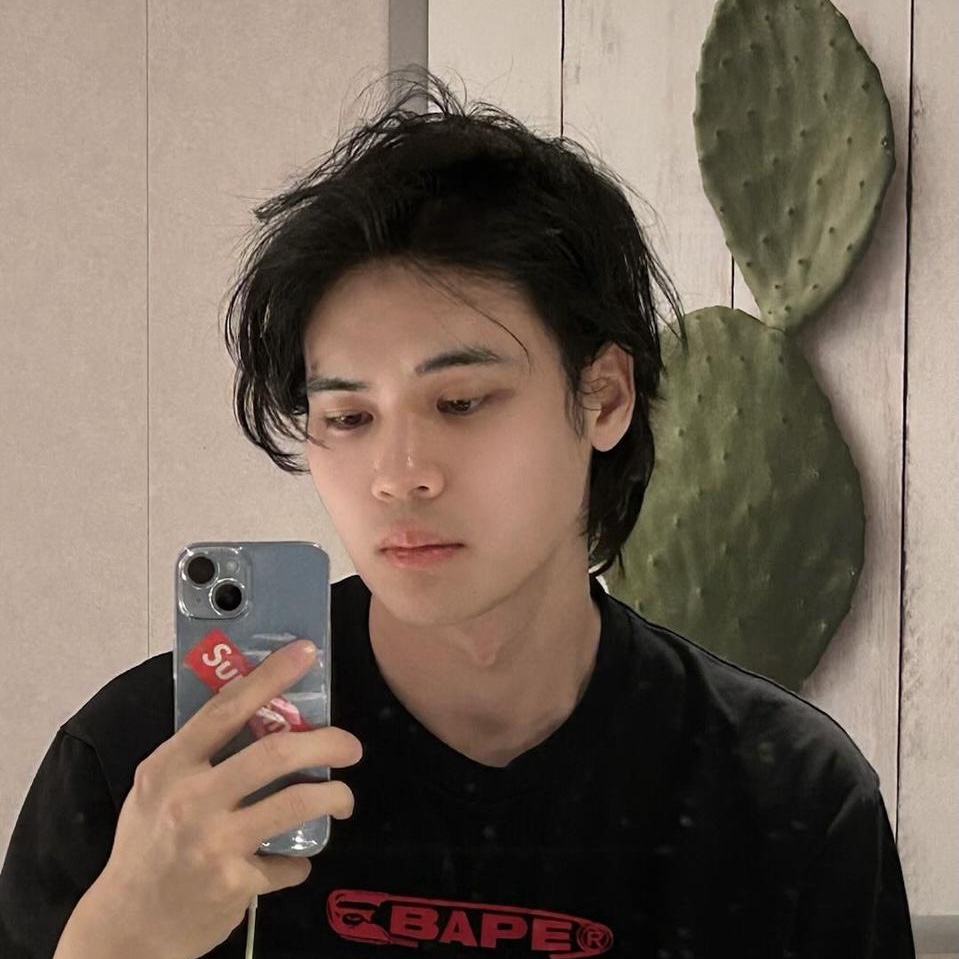
吴光亚
得物 算法专家 - Topic 3
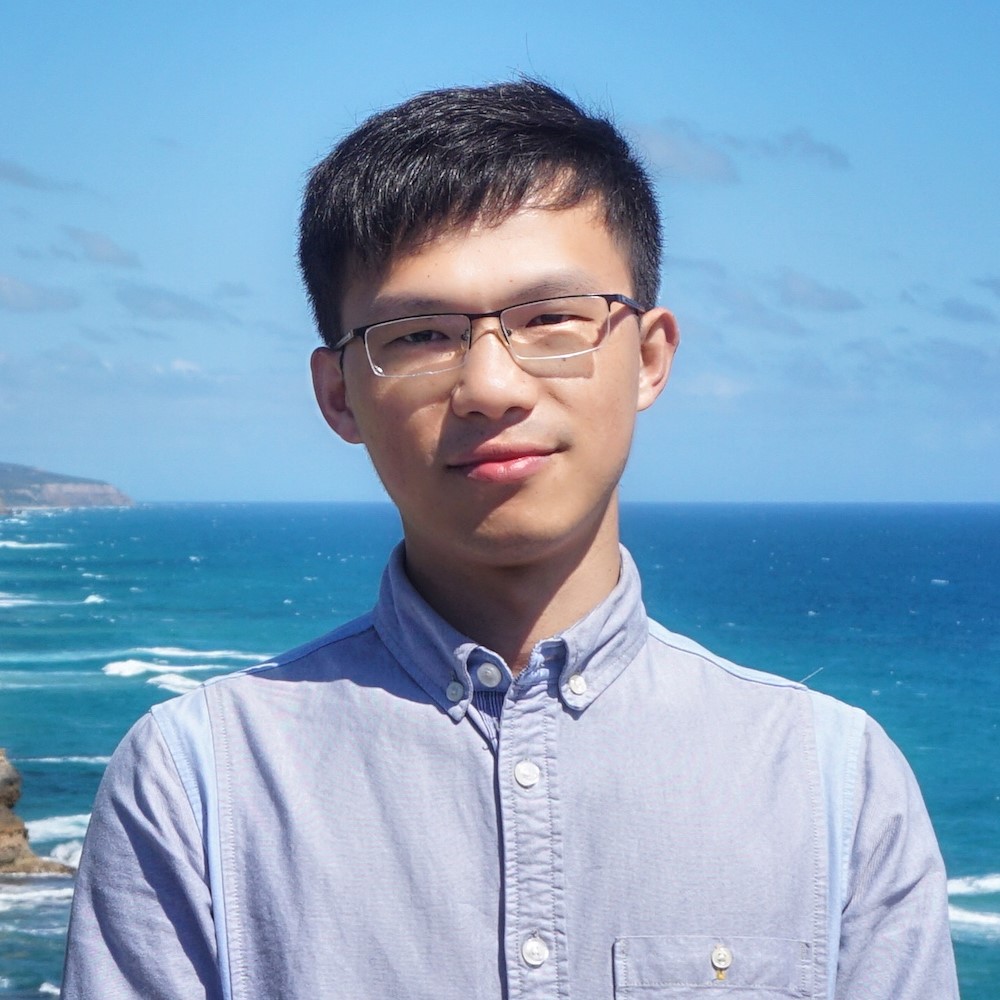
何聪辉
上海人工智能实验室 青年科学家 - Topic 4
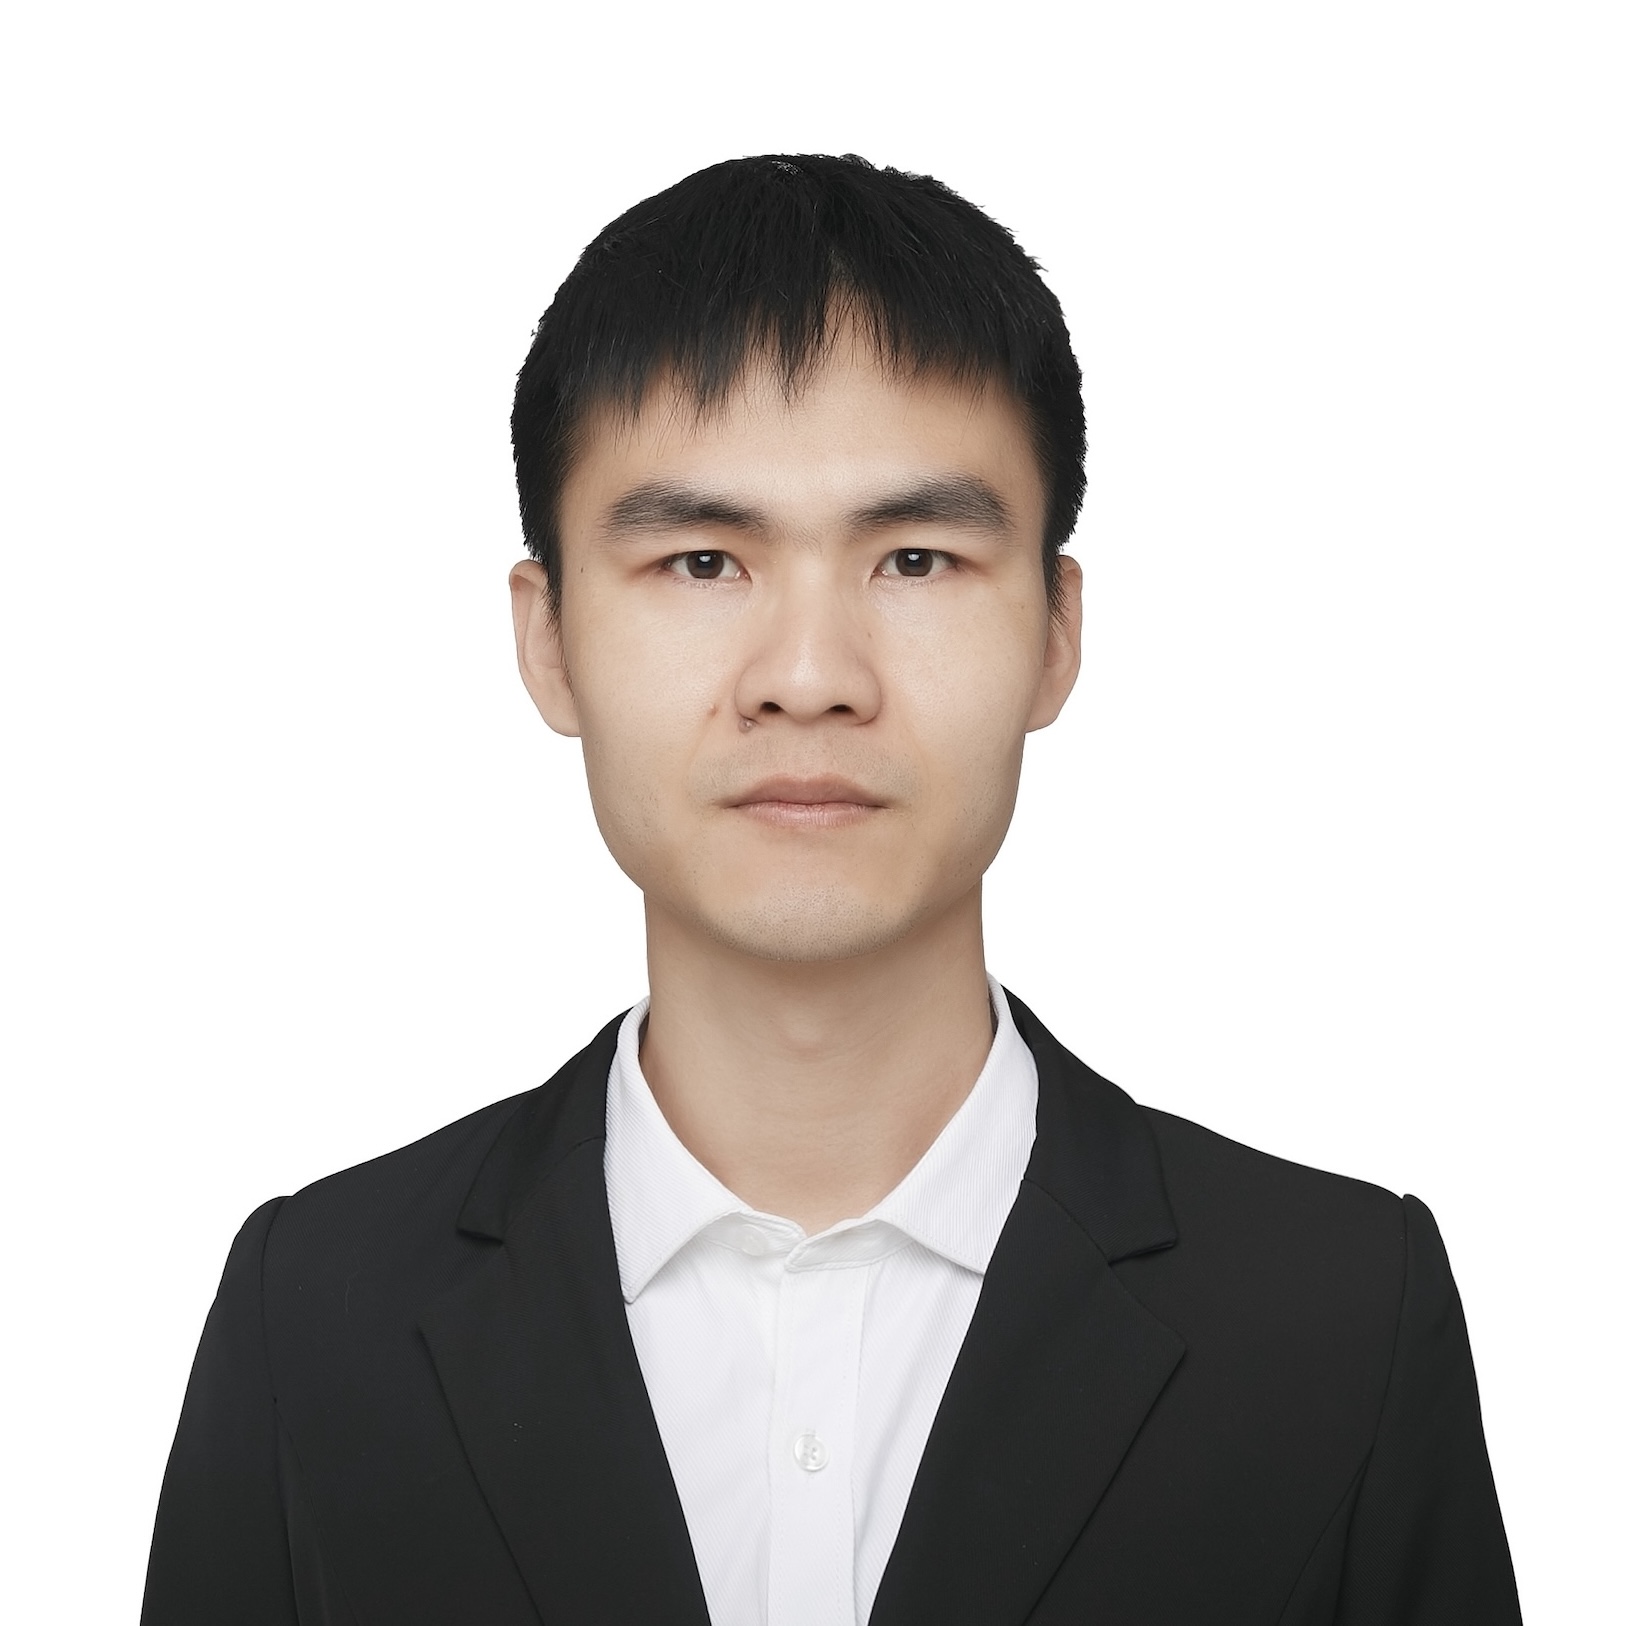
贾荣来
快手科技 社区科学部 推荐架构高级专家
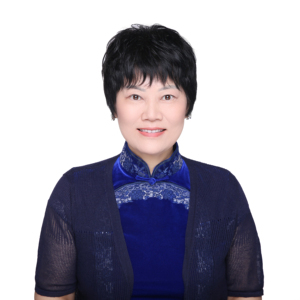
专题出品人:张铭
北京大学 二级教授
北京大学计算机学院二级教授,博士生导师。自 1984 年考入北京大学,分别获得学士、硕士和博士学位。2000 年至今历任三届教育部高等学校大学计算机教学指导委员会委员,ACM/IEEE CC2020计算学科规范执委,中国计算机学会 CCF 杰出教育奖获得者,获机器学习领域顶会ICML 2014最佳论文奖、自然语言处理顶会ACL L 2025最佳论文奖。所主持的“数据结构与算法”被评为国家级精品课程、国家级优质资源共享课、国家级精品在线开放课程、首批国家级一流本科课程。研究方向为大模型、图机器学习、科学智能、教育大数据等,发表论文400余篇,谷歌学术被引26000余次,H因子62。目前主持国家重点研发课题和自然科学基金面上项目以及头部公司合作项目,进行前沿探索,解决实际问题并且重视科研成果的转化落地。张铭老师所培养的多名学生在国内外名校和科研单位担任教职和研究工作,多名学生成为独角兽公司创始人。
地点:源福厅1+2+3
专题:人工智能前沿技术探索
聚焦人工智能核心前沿赛道,锚定定义下一代智能边界的关键技术突破,深度探讨AI for Science、AI Simulation、Sovereign AI、Causal AI、Quantum AI等领域
by 杨祥辉
腾讯
资深技术专家3D资产是游戏、影视、工业设计等数字内容产业的刚需,但传统3D建模存在门槛高、周期长(单模型平均7天)、成本昂贵(百元至万元)的核心痛点。腾讯混元3D生成大模型致力于通过AIGC技术重塑3D内容生产管线。本次演讲将深度解析我们如何通过三大核心技术突破实现SOTA效果:
- 几何生成:引入3D-DiT分级模型,人脸与复杂几何精度相比上一代大幅提升;
- 纹理生成:搭建业界首个多视图PBR生成框架,实现4K超清材质生成与编辑,视觉效果胜出率超70%;
- 美术级生成:自研智能拓扑算法PolyGen,业界首次达到游戏美术标准,生成模型面数可达2万+,布线规整。
演讲提纲:
- 引言:3D AIGC 的机遇与工业级挑战
- 3D内容的稀缺性与生产瓶颈数据分析
- 从“能生成”到“好用、可用、可落地”的鸿沟:精度、可控性、美术规范
- 核心突破一:超高清 3D 几何生成的架构演进
- 数据瓶颈:如何构建支持超高分辨率的3D数据管线?
- 表征瓶颈:高效稀疏3D-VAE解码器的设计,如何将解码效率提升、最大Token 数提升?
- 生成瓶颈:3D-DiT模型的设计理念与实现,如何解决整体结构、表面规整与局部细节的优化冲突?
- 核心突破二:面向真实渲染的材质生成
- 从 RGB 贴图到PBR材质:为何这是逼真渲染的必由之路?
- 业界首个多视图PBR生成框架详解:如何端到端建模法线、粗糙度、金属度等多通道?
- 核心突破三:达到游戏美术标准的生成与后处理
- 智能拓扑:自研Mesh表征BPT如何将表征Token压缩74%,支持2万+面数建模
- 组件化生成:业界首个原生3D分割模型(P3-SAM)与多组件Diffusion架构,如何实现高精度自动拆件?
- 踩坑与反思:高精度数据获取、算法效率与质量的权衡、与专业工具的兼容性等实践挑战
听众收益:
-
获得一套完整的工业级3D AIGC技术体系认知:听众将深入了解一个顶级3D生成大模型(混元3D)从技术选型、核心模块创新(几何、纹理、拓扑)到大规模业务落地的全链路设计思路与踩坑经验
-
掌握3D生成领域的关键技术突破与前沿方向:深入理解超高分辨率3D表征、PBR材质生成、符合美术规范的Mesh生成等核心挑战的解决方案,把握从“可用”到“好用”的技术发展趋势,提升在多媒体、游戏、机器人仿真等领域的技术视野与判断力
-
借鉴头部企业的开源与生态建设策略:了解腾讯混元3D如何通过持续开源构建开发者社区、扩大行业影响力的实践,以及如何通过技术开放平台赋能游戏、3D打印、设计等跨行业客户,为技术产品的商业化与生态化运营提供思路
by 吴光亚
得物
算法专家针对得物交易推荐“4大核心场景 + 50余个细分场景”的多层级独特生态,本演讲聚焦大模型时代排序模型的Scaling Up挑战。在剖析业界探索的基础上,重点阐述得物如何构建统一的排序大模型,以应对极致的场景异构性。方案通过跨域联合建模与MoE-Transformer融合架构,系统性解决数据、特征及训练推理难题,实现模型从千万到十亿级的平滑扩展。最终在显著提升推荐精准度的同时,为得物数十个差异化业务场景带来了整体的成本控制与业务增长。
演讲提纲:
- 背景与挑战:推荐排序模型的Scaling Up困境
- 业界突破Scaling Law的探索与启示
- 得物电商多场景排序大模型统一架构设计(数据、特征、模型结构、训练优化、推理优化)
- 落地效果与关键数据(脱敏)
- 总结与展望
听众收益:
- 了解推荐排序模型突破Scaling Law瓶颈的前沿架构:包括MoE、轻量级Transformer、场景自适应建模等,可直接应用于自身业务
- 掌握大规模稀疏模型训练与推理的系统优化技巧:混合半精度、KV Cache、专家并行、INT8量化、结构化剪枝等,学会如何让十亿参数模型在有限资源下稳定运行
- 学习跨场景联合建模的实践经验:若你负责多场景/多任务推荐,可获得样本对齐、特征共享、场景差异建模的具体解法
- 获得效果与成本平衡的决策参考:了解参数规模从千万到十亿的真实收益曲线和资源增量,帮助评估何时投入大模型升级
by 何聪辉
上海人工智能实验室
青年科学家在 LLM 预训练与 RAG 规模化应用的今天,高质量文档数据的获取已成为制约 AI 能力突破的瓶颈。
本次演讲将深度拆解开源文档解析基础设施 MinerU 的演进历程:从基于传统 OCR 与布局检测的 v1 Pipeline 方案,到引入解耦式多模态大模型的 v2.5 架构,再到最新突破性能天花板、纯数据驱动的 v2.5-Pro 范式。
我们将重点分享 MinerU 如何攻克公式识别(UniMERNet)、复杂布局检测(DocLayout-YOLO)及表格解析(OTSL)等核心硬核技术,并首次公开其背后的“数据炼金术”——包含多样性感知采样(DDAS)与跨模型一致性验证(CMCV)在内的三维协同数据引擎。
最后,演讲将展示 AgenticOCR 与扩散并行解码等前沿探索,探讨文档解析如何从“静态提取”转向“动态智能体感知”。
演讲提纲
- 时代背景:文档解析为何成为 AI 的“入场券”?
- 演进脉络:从单一 OCR 任务到智能文档理解(IDP)的跨越。
- 双轮驱动:LLM 预训练对海量高质量知识的渴求 vs RAG 系统对精准检索的刚需。
- 竞争格局:OmniDocBench 时代的百家争鸣与 MinerU 的定位。
- 技术进化论:MinerU 的三个里程碑
- MinerU v1 (Pipeline):
- 核心组件:UniMERNet 公式识别与 DocLayout-YOLO 布局检测
- 工程化落地:四阶段处理流(预处理 -> 解析 -> 后处理 -> 格式转换)
- MinerU 2.5 (Decoupled VLM):
- 架构创新:低分辨率全局布局(Stage I)与原分辨率局部识别(Stage II)的解耦
- 效率突破:解决端到端模型 $$O(N^2$$ token 复杂度难题
- MinerU 2.5-Pro (Data-Centric):
- 核心洞察:架构趋同下,性能瓶颈已转向训练数据的质量与分布
- 数据驱动:同参数规模下的性能飞跃(Overall 92.98 -> 95.69)
- MinerU v1 (Pipeline):
- 算法深潜:攻克文档解析的“三座大山”
- 公式之巅:UniMERNet 百万级数据集与 CDM 视觉级评测指标
- 布局之变:统一 21 类细粒度标签体系与 PageIoU 评估标准
- 表格之困:OTSL 压缩格式(28 -> 5 tokens)与旋转矫正流水线
- 数据炼金术:大规模数据工程的闭环(Pro 版核心)
- 采样逻辑 (DDAS):视觉特征聚类与难度感知采样
- 验证机制 (CMCV):异构模型交叉验证,精准定位模型短板
- 标注闭环:Judge-and-Refine 自动校正与定向专家标注
- 未来探索:迈向 Agent 与 扩散模型
- AgenticOCR:按需动态解析,从“全量扫读”到“智能点读”
- MinerU-Diffusion:基于扩散模型的非自回归解码,实现 3.26x 速度提升
听众收益:
- 以获得一套可直接落地的 RAG 数据清洗管线参考,了解如何处理公式、表格、阅读顺序等“硬骨头”。
- 能够学习到如何构建百万级高质量数据集(UniMER-1M)以及如何设计多模型协同的数据引擎(Data Engine)方法论。
- 通过 MinerU 的演进路线,可以清晰地看到文档解析技术从“拼凑工具库”到“垂直多模态大模型”再到“数据为王”的发展趋势,为企业数字化转型提供技术选型依据。
- 了解到国产开源项目在登顶 GitHub Trending 背后,不仅有工程实现的努力,更有在顶级学术会议(CVPR 2025/2026)上的深度理论创新。
by 贾荣来
快手科技
社区科学部 推荐架构高级专家在当今大数据与人工智能飞速发展的时代,在线 ParameterServer(参数服务器)作为模型推理的核心组件,承担着海量模型参数的存储、更新与同步重任。随着模型规模的持续扩张以及在线请求量的爆炸式增长,传统在线 ParameterServer 逐渐暴露出性能短板。一方面,传统存储引擎在面对高频次的参数读写请求时,存在着数据访问延迟高、并发处理能力不足的问题;另一方面,基于 TCP/IP 协议的网络通信架构,网络带宽利用率低、传输延迟大的问题愈发凸显,成为了在线 ParameterServer 性能提升的又一关键瓶颈。
针对上述挑战,我们的项目团队从存储引擎与网络通信两个核心维度入手,进行了全方位的技术革新。首先是存储引擎的重构,我们通过引入 SIMD 并行计算、内存预取等、按 ttl 分层的精确过期和强制回收方案等技术手段,将存储引擎的极限吞吐提升了 50% 以上;其次,我们通过引入 RDMA 重构了整个通信链路,更是将极限吞吐提升了 270%,同时时延降低到了原来的 1/3。
演讲提纲:
- 大模型时代面临的挑战
- 存储引擎的性能突破
- RDMA 重构通信链路
- 总结与展望
听众收益:
- 掌握参数服务器存储与网络双维度优化实战方法,解决高并发、高时延工程痛点
- 借鉴 RDMA 与存储重构落地经验,实现大模型在线服务吞吐与时延的量化提升
关注主办方(InfoQ)
联系我们
交通指南
上海虹桥祥源希尔顿酒店
Hilton Shanghai Hongqiao
地址:上海市红松东路1116号
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手