清华大学计算机科学博士,上海人工智能实验室青年科学家、数据平台中心负责人。长期深耕高性能计算与人工智能交叉领域,谷歌引用超 1 万次,曾获 ACM 戈登·贝尔奖(超算领域最高奖)、ACL 最佳主题论文奖等国际顶级荣誉。在上海人工智能实验室组建 OpenDataLab 团队,专注于 AI 数据基础设施建设。团队研发的 MinerU 发布一年获 GitHub 6 万星标,调用量超 10 亿次,被 Google、华为、阿里等百家企业采用;所建立的评测基准被 Google Gemini 3 和 OpenAI GPT-5 官方采纳,是其中唯一来自中国团队的成果。
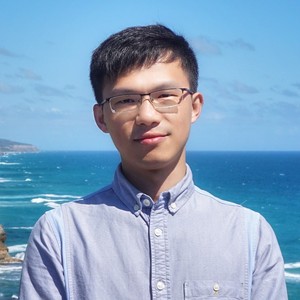
专题演讲嘉宾:何聪辉
上海人工智能实验室青年科学家
by 何聪辉
上海人工智能实验室
青年科学家在 LLM 预训练与 RAG 规模化应用的今天,高质量文档数据的获取已成为制约 AI 能力突破的瓶颈。
本次演讲将深度拆解开源文档解析基础设施 MinerU 的演进历程:从基于传统 OCR 与布局检测的 v1 Pipeline 方案,到引入解耦式多模态大模型的 v2.5 架构,再到最新突破性能天花板、纯数据驱动的 v2.5-Pro 范式。
我们将重点分享 MinerU 如何攻克公式识别(UniMERNet)、复杂布局检测(DocLayout-YOLO)及表格解析(OTSL)等核心硬核技术,并首次公开其背后的“数据炼金术”——包含多样性感知采样(DDAS)与跨模型一致性验证(CMCV)在内的三维协同数据引擎。
最后,演讲将展示 AgenticOCR 与扩散并行解码等前沿探索,探讨文档解析如何从“静态提取”转向“动态智能体感知”。
演讲提纲
- 时代背景:文档解析为何成为 AI 的“入场券”?
- 演进脉络:从单一 OCR 任务到智能文档理解(IDP)的跨越。
- 双轮驱动:LLM 预训练对海量高质量知识的渴求 vs RAG 系统对精准检索的刚需。
- 竞争格局:OmniDocBench 时代的百家争鸣与 MinerU 的定位。
- 技术进化论:MinerU 的三个里程碑
- MinerU v1 (Pipeline):
- 核心组件:UniMERNet 公式识别与 DocLayout-YOLO 布局检测
- 工程化落地:四阶段处理流(预处理 -> 解析 -> 后处理 -> 格式转换)
- MinerU 2.5 (Decoupled VLM):
- 架构创新:低分辨率全局布局(Stage I)与原分辨率局部识别(Stage II)的解耦
- 效率突破:解决端到端模型 $$O(N^2$$ token 复杂度难题
- MinerU 2.5-Pro (Data-Centric):
- 核心洞察:架构趋同下,性能瓶颈已转向训练数据的质量与分布
- 数据驱动:同参数规模下的性能飞跃(Overall 92.98 -> 95.69)
- MinerU v1 (Pipeline):
- 算法深潜:攻克文档解析的“三座大山”
- 公式之巅:UniMERNet 百万级数据集与 CDM 视觉级评测指标
- 布局之变:统一 21 类细粒度标签体系与 PageIoU 评估标准
- 表格之困:OTSL 压缩格式(28 -> 5 tokens)与旋转矫正流水线
- 数据炼金术:大规模数据工程的闭环(Pro 版核心)
- 采样逻辑 (DDAS):视觉特征聚类与难度感知采样
- 验证机制 (CMCV):异构模型交叉验证,精准定位模型短板
- 标注闭环:Judge-and-Refine 自动校正与定向专家标注
- 未来探索:迈向 Agent 与 扩散模型
- AgenticOCR:按需动态解析,从“全量扫读”到“智能点读”
- MinerU-Diffusion:基于扩散模型的非自回归解码,实现 3.26x 速度提升
听众收益:
- 以获得一套可直接落地的 RAG 数据清洗管线参考,了解如何处理公式、表格、阅读顺序等“硬骨头”。
- 能够学习到如何构建百万级高质量数据集(UniMER-1M)以及如何设计多模型协同的数据引擎(Data Engine)方法论。
- 通过 MinerU 的演进路线,可以清晰地看到文档解析技术从“拼凑工具库”到“垂直多模态大模型”再到“数据为王”的发展趋势,为企业数字化转型提供技术选型依据。
- 了解到国产开源项目在登顶 GitHub Trending 背后,不仅有工程实现的努力,更有在顶级学术会议(CVPR 2025/2026)上的深度理论创新。
关注主办方(InfoQ)


联系我们
交通指南
上海虹桥祥源希尔顿酒店
Hilton Shanghai Hongqiao
地址:上海市红松东路1116号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手