聚焦支撑 Agent 长期运行的状态、记忆与基础设施底座,涵盖 RAG 与长期记... 展开 >
Agent 数据、记忆与运行时基础设施
会议室:祥源宴会厅 西厅出品人:邓亚峰
- Topic 1
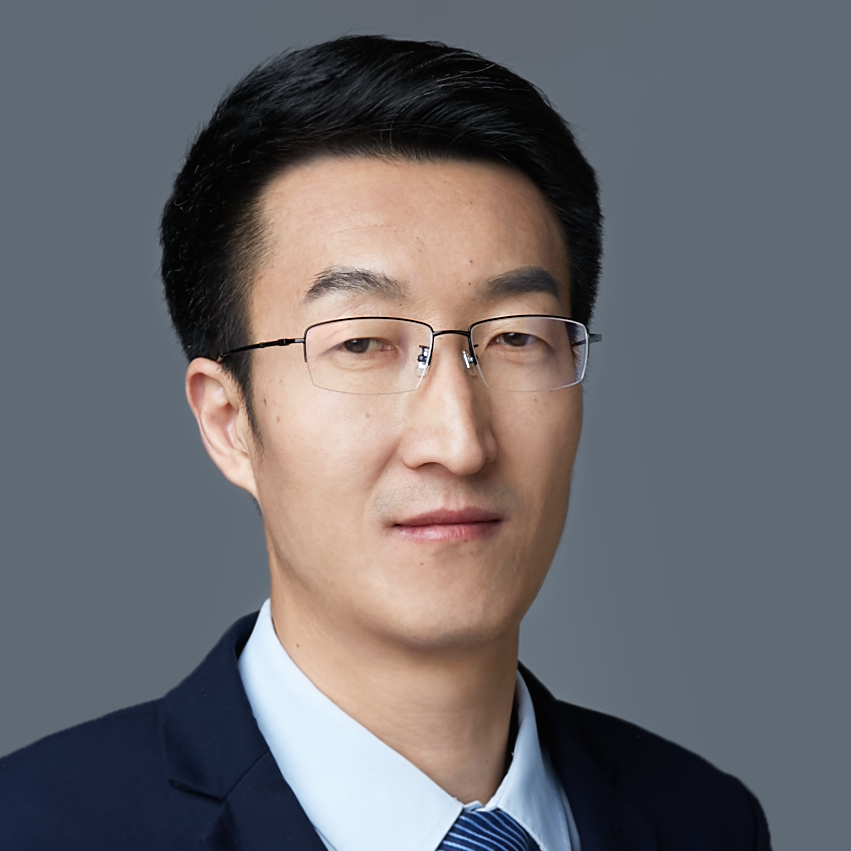
邓亚峰
盛大集团 副总裁 & EverMind CEO - Topic 2
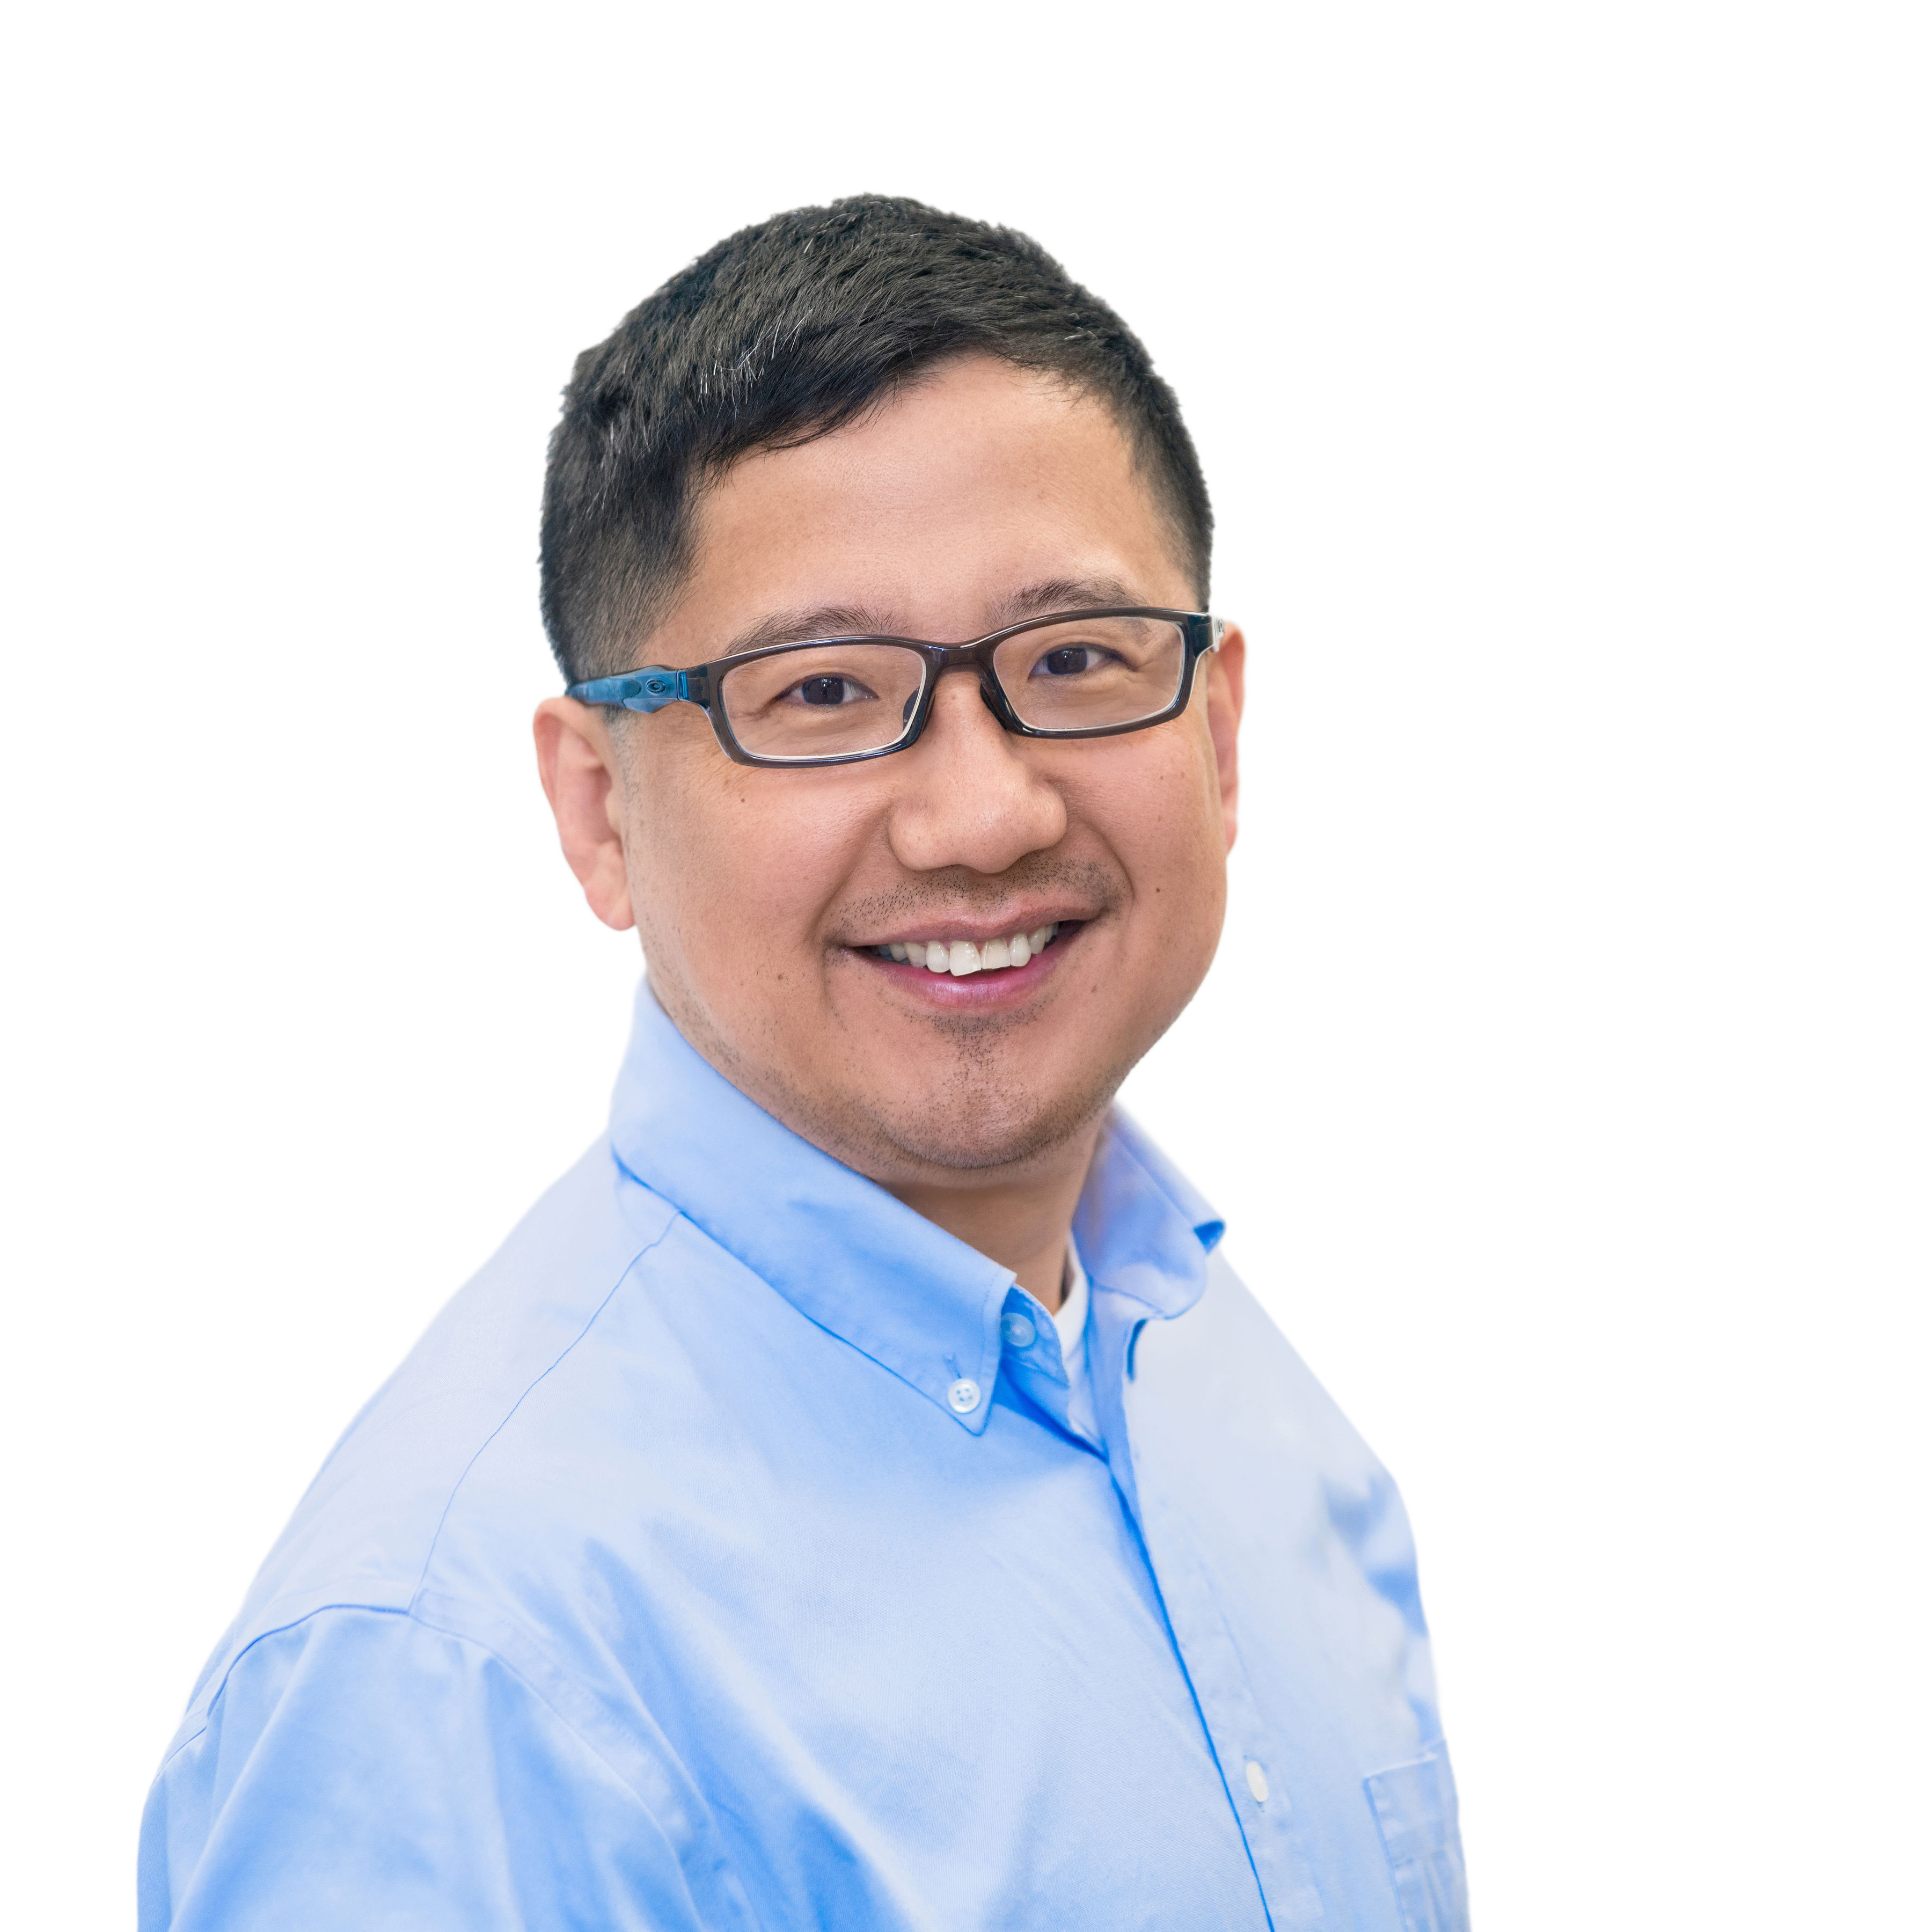
范承工
MemVerge 联合创始人&CEO - Topic 3
董仕超
Google Cloud 解决方案架构师 - Topic 4
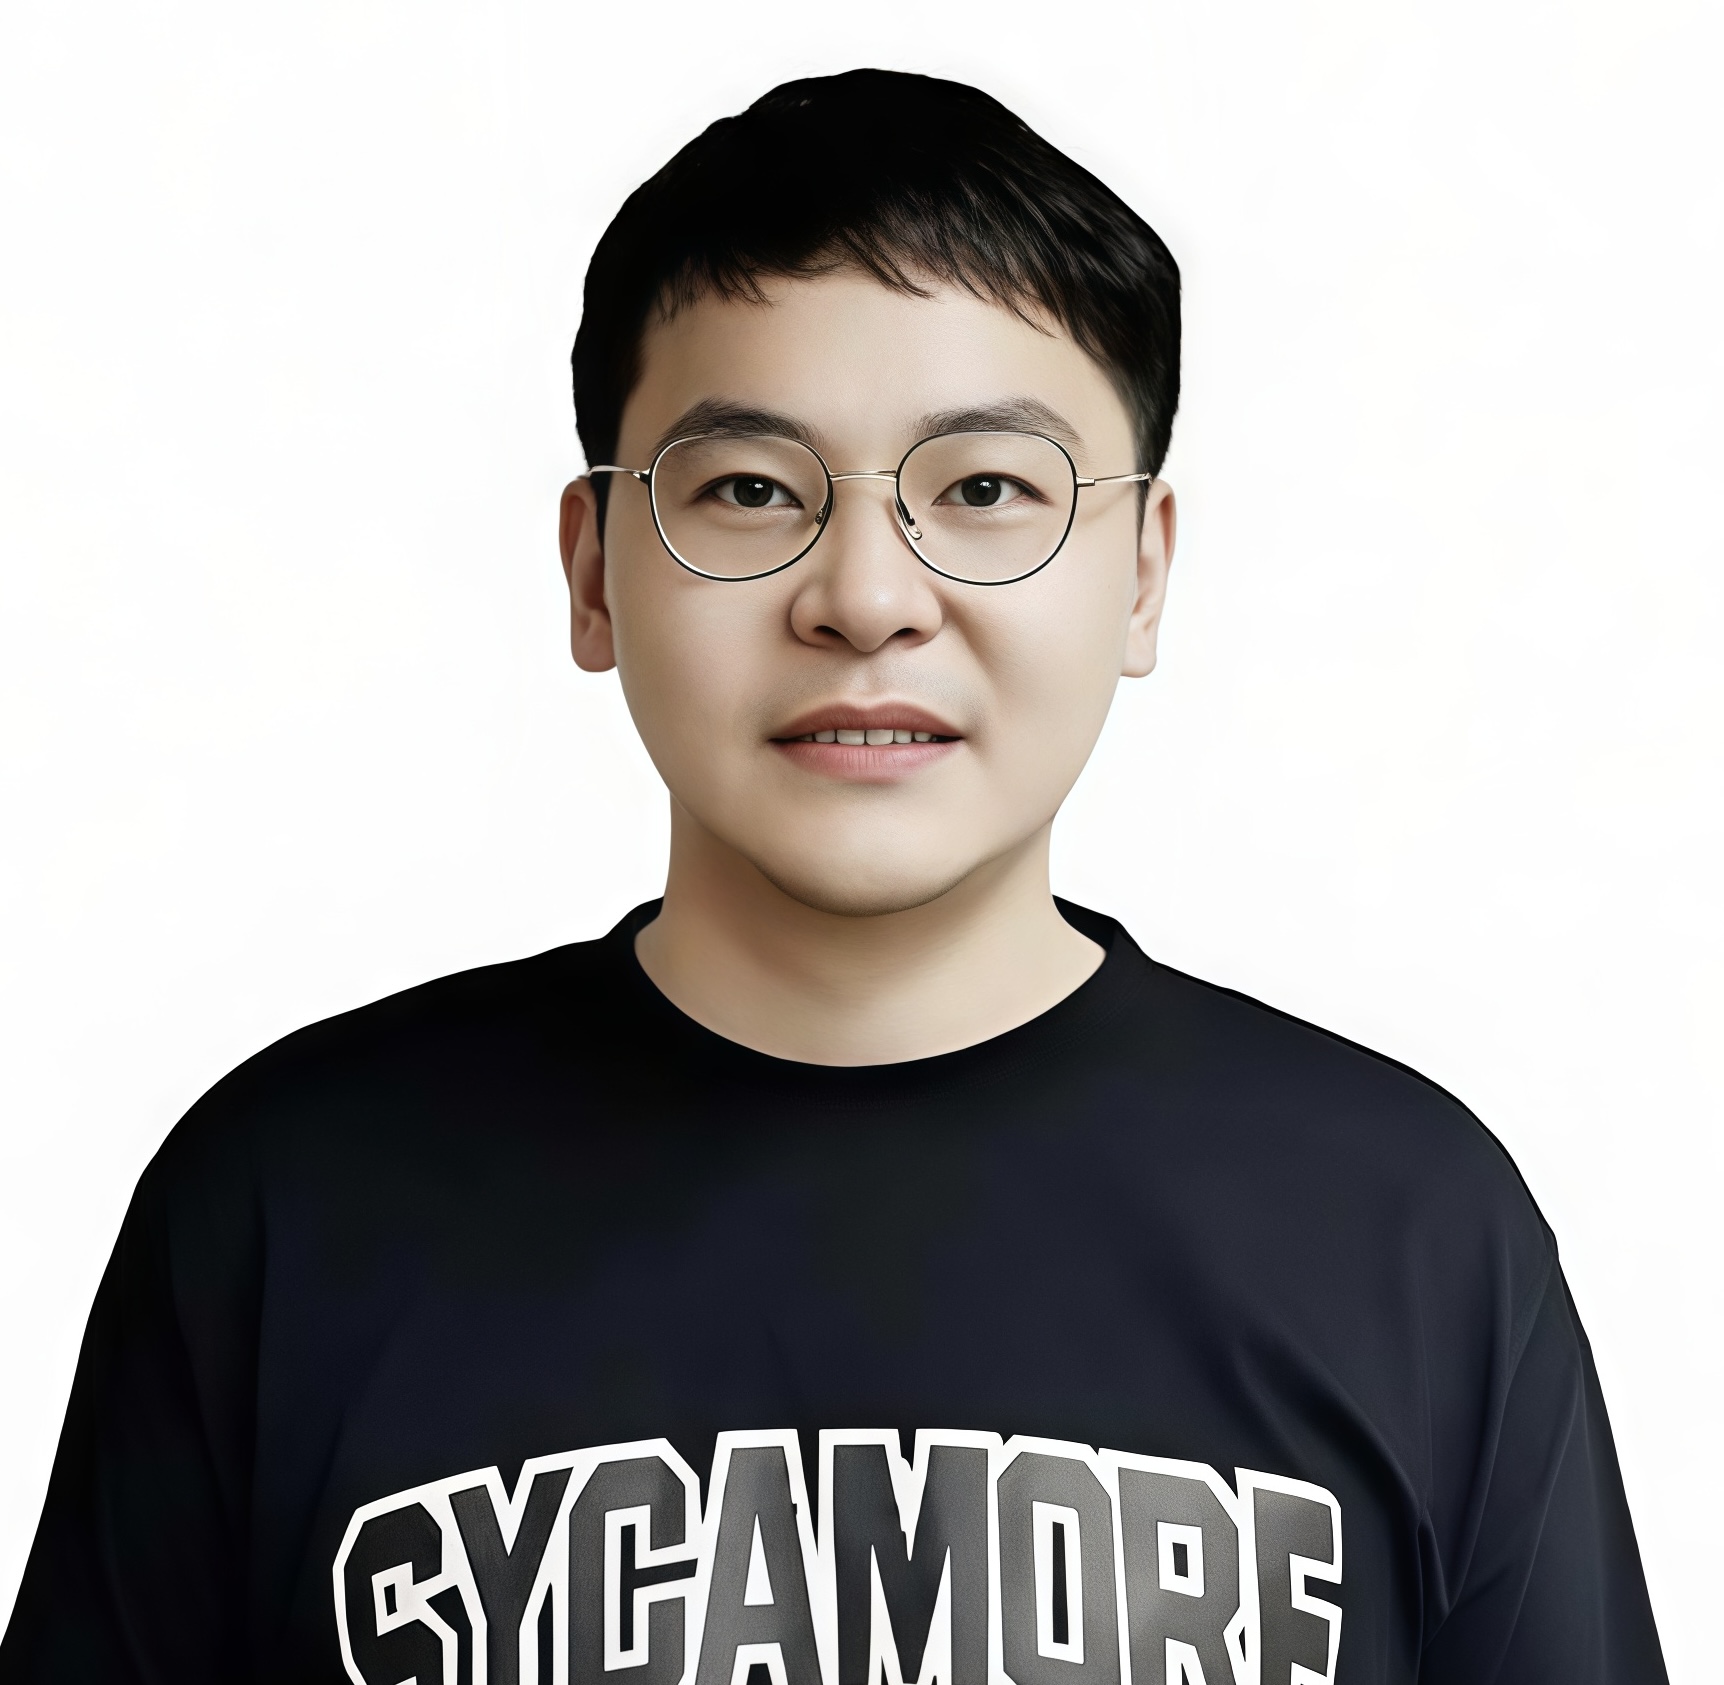
王闯闯
OPPO 高级算法工程师 - Topic 5
盛茂家
火山引擎 Viking 团队技术负责人
专题出品人:邓亚峰
盛大集团副总裁 & EverMind CEO
毕业于清华大学,正高级工程师,拥有二十余年人工智能算法及产品研发经验。现任 EverMind CEO 兼盛大集团副总裁。曾任 360 集团副总裁、人工智能研究院院长兼搜索事业部总经理,科创板首家 AI 上市公司格灵深瞳 CTO。荣获 2021 年中国人工智能年度十大风云人物,教育部技术发明奖二等奖。长期致力于大语言模型、计算机视觉及 AI for Science 等领域的研究与应用,带领团队多次在国际国内主流 AI 评测中获得佳绩;累计申请发明专利 160 余项(已授权 98 项),发表论文 50 余篇(含 10 篇 Nature 子刊)。
地点:祥源宴会厅 西厅
专题:Agent 数据、记忆与运行时基础设施
聚焦支撑 Agent 长期运行的状态、记忆与基础设施底座,涵盖 RAG 与长期记忆、上下文工程、企业数据接入、AI 原生数据架构、运行时环境、隔离机制等方向。
by 邓亚峰
盛大集团
副总裁 & EverMind CEO在本 Talk 中,首先会结合 OpenClaw 和近期行业的热点事件,阐述未来 Agent 的发展趋势;其核心认知是,从通用大模型向具备长期记忆和自我演进能力的 Agent 跨越,正是当前最具商业和技术落地价值的深水区。在基础模型蓬勃发展之上,Agent 的核心价值和壁垒将主要取决于长期记忆能力;其次,将递进介绍介绍长期记忆的价值:如何更高效地利用上下文 (Efficiency);如何记住用户偏好 (Alignment);如何形成自我演进 (Evolution);
进一步,结合我们在长期记忆方向所做的主要工作,特别是 EverOS(定位为 AI 时代的长期记忆操作系统) 和 MSA(Memory sparse attention)Model,讲述我们在相关方向取得的技术进展,以及对未来技术发展趋势的认知;最后,将结合具体的案例说明长期记忆的用户价值。
演讲提纲:
- 打破AGI发展认知误区
- 记忆的三重境界
- 降本增效
- 个性对齐
- 自我演进
- 核心技术布局与突破
- 底层基础设施 EverMemOS
- Memory Sparse Attention 架构解析
- 数字助理场景落地
by 范承工
MemVerge
联合创始人&CEO本次演讲围绕《AI 记忆在智能体与人类场景中的核心应用》展开,聚焦独立 AI Memory 记忆系统核心技术与落地实践,全方位拆解这套前沿系统的技术逻辑、场景价值与未来趋势。首先详解系统专属技术架构,梳理其与大模型、AI Agent 的交互接口设计,以及依托图数据库、向量数据库的存储技术,重点解读实现 90% 以上 LoCoMo 准确率的核心关键能力;其次深入剖析各类 AI 记忆场景分类,结合经典智能体实践,分享 OpenClaw 插件的 Token 优化方案,现场演示强记忆技术赋能的典型智能体案例;最后展望个人桌面应用迭代、企业私有化部署落地,以及记忆数据爆发式增长下的共享、长效存储与隐私保护技术,全方位展现 AI 记忆系统的技术突破与产业价值。
演讲提纲:
- 一套独立的AI Memory记忆系统的技术架构
- AI记忆系统和AI大模型,AI Agent之间的架构和交互接口设计
- AI记忆系统与后端的图/向量数据库的记忆存储技术
- AI记忆系统达成90%以上的LoCoMo准确率的关键能力
- 各类记忆的场景剖析以及典型Agent和实践中的价值
- AI记忆的典型分类及各类记忆的经典Agent实践
- OpenClaw记忆插件场景的下的token节省方案
- 剖析和演示一个典型“强记忆”技术场景的智能体实践
- 对AI Memory的技术展望
- AI记忆个人桌面应用的演进
- 企业级AI记忆系统私有化部署能力的落地展望
- AI记忆数据的激增,共享,长期存储和隐私保护技术
听众收益:
- 如何引入一个独立于模型的记忆系统,来提升Agent开发的能力和效率
- 个人用户如何在本地建设自己的个人记忆,来增强自己和AI之间交互的个性化,让AI在长期对话中更加懂你
- 如何在OpenClaw中引入独立的记忆插件,提升响应准确率的同事,大幅降低token消耗
by 董仕超
Google Cloud
解决方案架构师单体大模型常因流程脱轨、幻觉以及动态代码执行的安全隐患,导致企业难以规模化投产。本演讲直击这一痛点,基于开源 ADK 2.0 框架与云原生托管沙箱,深度拆解生产级 Agent 基础设施的真实落地解法。演讲将聚焦三大核心业务场景与技术细节:
- 确定性工作流与人机协同:利用图化编排(DAG)替代线性 Prompt,在信贷审批、资金划拨等高危节点精准触发断点挂起,实现无缝的人工审核接管(HITL);
- 记忆蒸馏与上下文治理:通过长时语义提炼与归档检索,彻底解决长周期跨会话交互中 Token 暴涨与响应时延瓶颈;
- 毫秒级安全运行时:借助内核级隔离与内存快照预热技术,让智能体自主编写的 Python 脚本或数据处理代码,在 <1秒 冷启动的安全云端沙箱中高效执行。
彻底告别脆弱的提示词实验,构建高可靠、高可控的企业级多智能体底座。
演讲提纲:
- 引言:Demo 繁荣与生产环境的“达克效应”
- 开场拷问:为什么我们在本地跑得极好的 Agent Demo,一旦接入真实业务线就会变成灾难?
- 核心痛点:概率引擎与严谨业务的天然矛盾
- 大模型的本质是“基于概率的下一个 Token 预测机器”,而企业生产环境要求的是 100% 的确定性。
- 批判“黑盒式 Prompt 堆砌”:单体大模型加上简单的“请求-响应”循环,在面对高复杂、长链路任务时,必然走向“幻觉”、“跳步”与逻辑失控。
- 引出破局点:从“提示词玄学”走向“智能体软件工程”。我们需要一套真正包含编排、沙箱与治理的基础设施。
- 控制权反转:为什么 Agent 亟需确定性编排?
- 工程迷思:让大模型同时承担“流程控制器”和“内容生成器”,是造成多步任务崩溃的根源。
- 架构解法:图化工作流(Graph-Based Workflows)
- 核心思想(Inversion of Control):将业务的控制流(Control Flow)无情地从大模型手中夺回,交还给传统的代码。让大模型退化为工作流中的一个纯粹的“推理与决策节点”。
- 有向无环图(DAG)的引入:通过 DAG 构建 Agent 的执行路径,约束 AI 只能在预设的逻辑分支中游走,彻底消除“跳步”与无限死循环。
- 运行时状态适配:
- 对比传统无状态微服务,探讨 Agent 在不同场景下的生命周期管理:何时使用用完即走的 Task 模式?何时必须维持长连接的 Singleton(单例)状态?
- 核心深潜:为什么“极速沙箱”是 AI 自动编程的生产刚需?
- 工程挑战:未知代码的“裸奔”恐惧
- 当 Agent 具备了编写与执行代码(如 Python 分析脚本)的能力,我们就面临着灾难级的安全隐患。
- 对比困境:普通 Serverless 启动太慢(破坏流式对话体验);传统 Docker 隔离太弱(极易被 AI 生成的不可信代码进行容器逃逸攻击)。
- 架构演进:打破“安全隔离”与“极致性能”的死锁
- 深度防御:必须采用内核级强隔离沙箱,将 Agent 生成的代码锁死在绝对受控的边界内。
- 看不见的护城河:为什么必须重构状态隔离与权限治理?
- 记忆即状态:超越 Vector DB 的生命周期托管
- 网关级防御与动态治理(Dynamic Gateway & Identity)
- 数据双向防泄漏:企业敏感数据(PII)不能直接喂给模型,模型生成的危险指令也不能直接执行
- 拦截机制:在动态网关层实时拦截提示词注入(Prompt Injection),而非依赖模型自身的对齐能力
- 身份鉴权(Identity):当企业内部署了成百上千个微型 Agent 时,如何通过中心化的身份凭证,防范 Agent 之间的越权调用
听众收益:
- 掌握 Agent 控制流编排方法: 了解图化工作流(Graph-Based Workflows)的架构原理,学习如何通过代码接管控制流来约束大模型的执行路径,从而减少多步任务中的逻辑偏离与执行错误。
- 了解代码自动执行的安全隔离方案: 分析 AI 自动执行未知代码时面临的安全风险(如容器逃逸),并了解如何利用内核级沙箱技术在兼顾执行效率的前提下,建立受控的安全边界。
- 熟悉企业级状态管理与网关治理机制: 了解在多 Agent 环境下,如何通过动态网关实现敏感数据保护与风险指令拦截,以及如何通过中心化身份鉴权
by 王闯闯
OPPO
高级算法工程师用户每天产生大量碎片化内容——截图、语音、视频、文档、多图……如何让 AI 理解这些异构多模态数据,并自动整理成有价值的"记忆"?本次演讲将介绍 OPPO 小布记忆的技术实践:首先,构建端云协同的一键闪记架构,基于自研 AndesVL 多模态大模型实现端侧推理,通过智能任务分流实现 80% 简单场景端侧处理、20% 复杂场景云侧处理;其次,深入讲解多模态理解能力,包括截图/语音/视频/文档/多图等全模态理解、POI/时间/价格等结构化信息提取、Dense Caption 端侧图片理解等;再次,介绍关联记忆与合集归纳的内容聚合方案,实现从碎片到结构化记忆的自动整理;最后,分享流程化算法开发工作流与自动化评测体系的工程实践。
演讲提纲:
- 问题背景:为什么需要全模态记忆整理,为什么难
- 碎片化内容的多模态特性:截图、语音、视频、文档、多图的异构挑战
- 三大核心难点:模态异构理解、跨模态关联、结构化生成
- 用户价值与业务场景:从碎片到有序记忆的产品目标
- 一键闪记整体架构:端云协同的多模态理解框架
- 产品层触发入口:
- 小布记忆(单击/长按/双击)、魔方按键、小布助手(Query/主动/推荐气泡)
- 端侧采集框架(三指上滑/点击交互)、截屏(普通截图/长截图)
- AI流体云(取餐码)、密码本(个人信息)、日历(日程/待办)、相机(大师参数)
- 端侧引擎(基于自研 AndesVL 多模态大模型):
- 采集:图文提取、语音转ASR、视频
- 端侧算法(AIUnit):NER&OCR能力、图片分类和总结、结构化字段、取餐码、账单、大师参数等
- 存储记忆数据
- 云侧服务:
- 内容安全
- 复杂推理任务:复杂订单提取、复杂NER提取、复杂日程待办
- 产品层触发入口:
- 端云任务分流与多模态理解能力
- 分流模块:对输入图文信息进行分析,生成分类标签;根据分类标签进行任务规划
- 简单场景(流量占比 80%):直屏/焦点屏(单屏)+ 手机 + 任务数≤2 + 单标签单实例(如单个订单、单个火车票、单个日程),需同时满足
- 复杂场景(流量占比 20%):分屏/多浮窗/平板,或任务数>2,或多标签分类/多实例信息(如多个日程、多个火车票)
- 多模态理解能力
- 截图理解:11 类场景分类、POI/时间/价格等结构化信息提取、Dense Caption 端侧图片理解
- 语音理解:语音转ASR、意图识别、关键信息提取(语音记-日程待办、语音记-记账)
- 图文理解:结构化提取、日程待办、取餐码、记账、文本-记账分类
- 视频理解:关键帧提取与内容摘要生成
- 文档/多图理解:长文档结构化、多图相册的批量理解
- 多语种 POI 提取:英语、印地语、印尼语场景优化
- 端云结果合并:端侧抽取结果传到云端后处理 → 云侧合成最终结果 → 返回端侧 AIUnit → 流体云服务下游分发
- 分流模块:对输入图文信息进行分析,生成分类标签;根据分类标签进行任务规划
- 内容聚合与智能整理:从碎片到结构化记忆
- 关联记忆:多规则融合召回(标题/实体/标签匹配)+ Rerank + LLM 精排
- 合集归纳:用户手动创建、A标签推荐、洞见推荐三链路统一 → Reranker + Verify 两阶段聚合
- 合集分类与总结:分类 LLM 识别知识/旅行/健康合集 → 自适应摘要模板
- 效果数据:合集创建准确率 83% → 97%,新记忆加入准确率 76% → 95%+
- 工程实践与效果验证
- 流程化算法开发:Model Selection → Prompt Eng(人工+APE)→ Business Benchmark
- 自动化评测体系:LLM-as-a-Judge 的多维度质量保障,badcase 反馈闭环
- 核心效果指标:场景分类准确率、结构化信息提取准召率、合集创建准召率
听众收益:
- 掌握端云任务分流的设计方法:如何定义简单/复杂场景边界,如何通过分类标签生成动态 Prompt,如何在保证效果的同时最大化端侧推理占比(80%流量端侧化)
- 了解全模态理解的技术挑战与解决方案:如何基于自研 AndesVL 多模态大模型构建端侧推理能力,端侧 AIUnit 支持的任务类型(图文-结构化提取、日程待办、取餐码、记账等),以及端侧推理优化策略(Prompt 精简、输出格式优化、图片 resize)
- 掌握内容聚合的双路方案:关联记忆的多规则融合召回 + Rerank + LLM 精排架构,合集归纳的三链路统一 + Reranker/Verify 两阶段聚合方案,以及如何平衡召回率与准确率
- 学习合集分类与自适应总结的实现方法:分类 LLM 如何识别知识/旅行/健康合集,不同垂类如何切换摘要模板,以及如何避免模型幻觉
- 学习 LLM 应用的工程化实践:流程化算法开发工作流(Model Selection → Prompt Eng → Business Benchmark)、自动化评测体系(LLM-as-a-Judge)、badcase 反馈闭环等可直接复用的方法论
by 盛茂家
火山引擎
Viking 团队技术负责人OpenViking 是火山引擎开源的全新上下文数据库,基于 Viking 团队对上下文工程的理解,面向 AI Agents 全新设计,一经推出就得到开源社区的欢迎和积极拥抱,目前已经积累数千人的开源社群和 GitHub 两万+关注量。本演讲将介绍 OpenViking 的孵化过程、架构设计和后续迭代思路,并通过数据和用例介绍其优势和主流用法。
本次的重点包括:1. 深入介绍 OpenViking 在以往的知识和记忆工程中获得了怎样的启发;2. OpenViking 的量化指标测评,以及在不同使用场景下的优势;3. 未来在非结构化数据为中心的上下文工程领域,如何为新一代 AI Agents 工程开发带来怎样的便利。
演讲提纲:
- OpenViking 项目入门介绍
- 项目背景:全新定义的上下文数据库
- 快速开始:用最快的速度部署和使用 OpenViking
- 应用介绍:快速了解 OpenViking 支持的 AI 应用
- OpenViking 设计和演进过程
- 依赖、部署、选型考虑
- 如何以 AI Agents 为中心进行多租户设计
- 记忆系统的迭代
- 知识检索系统的迭代
- OpenViking 应用场景和评估
- 多智能体协作
- 记忆能力
- 知识检索能力
- 代码能力
- 成本和效率
- OpenViking 的未来应用和展望
- OpenViking 服务于 AI 原生团队
- 数字员工及其安全性挑战
听众收益:
- 了解开源项目 OpenViking 上下文数据库的技术内核
- 了解如何基于 OpenViking 构建多 Agents 生产集群
- 了解上下文工程(知识、记忆、技能)的技术选型和评价方法
关注主办方(InfoQ)
联系我们
交通指南
上海虹桥祥源希尔顿酒店
Hilton Shanghai Hongqiao
地址:上海市红松东路1116号
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手