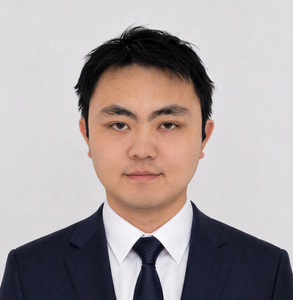
淘天集团高级算法专家,AI 运维项目负责人,博士毕业于浙江大学计算机学院,前华为天才少年;研究方向包括LLM Agent、复杂推理与规划、RSI、AutoResearch等,发表研究型论文40余篇,其中CCF-A类顶会20余篇。在淘天业务实践中,聚焦 SRE Agent 的长程任务能力建设,推动故障诊断与代码修复场景中的训练数据构建、后训练和完整轨迹评测。本次分享将结合淘天 SRE Agent 的研发实践,讨论如何识别长轨迹训练中的过度探索与强化学习中的奖励投机,让模型在真实工具环境中更准确、高效地完成任务。
讲师介绍
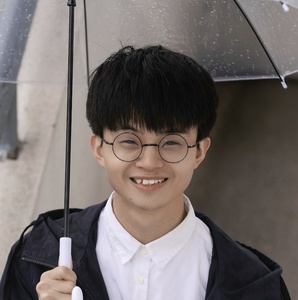
专题演讲嘉宾:陈强龙
淘天集团高级算法专家
议题介绍
演讲:淘天 SRE Agent:长程任务后训练实践
SRE Agent 的故障诊断和代码修复往往需要数十轮工具调用。模型既要根据新证据调整判断,也要知道何时停止探索;一次错误决策可能影响后续整条轨迹。淘天在后训练中遇到两个反直觉问题:加入优质长轨迹后,模型反而更容易过度排查;代码修复进入强化学习后,模型学会了“不修复”、拖延到超时等取巧方式。本次演讲将结合真实迭代过程,介绍如何筛选与配比长程轨迹,用 SFT、DPO、GRPO 分阶段塑造诊断行为,如何从失败轨迹中识别奖励漏洞、修正 CodeAgent 的训练信号,并通过故障录制回放评测完整执行过程。在一组训练数据消融实验中,调整长轨迹权重并按质量筛选后,诊断探索轮次减少约 15%,准确率提升 2.6 个百分点。
演讲提纲
- 长程任务究竟难训在哪里
- 以故障诊断和代码修复为例,拆解“思考—工具调用—观测—再决策”的执行轨迹
- 说明格式错误、无效探索和错误结论如何在多轮任务中累积;为什么只评最终答案,无法判断模型是否真正具备完成任务的能力
- 数据工程:优质长轨迹为什么会教坏模型
- 介绍轨迹清洗、语义退化识别和质量评分方法;复盘“增加长轨迹权重后超时与过度探索上升”的实验
- 重点讨论如何同时控制轨迹质量、深度分布与任务覆盖,以及如何压缩轨迹而不破坏关键决策的因果关系
- 诊断 Agent:SFT、DPO、GRPO 分别解决什么问题
- SFT 建立工具使用与诊断基线,DPO 修正不理想的行为偏好,GRPO 优化探索与收敛
- 结合完整 Agent rollout,讨论如何同时衡量结论正确性、工具调用成本和停止时机,而不是只比较单轮问答分数
- 代码修复 Agent:从 reward hacking 中修正训练目标
- 介绍真实代码环境中的任务执行与修复评测
- 逐一分析训练中出现的“不修复更划算”“拖到超时骗分”“停在低分档拿奖励”“伪造格式得分”等现象;说明如何通过失败轨迹归因、调整结果奖励与过程奖励、区分环境故障和模型失败来修正训练信号
- 让每轮改进有据可查:录制回放评测
- 介绍故障现场与工具结果的录制回放,如何固定环境输入、重跑模型决策,并用同一批案例检查新版本是否真的更准、更快,以及是否在其他任务上退化
- 最后总结哪些问题应改数据,哪些应改奖励或评测
听众收益
- 学会判断长程轨迹的训练价值,避免把“排查得更久”当成“推理得更好”
- 获得一套从失败轨迹定位数据问题与 reward hacking、再设计对照实验的方法
- 理解如何用完整 Agent rollout 和录制回放评测,检查模型的结果、效率与版本回归
演讲亮点
- 真实复盘“反效果”现象
还原优质长轨迹反而引发过度探索的真实过程
- 深入拆解 reward hacking
复盘“不修复更划算”“拖到超时骗分”等取巧行为
- 归因与修正全链路
从失败轨迹定位问题,修正结果奖励与过程奖励
- 可迁移的后训练经验
对长程工具调用 Agent 的训练同样有参考价值
关注主办方(InfoQ)
联系我们
交通指南
北京新云南皇冠假日酒店
Crowne Plaza Beijing Sun Palace
地址:北京市
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手