京东零售高级算法专家,浙江大学本科、香港科技大学博士。2021年加入京东,从事广告智能决策与生成式演进相关工作,覆盖搜索、推荐等场景,持续推进判别式排序、生成式召回及后训练价值对齐。实践围绕大规模广告模型的训练目标优化、偏好与奖励信号构建、兴趣与上下文建模、语义编码及反馈驱动的策略更新展开,关注模型效果、值准、推理延迟与线上稳定性之间的协同。相关工作发表于ICLR、WWW、KDD、SIGIR、AAAI、ICDE等国际会议,并担任多个国际会议审稿人。擅长结合业务约束开展算法设计、工程落地与在线实验验证。
讲师介绍
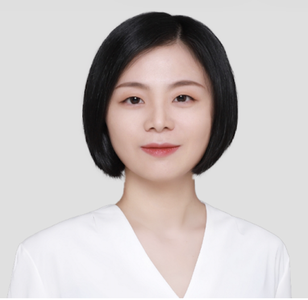
专题演讲嘉宾:刘聪聪
京东零售高级算法专家
议题介绍
演讲:电商广告模型的生成式演进与后训练实践
电商广告模型在规模化过程中面临反馈噪声大、显式偏好难构造、长短期兴趣建模复杂,以及语义共享不足、长期价值难对齐等问题。
本演讲以电商广告为背景,沿判别式增强与端到端生成式两条路径,介绍模型能力如何借助后训练逐步演进。判别式侧,通过偏好优化引入线上经验作为动态参考、用双学习器内部共演化替代外部奖励,并以扩散建模融合长短期兴趣、以生成式上下文理解增强排序表示,兼顾模型效果、值准与推理延迟。生成式侧,围绕自回归商品生成的后训练价值对齐,处理低信噪比反馈下的策略漂移与 Reward Hacking。多项工作在超百亿规模工业数据和多天线上 A/B 中取得点击率、eCPM 等指标的稳定正向。演讲同时讨论后训练方法按反馈可信度的选型逻辑,以及模型与系统的职责边界。
演讲提纲
- 背景与问题
- 电商广告决策链路与规模化后暴露的模型能力瓶颈
- 判别式增强与端到端生成式两条并行路径,及其相互吸收关系
- 判别式模型的后训练增强
- 训练目标优化:以线上已部署模型经验作为动态偏好参考;用独立输出层解耦概率估计与偏好优化,守住 pCTR 值准
- 自进化优化:双学习器共演化产生内部偏好信号,去除外部奖励依赖
- 表示能力增强:条件扩散融合长短期兴趣;生成式上下文理解统一静态、动态、个性化与群体级上下文,排序头仍输出点式概率
- 端到端生成式的后训练价值对齐
- 自回归商品生成的后训练阶段问题:低信噪比反馈、策略分布漂移、Reward Hacking
- 意图感知重采样 + 行为先验锚定,按分布偏移动态调节约束强度
- 方法论与工程实践
- 后训练方法选型:按监督、偏好、奖励信号的可信度与前提条件选择,可信 Evaluator 是首要门槛之一
- 工程代价:推理延迟、更新管线维护、离在线一致性
- 踩坑复盘:多目标权衡、实验反馈泄漏导致对照组被动变强、评估污染导致小流量增益被低估
- 语义编码与长期价值对齐的探索方向、职责边
听众受益
- 判断存量决策系统适合从训练目标、表示能力还是决策接口切入演进,理解判别式增强与端到端生成式的分界和相互吸收关系
- 掌握在提升模型效果时兼顾 pCTR 值准、在线延迟和更新管线维护成本的具体机制与设计取舍
- 获得一套按监督、偏好、奖励信号条件选择后训练方法的框架,并能识别多目标权衡、离在线不一致、实验反馈泄漏与评估污染等实践风险
关注主办方(InfoQ)
联系我们
交通指南
北京新云南皇冠假日酒店
Crowne Plaza Beijing Sun Palace
地址:北京市

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手