通用基础模型具备广泛能力,却未必能稳定完成企业的特定任务。当Prompt、RAG... 展开 >
Post-Training Engineering|数据、奖励与模型能力塑造
会议室:待定出品人:余瑶
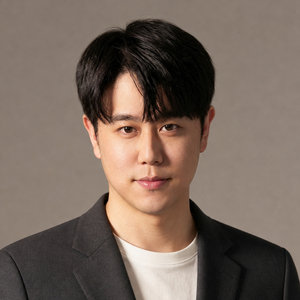
专题出品人:余瑶
飞猪资深算法专家
浙江大学毕业,专注信息检索与电商算法领域。现负责飞猪核心算法平台建设,推动 AI Agent 技术在旅行业务场景的应用与落地。研究方向涵盖 AI Search 在旅行导购场景的算法实践、AutoResearch 的业务化推进,以及旅行垂直领域 Agent 系统搭建与大模型后训练,已发表多项专利与学术论文。
专题出品人:余瑶
飞猪资深算法专家
浙江大学毕业,专注信息检索与电商算法领域。现负责飞猪核心算法平台建设,推动 AI Agent 技术在旅行业务场景的应用与落地。研究方向涵盖 AI Search 在旅行导购场景的算法实践、AutoResearch 的业务化推进,以及旅行垂直领域 Agent 系统搭建与大模型后训练,已发表多项专利与学术论文。
专题:Post-Training Engineering|数据、奖励与模型能力塑造
通用基础模型具备广泛能力,却未必能稳定完成企业的特定任务。当Prompt、RAG和工作流仍无法解决行为一致性、工具使用、复杂推理与任务成功率等问题时,后训练开始成为塑造模型任务能力的重要手段。本专题聚焦任务轨迹与合成数据构建、SFT与偏好优化、RFT与RLVR、Reward Model与模型Grader、Reward Hacking、模型蒸馏及领域小模型,探讨如何建立从数据、奖励、训练到评测、灰度和回滚的工程闭环,并结合真实实践回答:什么时候值得改变模型权重,什么时候更适合使用知识、Prompt、Skill或工作流,以及如何验证后训练带来的能力提升、成本与生产边界。
关注主办方(InfoQ)


联系我们
交通指南
北京新云南皇冠假日酒店
Crowne Plaza Beijing Sun Palace
地址:北京市


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手