郭权玮博士现任语生科学首席科学家、StartLux(原点星辉)联合创始人兼CTO ,负责公司技术战略、核心研发体系及全本地智能解决方案的技术路线与产品化。AI科学公司幻量科技(DeepVerse)前首席算法科学家;曾在台湾工业技术研究院(ITRI)任研发工程师,期间从事数据隐私、数据去标识化与隐私保护机器学习研发。TAAI最佳论文奖获得者(2024);以第一发明人身份拥有数据隐私相关发明专利。
StartLux-Decision 背后的后训练工程:RSI 实践
所属专题:Post-Training Engineering|数据、奖励与模型能力塑造
嘉宾 : 郭权玮 | StartLux 联合创始人兼 CTO、语生科学首席科学家
讲师介绍
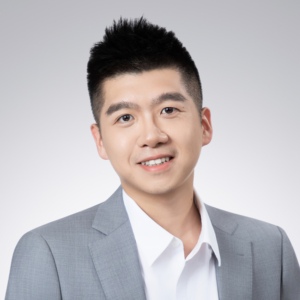
专题演讲嘉宾:郭权玮
StartLux 联合创始人兼 CTO、语生科学首席科学家
议题介绍
演讲:StartLux-Decision 背后的后训练工程:RSI 实践
传统后训练往往依赖研究员反复构造数据、启动训练、跑评测并排查失败样本,研发周期长,实验经验也难以持续复用。本次分享以 StartLux-Decision 为案例,拆解 RSI(Recursive Self-Improvement,递归自我改进)在后训练中的工程实践,将数据构建、SFT、评测、failure mining、数据重构与再训练串成闭环,并让 AI 根据每轮反馈改进数据策略与实验设计。演讲还将结合 StartLux-27B 的 Agent 后训练实践,讨论同一套方法如何迁移到不同能力塑造任务。StartLux-Decision 从方向确定到首轮研发验证约 3 天;其 v1.1 27B Instant 于 2026 年 10 月 16 日以 69.1 分登顶 Decision Index 0.3.2 全球榜单。
演讲提纲:
- 为什么后训练的瓶颈不再只是“训练一次模型”
- 从传统 SFT 流程出发,分析真实模型研发中时间主要消耗在哪里:数据构建、实验设计、训练、评测、失败样本分析与重新训练
- 为什么单次 benchmark 提升并不等于能力真正形成:数据分布、评测过拟合、能力迁移与回归问题
- 将后训练重新定义为持续运行的研究闭环,而不是一次 Training Job
- RSI:让评测反馈驱动后训练持续改进
- RSI 的后训练闭环:目标与边界设定 → 数据构建 → SFT/RL → Eval → Failure Mining → 数据重构 → 再训练 → 再评测
- AI 如何参与实验假设生成、数据生产与筛选、训练任务启动,并依据评测反馈调整下一轮实验
- 人类研究员保留哪些职责:能力目标、评测标准、关键取舍与最终验收
- 如何避免持续迭代陷入 benchmark chasing、数据污染和局部指标优化
- 案例一:StartLux-27B——从失败轨迹中塑造 Agent 能力
- 面向真实工具环境构造 Agent 训练数据,而不是只生成静态问答
- 从任务理解、工具选择、多步执行、结果验证等环节拆解失败轨迹,并将 failure pattern 转化为下一轮训练数据
- 讨论 Think / NoThink、工具调用、Memory 等不同能力之间的耦合,以及如何通过分项 Eval 判断瓶颈到底来自数据、模型还是推理策略
- 展示 RSI 在 Agent 后训练中的实际迭代方式和最终评测结果
- 案例二:StartLux-Decision——如何把生成模型训成决策模型
- 为什么高频 Agent 决策不一定需要生成一段自然语言,而可以直接学习“当前状态 → 候选项概率”的映射
- Choice、Yes/No、Score 等 typed decision 数据如何统一进入训练与评测体系
- 从 state、候选项、目标标签到概率输出,拆解决策能力的数据表示和训练目标
- 如何利用 Eval 与 Failure Mining 找出模型在语言理解、分类检索、工具自动化、知识推理等不同能力上的缺口,并定向重构数据
- 结合 StartLux-Decision v1.1 27B Instant 以 69.1 分登顶 Decision Index 0.3.2 的结果,讨论为什么不能只看总分,还要看能力结构和真实任务表现
- 从两个案例总结一套可复用的后训练方法
- 如何设计一套真正能驱动训练的数据—评测闭环
- 如何把“模型哪里不好”转化成可执行的数据生产任务,而不是依赖研究员凭经验调参
- 哪些环节适合交给 AI,哪些环节仍然必须由研究员控制
- RSI 如何让评测反馈与实验经验持续复用,提高模型研发的实验速度、反馈密度和迭代效率
听众收益:
- 建立一套可落地的 RSI 后训练闭环:理解如何把数据构建、SFT/RL、Eval、Failure Mining、数据重构与再训练连成持续迭代系统
- 学会从评测结果反推训练问题:如何把 benchmark 和真实任务中的失败进一步拆成数据问题、能力问题和训练策略问题,并转化成下一轮实验
- 理解 AI 可以承担哪些模型研发工作:哪些环节适合交给 Agent 自动执行,哪些关键决策仍需要研究员控制,以及如何设计数据、评测和实验基础设施支撑 RSI 的持续迭代
关注主办方(InfoQ)
联系我们
交通指南
北京新云南皇冠假日酒店
Crowne Plaza Beijing Sun Palace
地址:北京市
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手