上下文工程(Context Engineering)是大模型系统中支... 展开 >
Context Engineering
会议室:中华厅 1出品人:栾小凡
- Topic 1
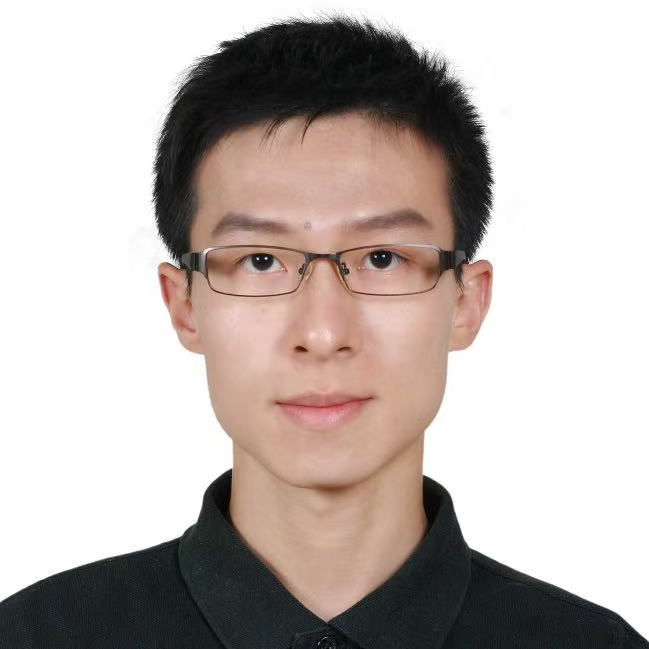
陈斌
金山软件集团 资深研发总监 - Topic 2
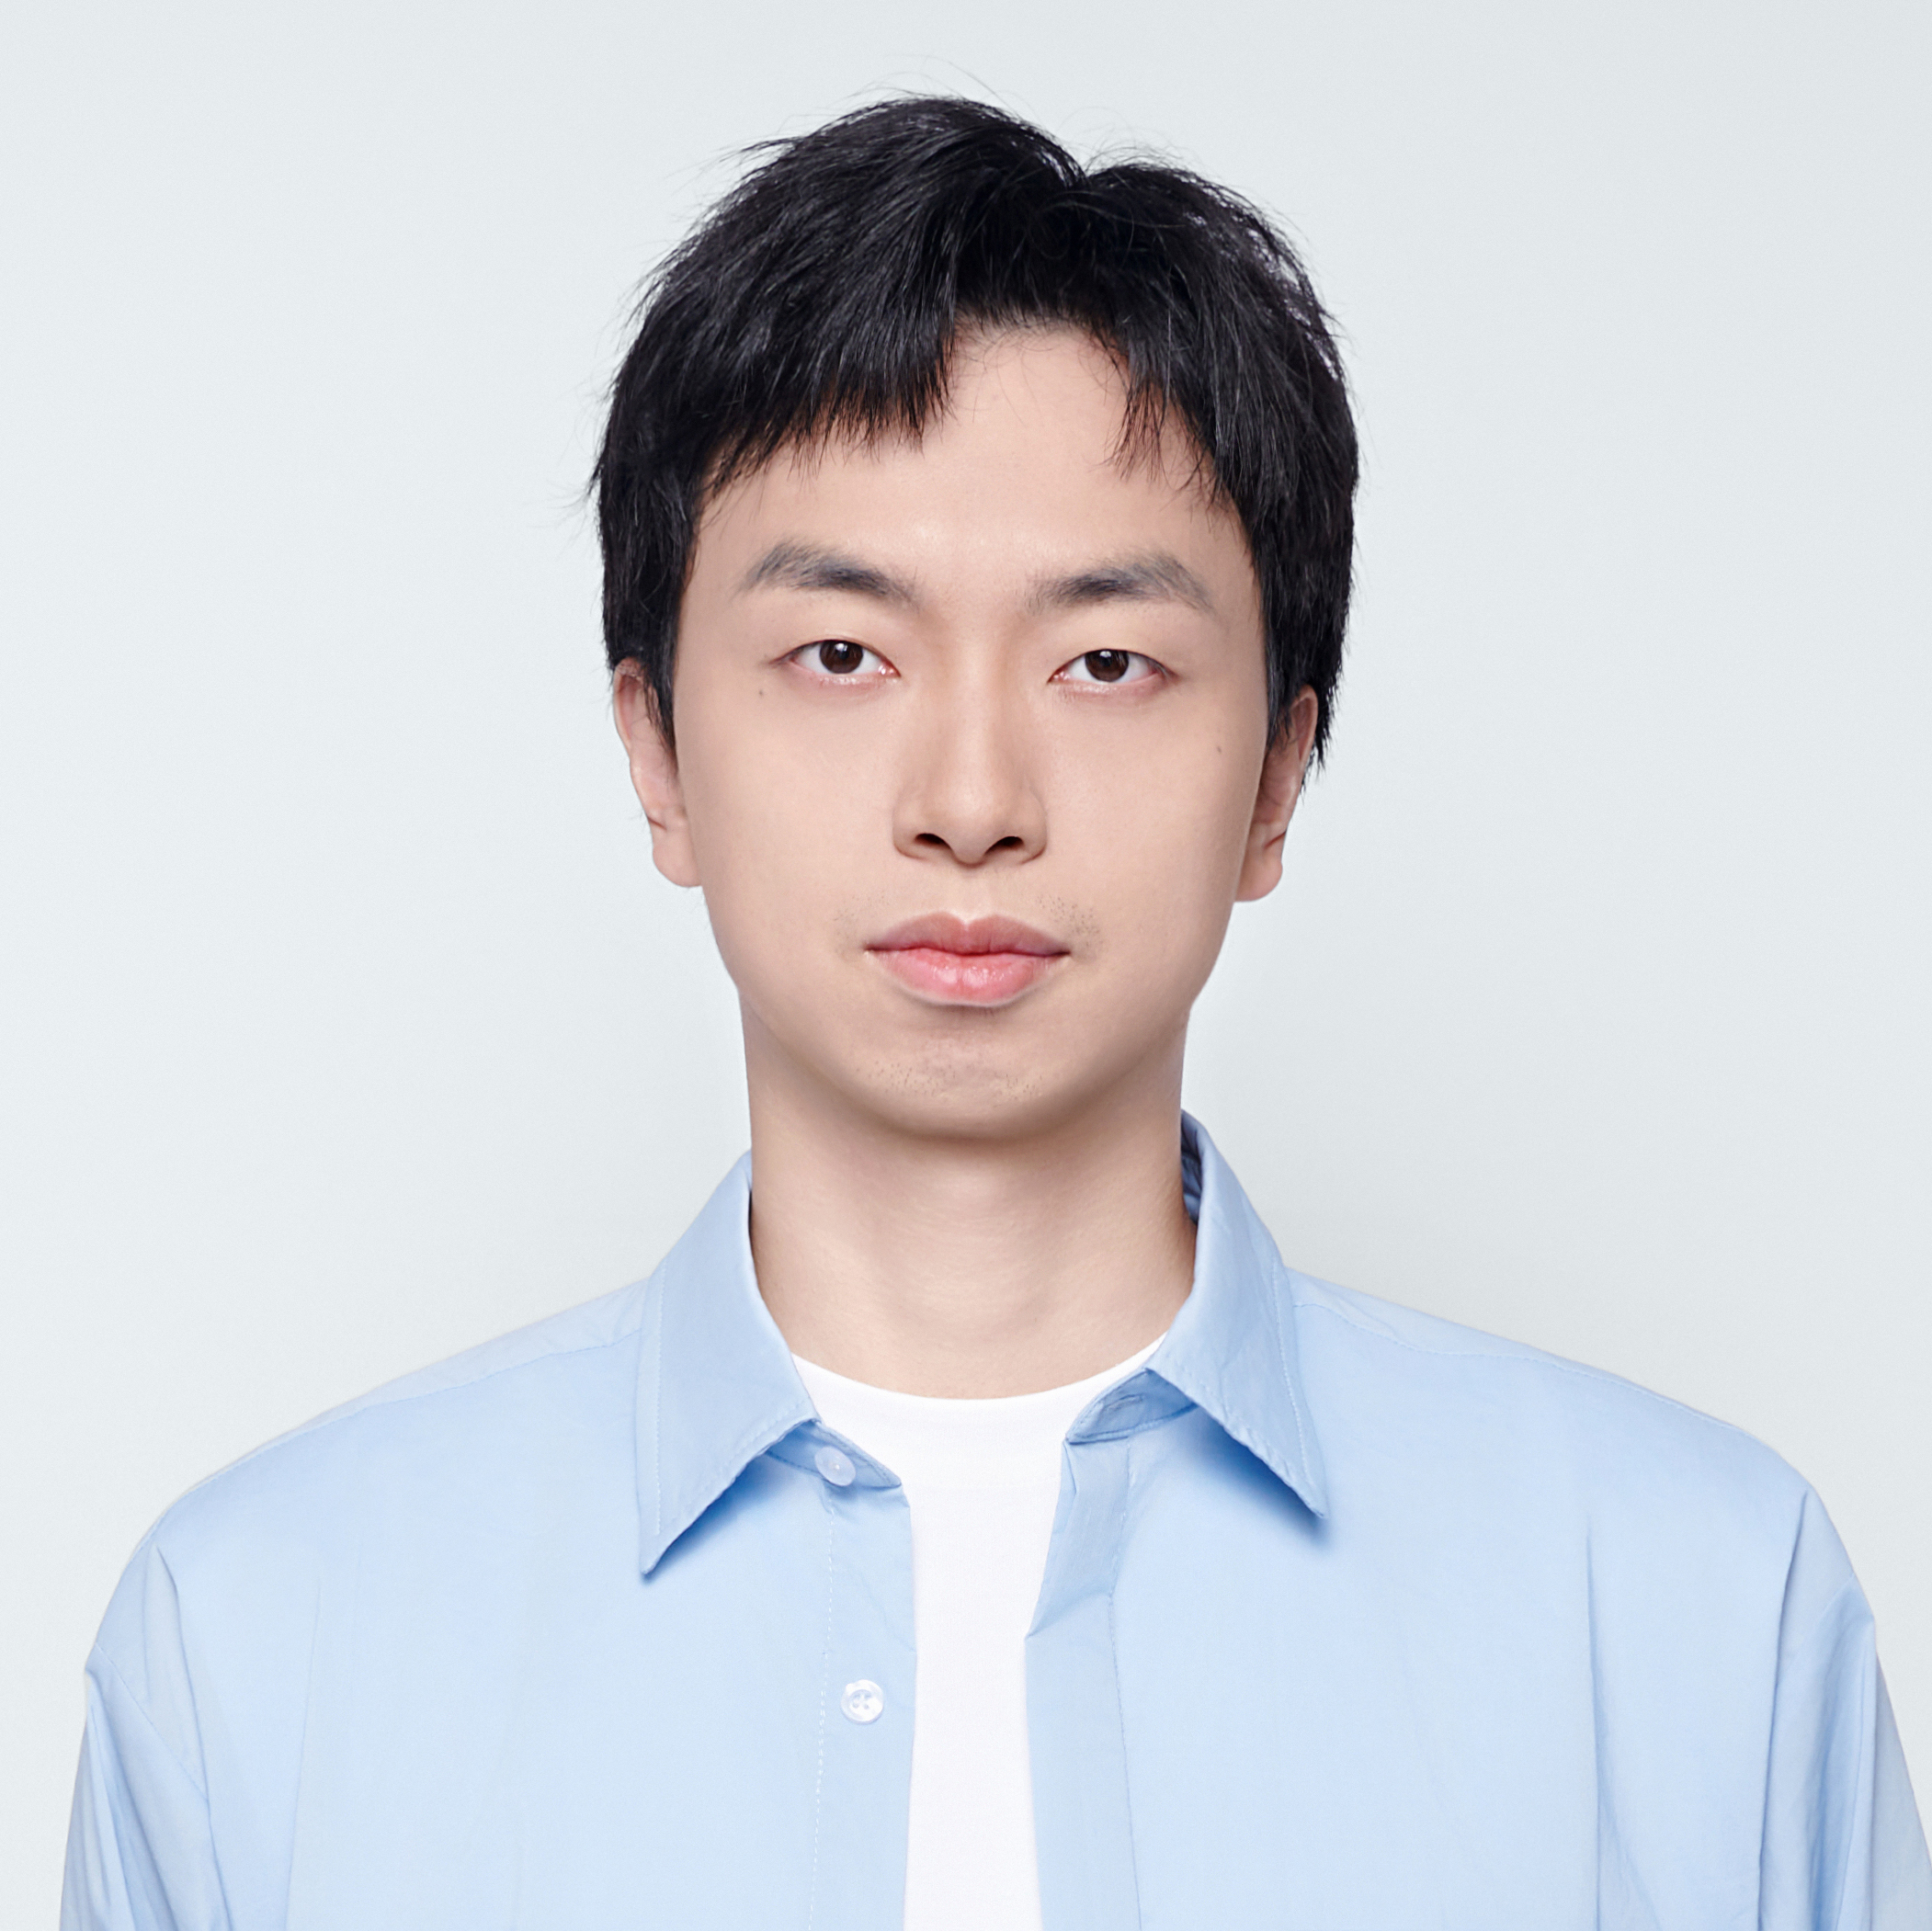
刘力
Zilliz 工程总监 & Milvus负责人 - Topic 3
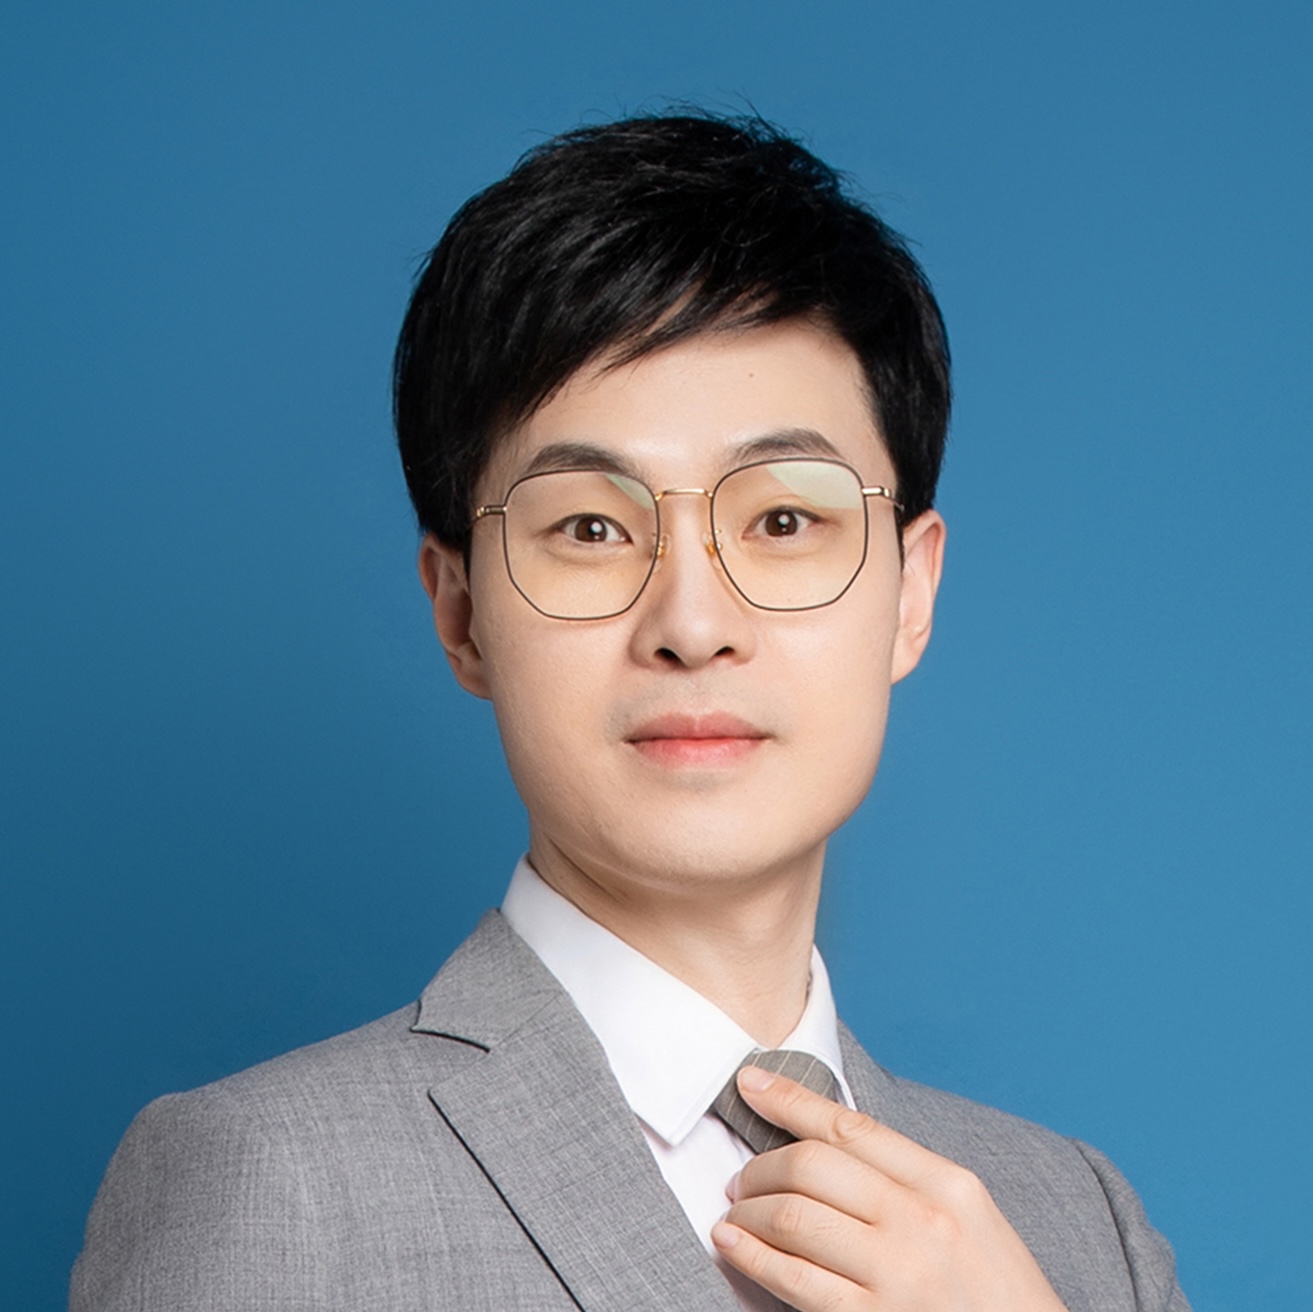
汪晟杰
腾讯 资深技术产品专家 - Topic 4
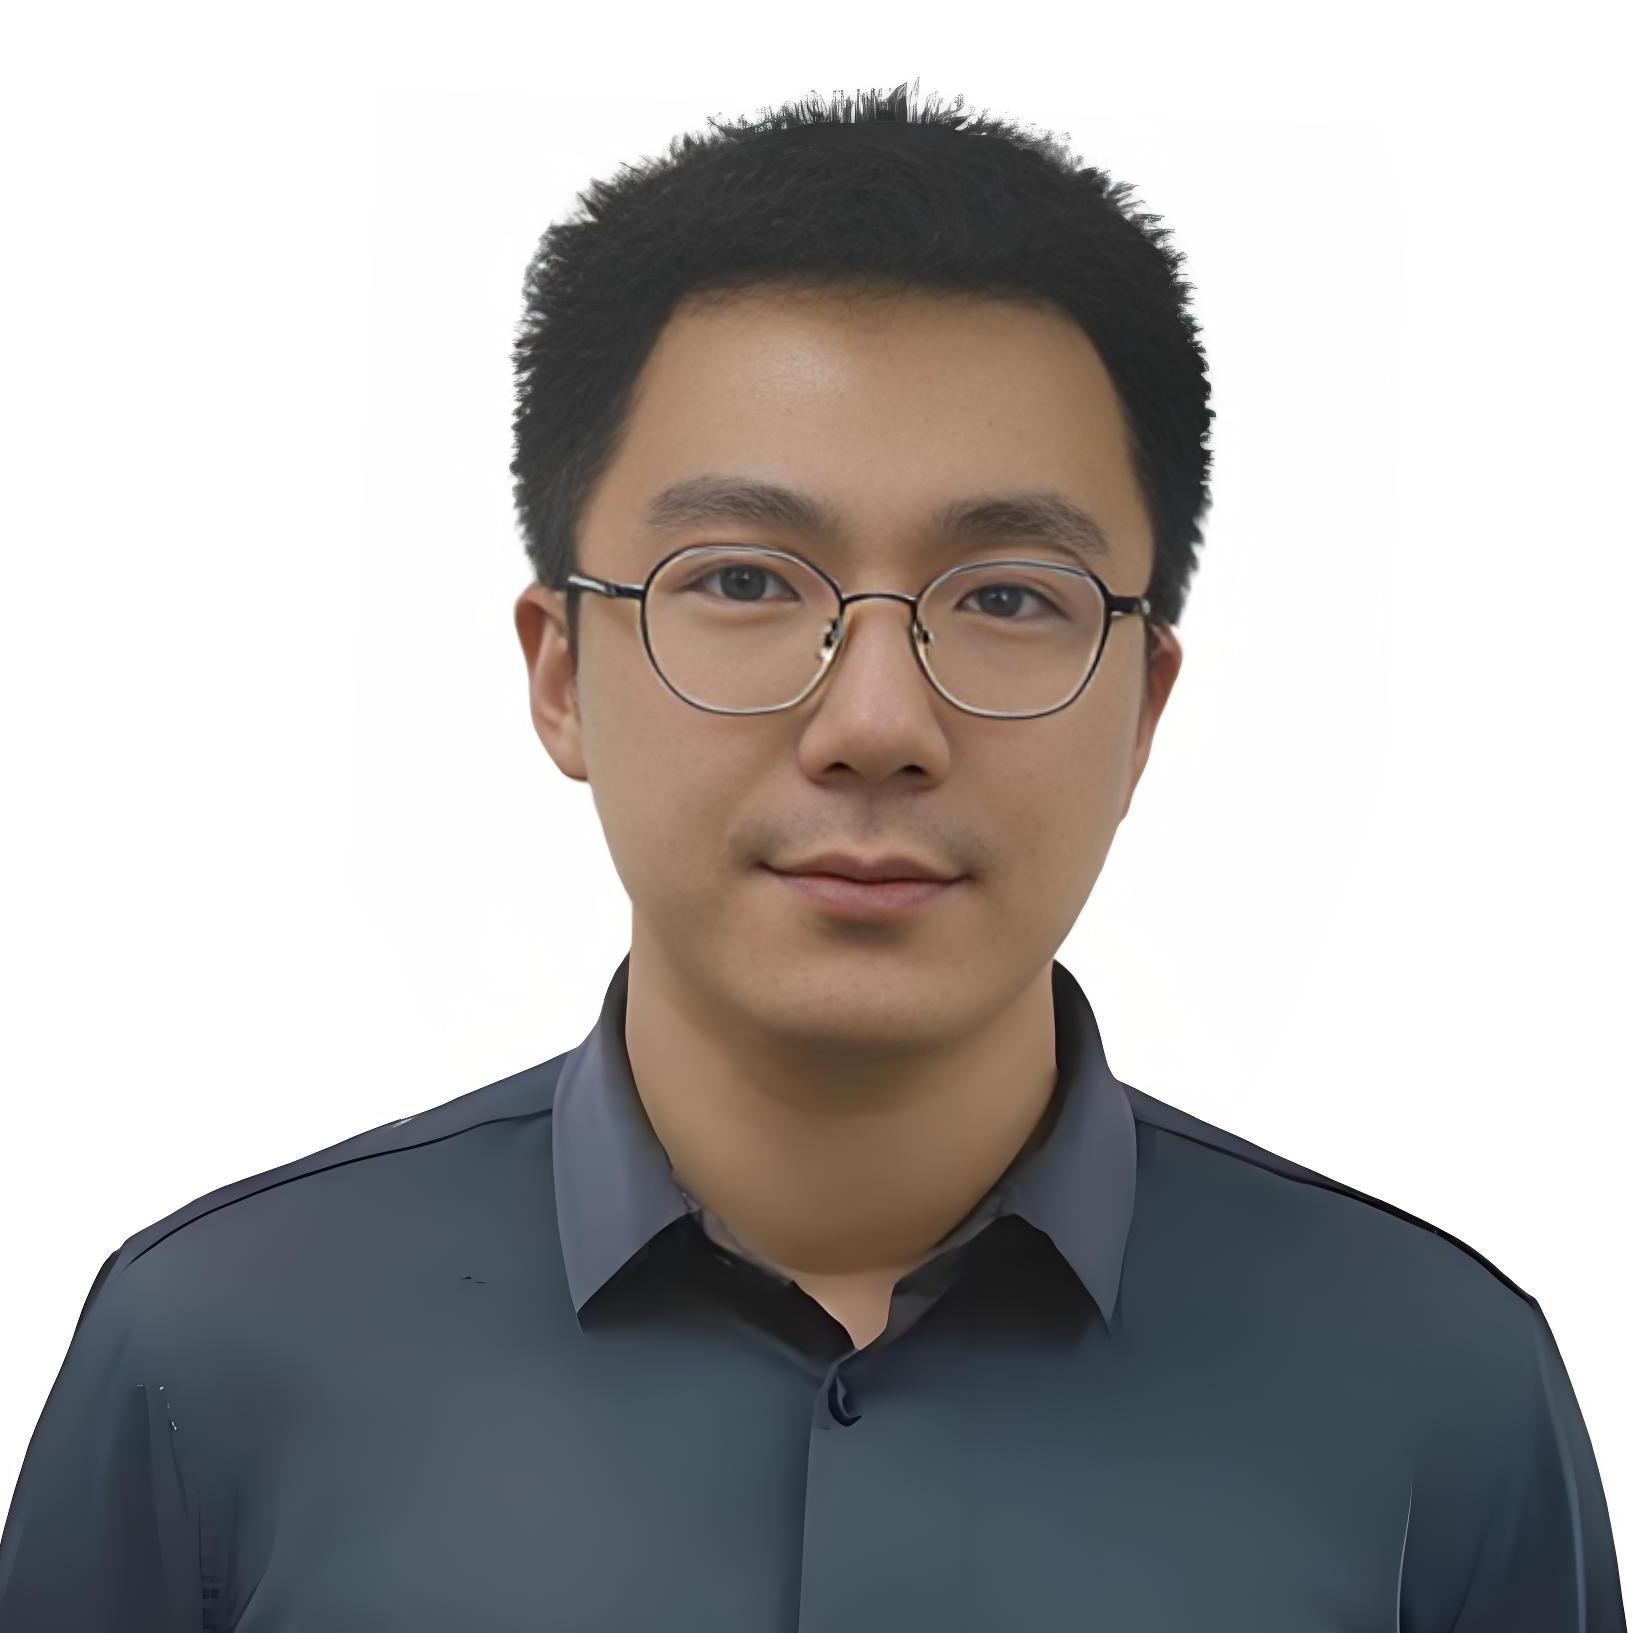
王则远
灵犀量子(北京)医疗科技 总经理
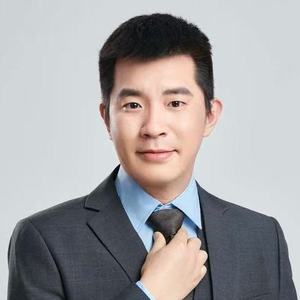
专题出品人:栾小凡
Zilliz 合伙人 & 研发 VP
现任 Zilliz 合伙人兼研发 VP,同时担任 LF AI & Data 基金会技术咨询委员会成员。加入 Zilliz 之前,曾在阿里云担任研发经理,负责 NoSQL 数据库 Lindorm 的研发工作。在此之前,先后在美国甲骨文公司和软件定义存储公司 Hedvig 担任软件工程师。拥有康奈尔大学计算机工程硕士学位。
地点:中华厅 1
专题:Context Engineering
上下文工程(Context Engineering)是大模型系统中支撑理解、推理与决策的核心能力。它不仅是提示工程(Prompt Engineering)的延伸,更融合了知识工程与工具使用,通过对历史对话、外部知识、角色设定与工具反馈的结构化编排,支持 RAG 检索增强、智能问答、多轮对话与 Agent 协作等复杂任务链条的执行与优化。本专题将系统探讨上下文的构建策略、管理机制与压缩调度方法,并结合前沿实践与真实案例,阐述如何借助上下文工程构建可信赖、可扩展、可控的 AI 系统,并展望其未来发展。
by 陈斌
金山软件集团
资深研发总监随着人工智能技术的飞速发展,智能体(Agent)作为信息处理系统,其架构设计与上下文工程正成为实现其可靠性与智能性的核心。本次分享将从信息流转的第一性原理出发,探讨Agent如何通过精细化的记忆系统划分与工程规范,从被动的信息处理器进化为能驱动复杂任务执行的智能力量。结合记忆模块的划分原理与流转关系,分享构建高效Agent系统的关键实践。
演讲提纲:
- 上下文工程的背景
- Agent工作的信息流转
- 外部记忆的规范
- 长短期记忆
- 内部实践
- 总结与展望
听众收益:
- 了解实际业务应用打磨过程中总结的部分上下文经验
by 刘力
Zilliz
工程总监 & Milvus负责人Informational Context 是 Context Engineering 中至关重要的一环,而其核心挑战不在于"多",而在于"准"。为了解决 long context 带来的高成本、低性能和差效果问题,RAG 成为了最不可或缺的技术手段。随着 Context Engineering 场景大规模落地,RAG 也在快速演进。
当下的 AI 应用通过超前的体验快速获取用户和数据,再通过离线分析和模型训练将数据转化为壁垒,形成完整的数据生命周期闭环。在这个过程中,RAG 面临的挑战已经从简单的"搜相似"升级为:如何低成本支撑大规模多租户?如何通过复杂搜索策略提升精度?如何处理海量多模态数据?如何与数据生态深度耦合?过去一年里,我们围绕“非结构化数据湖仓一体”持续探索,并在大规模应用中沉淀出一系列可复用的实践与教训。本次分享将对相关关键问题、取舍与解法进行系统梳理。
演讲提纲:
- Context Engineering & RAG
- Context Engineering 的三大类型:Guiding、Informational、Actionable
- Informational Context 的核心矛盾:质量 vs 数量
- RAG 在其中的定位与演进:从向量搜索、GraphRAG 等
- 如何保证 Context 的质而非量
- 过滤搜索、混合搜索(多向量搜索、关键词检索)、ColBERT 等技术思路
- 聚合搜索、迭代式搜索等新式的搜索方法
- Context Engineering 在线场景
- 多租户问题简述,有什么样的挑战
- 如何在写入和查询放大间取得平衡
- 如何在海量数据下平衡性能和成本
- 多租户场景下有怎样的功能需求,该如何满足
- 湖仓一体如何闭环非结构化数据的生命周期
- 非结构化数据的生命周期简述,包括在线服务,Data Mining 和 Model Training
- 场景的需求和技术的挑战,以及如何解决这些的问题
听众收益:
- 理解RAG在新一代AI应用中的核心作用和技术演进趋势
- 掌握通过真实场景总结出的非结构化数据生命周期管理方法
by 汪晟杰
腾讯
资深技术产品专家在信息化快速迭代的背景下,企业级开发普遍面临需求频繁变更、协作断层、效率低下等问题。
本演讲聚焦“上下文工程 2.0”的落地实践,探讨如何通过 Spec-Coding 将“需求→规则→实现”打通为可闭环链路:以场景化上下文为驱动,将需求转化为可执行的规则模板,依托上下文驱动的自动化编排框架与规则化编程,由自动执行引擎自动生成代码与文档,从而降低认知负担,提升一致性与可追溯性。
我将分享基于 SpecKit / OpenSpec 的引擎设计实践,如何将需求拆解为任务、约束与验收标准,构建可复用的工程规则库,并自动分解为实现与测试任务,同时通过 TodoList 引擎、规则库组件化、自动执行计划、多目标优化等机制,增强模型对工程语义的理解,实现高效需求落地与风险控制。
实践数据表明,该方案可使开发周期缩短 30%~50%,显著降低缺陷密度,加快上线响应,并明显提升客户满意度。
演讲提纲:
- Spec-Coding 是什么?
- 一种基于规约(Spec)驱动的智能开发方式
- 将自然语言需求结构化为可执行的规则单元
- CodeBuddy 如何落地上下文工程 2.0
- SpecKit:将需求分解为任务、约束、验收标准
- Rule Engine:执行规约、自动生成代码与测试
- Context Orchestrator:整合多源上下文(代码库、文档、团队沟通)
- 实践路径
- 从需求收集 → Spec 编写 → 自动任务拆解 → 代码生成 → 测试验证
- 每个环节都可由 AI 智能体自动执行或半自动协作完成
听众收益:
- 掌握“上下文工程 2.0”在复杂企业环境中的落地方法
- 学会在规则化编程与执行引擎设计中的关键取舍
by 王则远
灵犀量子(北京)医疗科技
总经理在“科学智能”范式下,构建能够模拟人类科学家进行复杂探索与创新的通用智能体(AI Scientist)已成为前沿焦点。然而,通用大型语言模型在应用于高度专业化、长周期且充满不确定性的医学研究任务时,面临着知识边界固化、任务规划刚性及过程可靠性不足等核心挑战。
本次分享将介绍一种旨在提升医学 AI 智能体自主进化能力的创新框架。该框架通过引入“模式探索-过程反思”双重机制,将任务执行过程中的隐性知识显性化,并动态构建与优化一个我们称之为“行动手册”的元认知上下文。
此“行动手册”并非静态的知识库和记忆库,而是一个自适应演化的策略集合,它为智能体提供情境感知的行动指导,使其具备从单次任务迭代中学习与泛化的能力。我们将详细阐述该框架的设计哲学、系统架构及其在模拟医学研究任务中的初步实证结果,探讨其如何驱动 AI 从一个被动指令执行器,向一个具备持续学习与自主探索能力的科研伙伴演进。
演讲提纲:
- 医学 AI Scientist 的机遇与研究缺口
- 研究背景: AI for Science 作为科学发现的第四范式
- 研究动机: 通用智能体在医学科研等专家领域的应用瓶颈
- 知识局限性 : 预训练知识的静态性与医学领域知识的动态性、高精度要求之间的矛盾
- 规划脆弱性 : 基于静态思维链的规划在面对科研任务的超长依赖链、高不确定性与动态环境时的失效问题
- 执行不可靠性: 工具调用的语义鸿沟与在关键决策节点上缺乏可验证的置信度
- 核心研究问题: 如何构建一个能够从自身经验中学习、实现能力持续进化的专用智能体
- 核心框架:基于动态上下文的自主进化机制
- 理论基础: 从“In-Context Learning”到“In-Task Learning”的范式演进
- 静态上下文的局限: 一次性信息注入无法捕捉任务执行过程中的时序依赖与情境变化
- 动态上下文的必要性: 建立一个随任务进程自适应更新的上下文,以实现更精细化的决策引导
- “行动手册”:一种元认知上下文的实现
- 定义: 一个结构化的、动态演化的策略知识库,编码了关于“如何成功执行任务”的元知识,包括但不限于:高效工具调用序列、问题分解策略、失败归因模式及验证启发式规则
- “模式探索-过程反思” 双循环引擎
- 模式探索:在线机制,于任务执行中通过算法(如序列模式挖掘)识别并泛化高价值的行动模式
- 过程反思: 离线机制,在任务终止后,对完整的执行轨迹进行因果归因,特别是针对失败或次优路径,生成可操作的修正策略
- 闭环学习: PE-PR 模块的输出被整合并更新至“行动手册”,形成一个持续自我完善的学习闭环
- 理论基础: 从“In-Context Learning”到“In-Task Learning”的范式演进
- 系统架构与算法实现
- 分层智能体架构: “元控制器-规划器-执行器-反思器”四层模型
- 规划器的动态重规划能力
- 自适应重规划: 在执行节点上,依据环境反馈与“行动手册”的实时建议,进行局部路径的动态调整与剪枝
- 分层规划结合初始“行动手册”生成宏观任务图
- 执行器的工具接地
- 超越 API 调用: 训练模型理解工具的先决条件、副作用及参数的语义含义,实现从“Tool Invocation”到“Tool Manipulation”的转变
- 策略驱动的 工具选择: “行动手册”为工具组合提供贝叶斯优化或强化学习策略,以替代启发式选择
- 反思器的知识蒸馏
- 从日志到洞察: 利用大模型自身的推理能力,将低阶的执行日志抽象为高阶的策略规则
- 知识表示与泛化: 探讨如何以符号化或向量化形式存储“行动手册”中的知识,以平衡其可解释性、泛化能力与检索效率
- 实证案例
- 实验、评估与挑战
- 评估范式
- 结果导向 vs. 过程导向: 提出面向过程的评估指标,如规划修正率、无效操作率、反思有效性等,以补充结果成功率的不足
- 当前挑战与开放问题:
- 知识的稳定性-可塑性困境:如何在持续学习新策略的同时,避免对已验证的旧策略造成灾难性遗忘
- 计算开销与性能的权衡: “反思”过程的计算复杂性及其对智能体响应延迟的影响
- 人机协同的干预策略设计:如何在智能体的自主进化环路中,设计高效、可信的专家知识注入与干预策略,实现人机知识的协同进化
- 评估范式
- 总结与展望
听众收益:
- 了解动态演化的上下文工程是如何进展的?
关注主办方(InfoQ)
联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Realm Beijing
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手