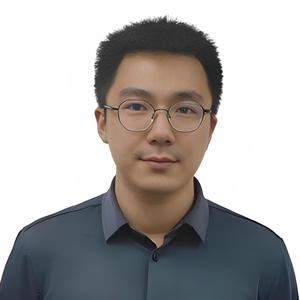
澳大利亚悉尼大学计算机博士、智能医学中心研究员,北京市亦城优秀人才,北京市科学技术委员会科技项目审评专家,高级工程师(副高),专注于机器学习和自然语言处理在医学领域的应用。任灵犀医疗创始人&CEO,中国新闻文化促进会数字健康专业委员会理事,2023年入选胡润U30中国创业先锋榜,曾任辉瑞(美国)全球研发中心高级研究员、AT&T贝尔实验室研究员。先后主持研发了20余个基于人工智能的多模态医学决策平台,累计发表SCI文章20余篇(累计影响因子>150分),国家发明专利40余项、软件著作权10余项,承担科技部重点研发计划课题、国家自然科学基金项目和北京市、上海市自然科学基金项目10余项。
讲师介绍
议题介绍
地点:中华厅 1
所属专题:Context Engineering
演讲:AI Scientist 中的上下文动态优化与自我演进
在“科学智能”范式下,构建能够模拟人类科学家进行复杂探索与创新的通用智能体(AI Scientist)已成为前沿焦点。然而,通用大型语言模型在应用于高度专业化、长周期且充满不确定性的医学研究任务时,面临着知识边界固化、任务规划刚性及过程可靠性不足等核心挑战。
本次分享将介绍一种旨在提升医学 AI 智能体自主进化能力的创新框架。该框架通过引入“模式探索-过程反思”双重机制,将任务执行过程中的隐性知识显性化,并动态构建与优化一个我们称之为“行动手册”的元认知上下文。
此“行动手册”并非静态的知识库和记忆库,而是一个自适应演化的策略集合,它为智能体提供情境感知的行动指导,使其具备从单次任务迭代中学习与泛化的能力。我们将详细阐述该框架的设计哲学、系统架构及其在模拟医学研究任务中的初步实证结果,探讨其如何驱动 AI 从一个被动指令执行器,向一个具备持续学习与自主探索能力的科研伙伴演进。
演讲提纲:
- 医学 AI Scientist 的机遇与研究缺口
- 研究背景: AI for Science 作为科学发现的第四范式
- 研究动机: 通用智能体在医学科研等专家领域的应用瓶颈
- 知识局限性 : 预训练知识的静态性与医学领域知识的动态性、高精度要求之间的矛盾
- 规划脆弱性 : 基于静态思维链的规划在面对科研任务的超长依赖链、高不确定性与动态环境时的失效问题
- 执行不可靠性: 工具调用的语义鸿沟与在关键决策节点上缺乏可验证的置信度
- 核心研究问题: 如何构建一个能够从自身经验中学习、实现能力持续进化的专用智能体
- 核心框架:基于动态上下文的自主进化机制
- 理论基础: 从“In-Context Learning”到“In-Task Learning”的范式演进
- 静态上下文的局限: 一次性信息注入无法捕捉任务执行过程中的时序依赖与情境变化
- 动态上下文的必要性: 建立一个随任务进程自适应更新的上下文,以实现更精细化的决策引导
- “行动手册”:一种元认知上下文的实现
- 定义: 一个结构化的、动态演化的策略知识库,编码了关于“如何成功执行任务”的元知识,包括但不限于:高效工具调用序列、问题分解策略、失败归因模式及验证启发式规则
- “模式探索-过程反思” 双循环引擎
- 模式探索:在线机制,于任务执行中通过算法(如序列模式挖掘)识别并泛化高价值的行动模式
- 过程反思: 离线机制,在任务终止后,对完整的执行轨迹进行因果归因,特别是针对失败或次优路径,生成可操作的修正策略
- 闭环学习: PE-PR 模块的输出被整合并更新至“行动手册”,形成一个持续自我完善的学习闭环
- 理论基础: 从“In-Context Learning”到“In-Task Learning”的范式演进
- 系统架构与算法实现
- 分层智能体架构: “元控制器-规划器-执行器-反思器”四层模型
- 规划器的动态重规划能力
- 自适应重规划: 在执行节点上,依据环境反馈与“行动手册”的实时建议,进行局部路径的动态调整与剪枝
- 分层规划结合初始“行动手册”生成宏观任务图
- 执行器的工具接地
- 超越 API 调用: 训练模型理解工具的先决条件、副作用及参数的语义含义,实现从“Tool Invocation”到“Tool Manipulation”的转变
- 策略驱动的 工具选择: “行动手册”为工具组合提供贝叶斯优化或强化学习策略,以替代启发式选择
- 反思器的知识蒸馏
- 从日志到洞察: 利用大模型自身的推理能力,将低阶的执行日志抽象为高阶的策略规则
- 知识表示与泛化: 探讨如何以符号化或向量化形式存储“行动手册”中的知识,以平衡其可解释性、泛化能力与检索效率
- 实证案例
- 实验、评估与挑战
- 评估范式
- 结果导向 vs. 过程导向: 提出面向过程的评估指标,如规划修正率、无效操作率、反思有效性等,以补充结果成功率的不足
- 当前挑战与开放问题:
- 知识的稳定性-可塑性困境:如何在持续学习新策略的同时,避免对已验证的旧策略造成灾难性遗忘
- 计算开销与性能的权衡: “反思”过程的计算复杂性及其对智能体响应延迟的影响
- 人机协同的干预策略设计:如何在智能体的自主进化环路中,设计高效、可信的专家知识注入与干预策略,实现人机知识的协同进化
- 评估范式
- 总结与展望
听众收益:
- 了解动态演化的上下文工程是如何进展的?
关注主办方(InfoQ)
联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Realm Beijing
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手