随着大模型从能力探索走向规模化应用,长上下文、多模态交互和 Agent 工作流带... 展开 >
大模型效率工程与 Agent 系统实践
会议室:宴会厅A出品人:鲁浩楠 博士
- Topic 1
庄博涵 博士
浙江大学 百人计划研究员 - Topic 2
康洪文 博士
Clipto.AI 创始人兼 CEO - Topic 3
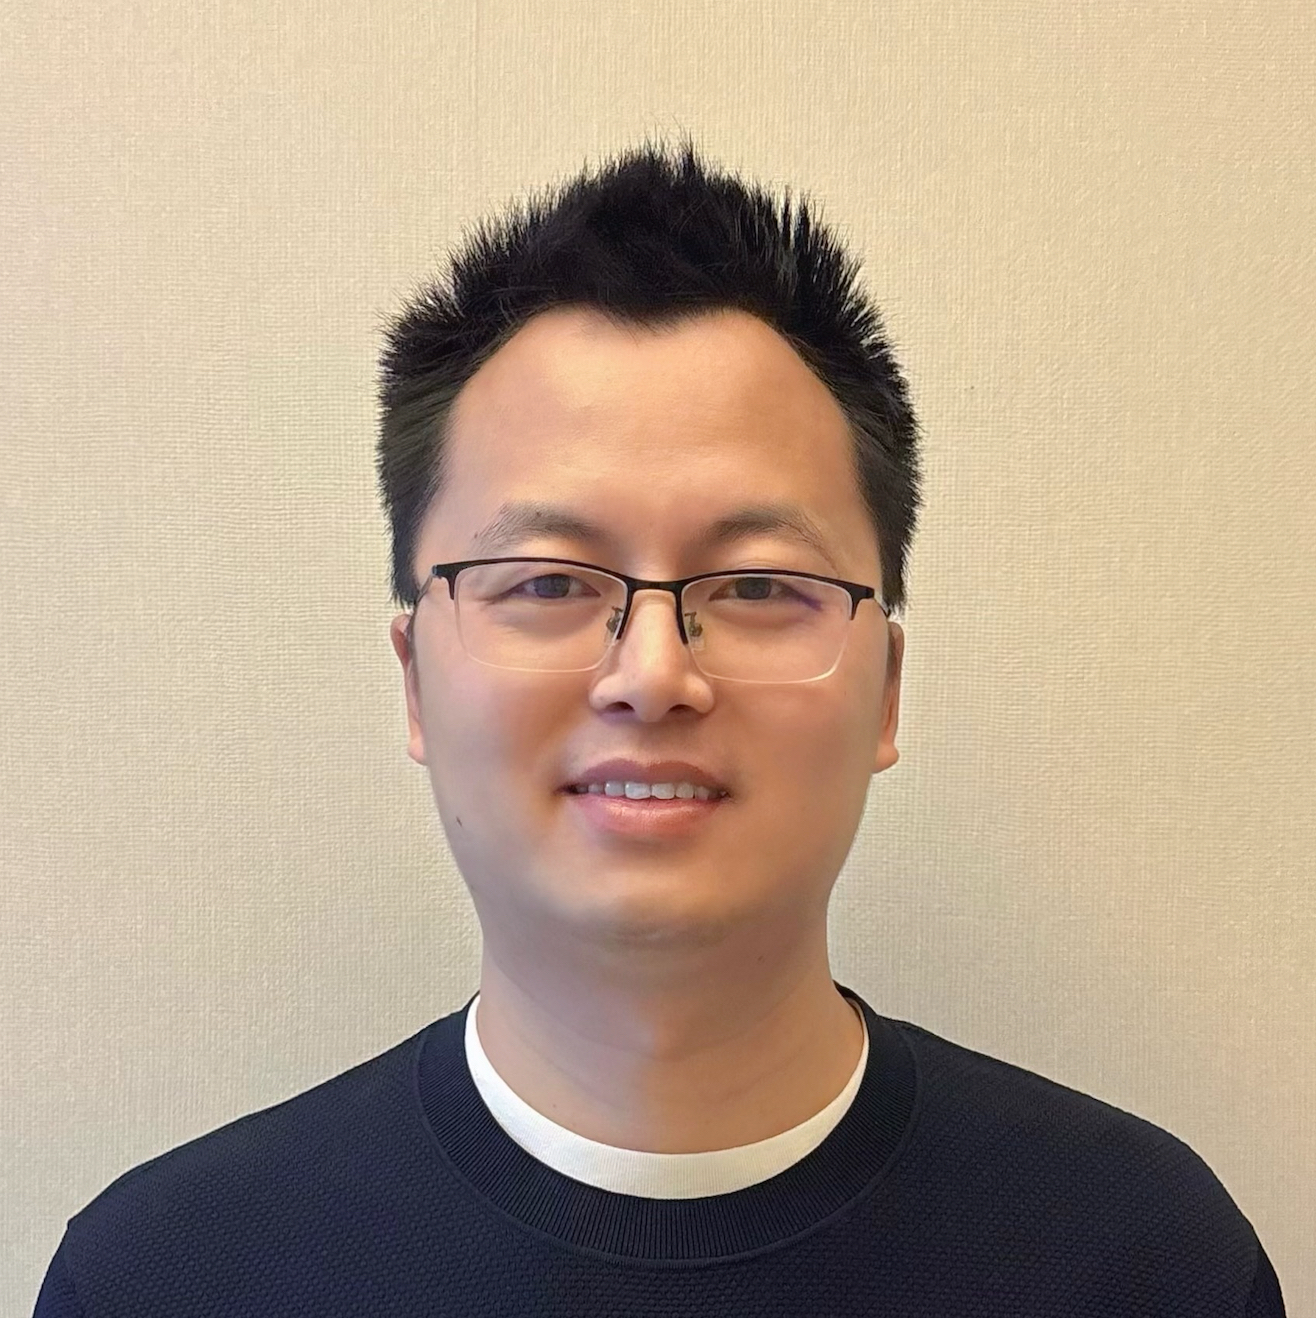
余席宇 博士
OPPO 多模态算法专家 - Topic 4
邱慧
快手 大模型应用算法专家
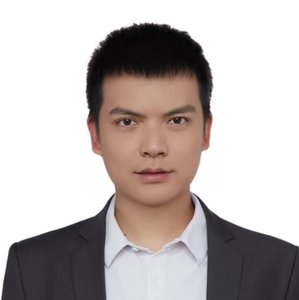
专题出品人:鲁浩楠 博士
OPPO大模型算法负责人
鲁浩楠,现任 OPPO 大模型算法部负责人。本科毕业于中国科学技术大学,博士毕业于香港中文大学,曾任欧洲核子研究中心访问学者、华为高级算法研究员。目前负责公司系统级 AI 产品的端云算法研发工作,致力于多模态理解与生成,AI 智能体系统,大模型轻量化及端侧化等领域的应用交付与算法研究。他带领团队在公司内端云场景中落地多项核心业务,同时也在AAAI、SIGGRAPH、ECCV、ICCV、ACL、NeurIPS、ICLR、ACMMM等高水平国际会议上发表多篇论文。
地点:宴会厅A
专题:大模型效率工程与 Agent 系统实践
随着大模型从能力探索走向规模化应用,长上下文、多模态交互和 Agent 工作流带来了新的性能、成本与工程挑战。本专题聚焦大模型效率工程与 Agent 系统实践,围绕推理优化、上下文管理、模型压缩、智能体运行架构及业务落地等方向,分享算法与系统协同设计经验,探索如何构建高效、可靠、可规模化演进的 AI 系统。
by 庄博涵 博士
浙江大学
百人计划研究员2026 年,多模态大模型正从“被动感知”走向“主动执行”,而不断增长的上下文长度与生成成本,使“效率”成为其规模化落地的核心瓶颈。本次分享围绕面向多模态理解与生成的高效推理,介绍团队在大模型“算法—系统协同设计”上的最新进展:高效注意力方面,覆盖支撑长上下文的稀疏 / 线性注意力;高效记忆方面,介绍基于 KV-cache 压缩与缓存管理的显存优化;高效解码方面,分享近期并行解码策略。在此基础上,串联多模态大模型(Agent)在理解、生成等核心能力上的实践;并进一步简单介绍面向视频生成对齐的高效扩散强化学习,以及在交互式世界模型评测上的探索。最后分享对高效基础模型未来走向的思考,包括agentic loop等。
演讲提纲
- Efficient AI:算法与infra协同设计
- 高效注意力:化解注意力随序列长度二次增长的瓶颈,支撑长上下文理解与长视频生成。
- 高效记忆:通过 KV-cache 压缩与缓存管理,突破长序列推理的显存瓶颈。
- 高效解码:通过并行解码提升推理吞吐、降低生成时延。
- 多模态大模型(Agent)的核心能力:理解与生成
- 理解:在有限算力下高效理解长视频,并支撑空间推理与决策。(场景:空间推理、视频推理)
- 生成:以更低成本实现世界模型生成。(场景:3D世界生成重建,长视频生成)
- 评测:用可诊断的基准牵引世界模型的演进。
- 总结与展望
实践场景说明:
- World Model 推理提速
- 面向游戏,具身等仿真场景,World Model不仅需要生成高质量视频,还需要支持低延迟的实时交互的生成速度,对此,我们团队做了很多工作。
- 在系统层面,我们提出了FPSAttention 针对视频 DiT 的三维注意力进行改进。在 NVIDIA H20 上运行 Wan2.1-14B、生成 720p 视频时,注意力算子最高加速 7.09×,端到端视频生成加速 4.96×,同时保持生成质量基本无损。
- 在算法层面,我们也做了许多工作,其中FlashBlock 在block diffusion范式探索新的缓存机制,在长文本和视频生成实验中实现最高 1.44× token 吞吐提升和 1.6× 注意力耗时降低,并且几乎不影响生成质量。近期的工作Mirage将视频模型的空间记忆保存在潜空间中,使得三维缓存的显存占用降低最高55倍,并且有最高10x的端到端加速,并且在WorldScore上取得了最佳结果。
- 根据我们针对Block Diffusion范式的系统与算法的研究,正在持续整合到我们的统一的框架Inferix,Inferix 进一步提供面向 World Model 的 Block Diffusion 推理引擎,支持 KV-cache 管理、流式视频生成和交互式 world rollout
- Agent loop 里面的效率问题
- 在现在的Agent框架,比如Claude Code,Codex,OpenClaw中,上下文长度正在越积越长,首轮prefill时间和KV cache的显存占用正在不断上升。
- 在系统层面,为了解决上述问题,我们提出了很多工作,比如TriAttention 面向长推理中的 KV-cache 压缩,在 AIME25 的 32K token 生成实验中,在保持与完整注意力相当推理准确率的情况下,实现 2.5× 吞吐提升或 10.7× KV-cache 显存压缩。
- 在算法层面,我们也提出一些加速方案,例如我们探索在Agent任务中进行大小模型协同工作来提高效率。R-Stitch 根据熵来切换大小模型。其在不同尺寸的模型的推理任务上分别实现3-4倍的加速,同时保持接近完整大模型解码的准确率,而Agent-as-a-Router 将模型选择本身设计成 Agent Loop,在2900个编码任务上测试,带router的框架的平均任务得分高于opus的分数,并且成本不到opus的一半。
这样的技术在实践过程中有哪些痛点?
- 效率与质量的权衡问题。稀疏/线性注意力、KV-cache 压缩等手段可显著降本提速,但往往会带来可控但非零的质量损失,且最优适配区间会随任务、模态、序列长度发生漂移,需要投入大量精力调参与验证,无法通过一套配置适配所有场景。
听众收益
- 系统了解面向多模态理解与生成的高效推理全链路方法(稀疏 / 线性注意力、KV-cache 压缩与缓存管理、并行解码)及其算法—系统协同设计思路。
- 了解这些效率技术如何落地到多模态Agent的理解、生成等能力,以及视频生成对齐、世界模型评测的最新实践。
- 获得对高效基础模型未来方向的判断,为自身技术选型与工程落地提供参考。
by 康洪文 博士
Clipto.AI
创始人兼 CEO2026 年上半年,AI 行业出现了一个新共识:模型能力够了,但模型不认识用户。OpenAI / Anthropic / Google 同时上线持久记忆,Letta / Mem0 / Zep / Hark 四家创业公司合计吸金 $110M+——记忆正在从大模型的可选配件,变成独立的基础设施层。与此同时,Apple M 系列芯片、NVIDIA RTX Spark 和 Jetson Thor 的发布,使消费级设备首次具备了本地运行多模态大模型的能力。
本次分享以端侧多模态记忆层的工程实践为主线,拆解模型自研、推理架构重造、知识图谱记忆系统三层技术栈的构建过程,以及在此过程中积累的核心经验——多模型协同调度、异构芯片适配、记忆的结构化存储与语义检索。核心不单讲算法优化,更讲记忆层作为一种新基础设施的工程解法。
演讲提纲
- AI 缺了一层基础设施
- Context Window 的物理极限:百万 token 能塞进去,但塞进去 ≠ 记住。Mem0 的 benchmark 数据:选择性检索 ~7000 token 准确率 91.6%,full-context 方案需要 26000+ token 且分数更低——效率才是瓶颈,不是容量
- Agent 都失忆:每次对话都是重新认识用户,缺跨会话的持久状态。这只是产品体验问题,更深层是一个架构缺失——在 Model 和 Agent 之间,没有一层负责「理解用户」
- 端侧多模态记忆层的工程挑战
- 多模型协同的资源竞争:消费级设备上同时跑 LLM、VLM、ALM、Embedding 四类模型,每一项都在争内存和算力。瓶颈不是单个模型跑不动,是调度策略跟不上——先加载谁、后释放谁、并行度开多少,决策差一档延迟就差数倍
- 多模态数据的联合理解:视频的人物/场景/动作、音频的对话/环境音/情绪、图片的语义——这三种信号在云端有充分的算力预算做独立处理再关联,但在端侧必须共享资源。工程上的核心问题:哪些计算可以复用、哪些必须独立、合并后精度损失多少可接受
- 记忆的结构化 vs 存储的扁平化:文件系统是扁平的,但记忆是结构化的——人物关系会变、偏好会演化、信息有重要和不重要的区别。把多模态数据转化为可推理的知识图谱,本质是一个持续的语义提取和关系维护问题,不是一次性的索引构建
- 全链路协同的长尾效应:模型训练 → 量化压缩 → 芯片适配 → 推理部署 → 记忆构建 → Agent 集成——每个环节的偏差都会向下传导,单点调优往往制造链路瓶颈
- 全栈工程实践:模型 → 推理 → 记忆
- 模型层:自研端侧多模态体系
- 行业现状:开源多模态模型在标准 benchmark 上表现优秀,但在真实业务场景中暴露短板——音频模态对噪音/环境音/非标准语音理解不足,视觉模型缺乏对专业影视语言(景别/机位/运动)的理解
- 自研的临界点:当业务数据积累到数 PB 级,继续依赖开源模型的边际收益递减——模型需要理解的不再是「这是一只猫」,而是「这是第三机位拍摄的中景镜头,人物正在从画面右侧移动到左侧」
- 实践案例:Clipto 自研了超过 10 个端侧模型(LLM / VLM / ALM / 多模态 Embedding),通过跨模态冗余消除和并行解码将总内存占用控制在消费级设备可承受范围内
- 推理层:消费级硬件的架构重造
- 不仅是模型量化:量化(INT4/INT8)解决「模型变小」的问题,但推理效率的瓶颈往往在内存布局、算子融合和任务调度——这些需要从推理框架层重做
- 向下兼容的工程代价:确保 M1 / 8GB 设备可运行完整管线,需要动态内存管理、模型分片加载和优先级调度三管齐下
- 异构芯片适配的技术细节:Apple M 系列 NPU/ANE 的算子支持列表、NVIDIA RTX Spark 和 Jetson Thor 的内存带宽与精度格式——每块芯片的适配工作量远超模型训练本身。关键是建立一套跨芯片的统一调度层,让上层模型不感知底层硬件差异
- 记忆层:从存储到知识系统
- 核心理念:文件系统解决「存什么」,RAG 解决「检索文档」,记忆层解决「理解后记住」——知道什么重要、什么变了、什么和什么有关
- 技术路线:多模态理解(人物/场景/语义/情绪)→ 时序知识图谱(关系演变可追溯,时间维度是关键差异)→ 向量化检索(自然语言 → 意图解析 → 多维定位)→ Memory Agent(基于记忆的对话与推理)
- 与业界方案的对比:Letta 做 memory paging(虚拟内存思路),Mem0 做 memory API(中间件思路),Zep 做 temporal graph(图谱思路)——端侧记忆层的独特性在于,不仅要解决「怎么记」,还要在有限算力下同时解决「看懂」和「记对」
- 模型层:自研端侧多模态体系
- 工程实践中的关键判断与教训
- 2023 年的反共识押注:行业都在抢云端大模型时,基于「端侧算力与模型能力将在 2025-2026 交汇」的判断提前两年布局。这意味着在推理框架、芯片适配、多模态管线的基建上先发,但也意味着要自己趟过生态不成熟期的所有坑
- 什么时候从「调 API」切换到「全栈自研」:不是技术信仰驱动的,是业务数据驱动的——当开源模型在特定模态(含噪音频、长视频理解)的真实表现触碰产品体验底线时,继续依赖外部模型边际收益递减,自研投入陡增但形成长期壁垒
- 模型压缩是一个系统优化问题,不是算法问题:单独做量化掉精度,单独做剪枝可能破坏特定模态理解力,单独做蒸馏可能丢失边缘场景——需要通过 QAT + 稀疏化 + 动态调度的协同设计,在训练阶段一起做
- 记忆层不是升级版 RAG:RAG 从静态文档库检索,默认数据不变;个人记忆是动态的——偏好会变、关系会演化、旧信息会被新信息覆盖。核心能力是时序推理和状态追踪,而不是检索准确率
- 工程化 vs 学术 benchmark 的鸿沟:论文里的端侧推理跑在干净数据集上很漂亮,真实场景中用户数据是异构的、噪声大的、格式乱的——工程化的核心不是刷榜,是极端条件下的鲁棒性
- 核心教训:端侧工程最大的敌人不是算力不够,是管线协同——模型、推理、记忆三层各自优化 10%,凑一起可能负优化。系统效率永远比单点跑分重要。
- 行业对标与工程验证
- 端侧 AI 记忆类产品的行业现状:Rewind.AI 做屏幕录制的本地搜索(capture + retrieval),但理解层较浅;Microsoft Recall 做操作系统级截图记忆,但多模态深度有限;更多工具型产品停留在云端转录和关键词搜索阶段。记忆层的核心分水岭在于:是「记录过去」还是「理解过去并将其变成可运行的认知系统」
- 真实场景的工程验证:在一台 MacBook Pro M5 上,24 小时内完成 2TB 视频素材的索引,本地原生模型输出近亿 token,同等任务云端推理约 $400。这组数据不是单个产品的性能指标,而是端侧推理的成本结构已经可以和云端正面竞争的信号
- 用户数据透露的信号:已积累千万用户,其中付费用户仅约 1/3 是内容创作者,2/3 是金融、法律、医疗等领域的知识工作者。Product Hunt 社区 150+ 条评论中,最高频的关键词是「本地处理」和「记忆」——说明记忆层的需求不是垂直场景,而是一个通用基础设施
- 下一步的技术方向
- 从单机记忆到跨设备记忆网络:用户数据分散在电脑、手机、NAS、云盘,记忆系统需要连接这些数据孤岛而不是另外造一个
- Memory Layer 的标准化:四条创业路线在各自跑,但行业最终需要一个类似数据库 SQL 标准的记忆层接口——Memory API / SDK 化,让任何 Agent 都能接入统一的用户记忆底座
- 云端 Intelligence + 端侧 Memory 的协同架构:不是「本地替代云端」,而是云端模型提供世界知识,端侧模型管理个人记忆,两者互补——这可能是后续 3-5 年的主导架构
听众收益
- 端侧多模态模型的自研与优化:真实场景驱动的模型训练与持续演进
- 消费级 AI 推理系统设计:多模型协同、运行时优化与异构芯片适配
- Memory Layer的架构设计:并非升级版RAG,而是知识图谱、向量检索与 Memory Agent 的协同实现
- 下一代 AI 基础设施演进:Memory Layer 的技术路线与端云协同架构
by 余席宇 博士
OPPO
多模态算法专家随着端侧多模态场景扩展与长上下文需求增长,端侧大模型在 prefill / decoding 时延、工程链路复杂度、模型迭代周期上面临多重约束。本次分享围绕 OPPO 端侧化全栈实践,介绍以 QAT 量化感知训练 为核心的协同训练体系,覆盖稀疏化压缩、长上下文 Cache Eviction、解码加速训练,并结合 QALFT 自动化工程化 与 0 阶端侧训练,打通从模型压缩、编译部署到垂域落地与本地个性化的完整链路。
演讲提纲
- 端侧大模型的核心挑战
- 推理效率瓶颈:长上下文场景下,prefill 与 decoding 时延显著上升
- 工程链路复杂:端侧化涉及 训练压缩 → 量化校准 → 编译部署 → 业务集成,链路长、协作成本高
- 模型迭代与个性化难覆盖:端侧模型版本迭代周期长,难以快速响应业务变化,用户个性化需求很难满足
- 多模态大模型端侧化工程实践:全栈链路设计
- 端侧化系统架构:打通模型压缩 → 编解码加速 → 编译部署 → 应用集成 → 端侧个性化迭代的全链路技术栈
- 技术建设
- 模块化 QAT 训练架构
- 将 sparse 训练、Eviction-aware QAT、解码加速训练等能力模块化接入同一训练框架
- 支持从 prefill 到 decoding 的全链路协同优化,而非单点优化
- QALFT 工程化架构:自动化交付
- 工程化痛点:端侧大模型落地常面临 PTQ 量化 + QALFT 微调 流程复杂、平台差异大、人工环节多
- QALFT自动化流水线:覆盖数据准备 → PTQ/QAT → QALFT → 精度校验 → 性能 profiling等全链路环节,支持 MTK、高通等多硬件平台的统一训练与差异化输出
- 端侧训练:0 阶优化
- 利用稀疏扰动等技术显著提升0阶优化性能
- 在隐私约束下,完成用户侧轻量适配,满足用户个性化需求,同时避免重成本端侧模型迭代
- 模块化 QAT 训练架构
- 应用场景与展望
- 应用场景
- 垂域业务交付:端侧模型覆盖10余垂域场景业务
- 端侧化SOP快速复制:支持端侧Agent能力快速迭代
- 未来展望
- 更长上下文下的高效注意力与 KV Cache 管理
- 更低存储与带宽开销,比如低比特量化训练等
- 端侧多模态理解与 Agent 规划能力的统一优化
- 应用场景
- 结语
- 端侧大模型的规模化落地,依赖 算法、工程、系统 三者的协同共振:以 QAT 协同训练打通模型压缩、长上下文与解码加速;以 QALFT 自动化缩短跨平台交付周期;以 0 阶端侧训练 满足个性化与隐私需求。面向更长上下文、更低功耗与更高隐私的端侧智能,关键不在单点突破,而在全链路工程化能力的持续升级。
这样的技术在实践过程中有哪些痛点?
- 成本高(端侧算力、存储与带宽预算紧张,长上下文推理成本陡增)
- 量化与效果之间的权衡(BPV极致压缩对 IO 与精度的双重约束)
- 多片商、多平台适配复杂度高
- Cache Eviction、投机解码与训练目标的对齐难度大
听众收益
- 算法融合系统(混合注意力架构 + 量化感知训练 + Cache Eviction + 投机解码端到端协同)
- 端侧训练的高性能实践
- 端侧 Agent 系统架构实践
by 邱慧
快手
大模型应用算法专家大模型 Agent 走向商业规模化落地,面临的已不只是"回答质量"问题,而是低时延、高并发、动态知识实时性、算力成本与长期效果可演进的多重约束。快手生活服务、电商、商业化和直播场景中,商品信息、优惠规则和交易链路高度实时,传统大模型方案直接上线,往往在时延、幻觉和成本上遇到瓶颈。
本次分享以"高并发、高变化场景下的大模型高效推理"为主线,结合快手商业互动 Agent 的落地实践,探讨如何在真实业务约束下构建稳定、低成本、可规模化的商业 Agent 系统:通过动态知识更新策略与知识自裁机制解决商业场景下的知识冲突问题,将知识变更和知识溯源前移至推理阶段实现实时更新;通过用户模拟与停滞检测实现Agent自进化,避免 Agent 在动态环境中越用越退化;在模型优化阶段引入自适应混合步度归因算法,解决多轮对话的长期收益归因难题。本次分享更关注算法与系统的协同设计,探讨如何把模型能力转化为稳定、低成本、可规模化的商业基础设施,并沉淀出可迁移的 Agent 效率工程方法论。
演讲提纲
- 商业 Agent 落地的核心挑战
- 业务痛点:高并发、低时延、强动态知识更新、算力成本多重约束并发
- 传统方案的瓶颈:直接上线大模型在时延、幻觉、成本上均遇天花板
- 核心矛盾:效果、时延与成本的不可能三角,引出效率工程主线
- 知识实时性:动态知识更新与冲突消解
- 痛点:商品、优惠、库存秒级变化,离线索引更新滞后,幻觉风险高
- 动态知识更新策略:将知识变更前移至推理阶段,实现实时注入
- 知识自裁机制:多来源知识冲突时,基于来源优先级、更新时间和置信度进行可信度裁决
- 效果:降低幻觉风险,显著提升知识一致性
- Agent自进化:如何避免 Agent 越用越退化
- 痛点:开放动态商业环境下,固定策略长期运行容易失效退化
- 用户模拟机制:基于历史交互轨迹构建离线模拟环境,支持策略预评估与失败案例挖掘
- 停滞检测机制:实时识别策略失效与环境漂移,触发自更新链路
- 数据飞轮:模拟评估 → 数据回流 → 策略更新 → 上线验证
- 长期收益归因:多轮对话的奖励分配
- 痛点:最终成交难以归因到历史关键对话动作,稀疏奖励导致优化方向偏移
- 自适应混合步度归因算法(Step-Aware Credit Assignment)
- 结合中间过程信号(追问、点击、加购)与最终转化结果
- 动态调整短期反馈与长期收益的归因权重
- 效果:将稀疏业务结果转化为细粒度可学习反馈信号,模型优化方向更准确
- 应用效果与展望
- 落地场景:生活服务、电商、商业化、直播多场景覆盖
- 核心收益:知识实时一致性提升、模型退化缓解、多轮转化归因改善
- 未来方向:
- 多 Agent 协作框架,应对跨品类比价、组合优惠等复杂商业决策链路
- 个性化策略自适应,基于用户消费偏好与决策风格实现 Agent 策略个人级定制
实践中的痛点与取舍
- 商业 Agent 落地的核心矛盾是效果、时延与成本无法同时拉满。高效果依赖大模型和长上下文,高并发又要求低时延和低成本,两者天然对立。
- 我们的实践结论是:放弃"一套链路解决所有问题"的思路。为了响应速度经常需要使用小模型并关闭思考模式,但小模型在复杂场景下的效果损失不可忽视,如何提升小尺寸模型的能力仍是持续投入的方向。与此同时,知识更新频率与推理成本之间的权衡、模型自更新的稳定性与收敛速度的博弈,都是在真实业务中反复遇到的取舍问题,没有一劳永逸的答案,只能在具体场景下持续调优。
- 效率工程的本质,是在系统整体层面找到最优平衡,而非追求每个环节的极致。
听众收益
- 了解大模型 Agent 从 Demo 走向商业生产环境时的真实工程挑战,理解效果、时延与成本三角博弈的应对思路。
- 学习动态知识实时更新与知识冲突消解的工程实践方案,掌握知识变更前移至推理阶段的核心设计思路。
- 获得用户模拟与动态自进化的模型自更新闭环设计经验,理解如何在不伤害真实用户体验的前提下持续演进 Agent 策略。
- 掌握多轮对话长期收益归因方法,学习如何把稀疏业务结果转化为细粒度可学习反馈信号,解决 Agent 优化中奖励稀疏和方向偏移问题。
- 带走一套可迁移的 Agent 效率工程方法论,适用于电商、本地生活、直播、智能客服等需要低时延、高并发与强业务闭环的商业 Agent 场景。
关注主办方(InfoQ)
联系我们
交通指南
深圳湾万丽酒店
Shenzhen Bay Marriott Hotel
地址:深圳南山区粤海街道高新区社区科技南路18号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手