OPPO 多模态算法专家,长期从事端侧大模型算法研究与工程落地。在大模型量化感知训练、编解码加速等方向具备丰富实践经验,主导/参与多项端侧化关键技术攻关。多年深耕模型端侧化,覆盖感知、理解、推理等跨平台、多业务场景的轻量化模型设计与训练,以及高效率推理部署系统构建。
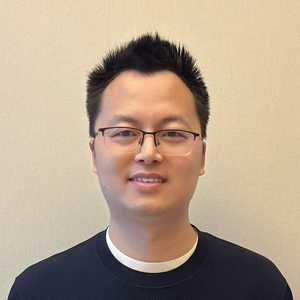
专题演讲嘉宾:余席宇 博士
OPPO多模态算法专家
by 余席宇 博士
OPPO
多模态算法专家随着端侧多模态场景扩展与长上下文需求增长,端侧大模型在 prefill / decoding 时延、工程链路复杂度、模型迭代周期上面临多重约束。本次分享围绕 OPPO 端侧化全栈实践,介绍以 QAT 量化感知训练 为核心的协同训练体系,覆盖稀疏化压缩、长上下文 Cache Eviction、解码加速训练,并结合 QALFT 自动化工程化 与 0 阶端侧训练,打通从模型压缩、编译部署到垂域落地与本地个性化的完整链路。
演讲提纲
- 端侧大模型的核心挑战
- 推理效率瓶颈:长上下文场景下,prefill 与 decoding 时延显著上升
- 工程链路复杂:端侧化涉及 训练压缩 → 量化校准 → 编译部署 → 业务集成,链路长、协作成本高
- 模型迭代与个性化难覆盖:端侧模型版本迭代周期长,难以快速响应业务变化,用户个性化需求很难满足
- 多模态大模型端侧化工程实践:全栈链路设计
- 端侧化系统架构:打通模型压缩 → 编解码加速 → 编译部署 → 应用集成 → 端侧个性化迭代的全链路技术栈
- 技术建设
- 模块化 QAT 训练架构
- 将 sparse 训练、Eviction-aware QAT、解码加速训练等能力模块化接入同一训练框架
- 支持从 prefill 到 decoding 的全链路协同优化,而非单点优化
- QALFT 工程化架构:自动化交付
- 工程化痛点:端侧大模型落地常面临 PTQ 量化 + QALFT 微调 流程复杂、平台差异大、人工环节多
- QALFT自动化流水线:覆盖数据准备 → PTQ/QAT → QALFT → 精度校验 → 性能 profiling等全链路环节,支持 MTK、高通等多硬件平台的统一训练与差异化输出
- 端侧训练:0 阶优化
- 利用稀疏扰动等技术显著提升0阶优化性能
- 在隐私约束下,完成用户侧轻量适配,满足用户个性化需求,同时避免重成本端侧模型迭代
- 模块化 QAT 训练架构
- 应用场景与展望
- 应用场景
- 垂域业务交付:端侧模型覆盖10余垂域场景业务
- 端侧化SOP快速复制:支持端侧Agent能力快速迭代
- 未来展望
- 更长上下文下的高效注意力与 KV Cache 管理
- 更低存储与带宽开销,比如低比特量化训练等
- 端侧多模态理解与 Agent 规划能力的统一优化
- 应用场景
- 结语
- 端侧大模型的规模化落地,依赖 算法、工程、系统 三者的协同共振:以 QAT 协同训练打通模型压缩、长上下文与解码加速;以 QALFT 自动化缩短跨平台交付周期;以 0 阶端侧训练 满足个性化与隐私需求。面向更长上下文、更低功耗与更高隐私的端侧智能,关键不在单点突破,而在全链路工程化能力的持续升级。
这样的技术在实践过程中有哪些痛点?
- 成本高(端侧算力、存储与带宽预算紧张,长上下文推理成本陡增)
- 量化与效果之间的权衡(BPV极致压缩对 IO 与精度的双重约束)
- 多片商、多平台适配复杂度高
- Cache Eviction、投机解码与训练目标的对齐难度大
听众收益
- 算法融合系统(混合注意力架构 + 量化感知训练 + Cache Eviction + 投机解码端到端协同)
- 端侧训练的高性能实践
- 端侧 Agent 系统架构实践
关注主办方(InfoQ)


联系我们
交通指南
深圳湾万丽酒店
Shenzhen Bay Marriott Hotel
地址:深圳南山区粤海街道高新区社区科技南路18号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手