在大模型驱动的新一代 AI 应用体系中,数据工程正从"离线分析支撑&q... 展开 >
AI 原生数据工程
会议室:祥源宴会厅 东厅出品人:王彦辉
- Topic 1
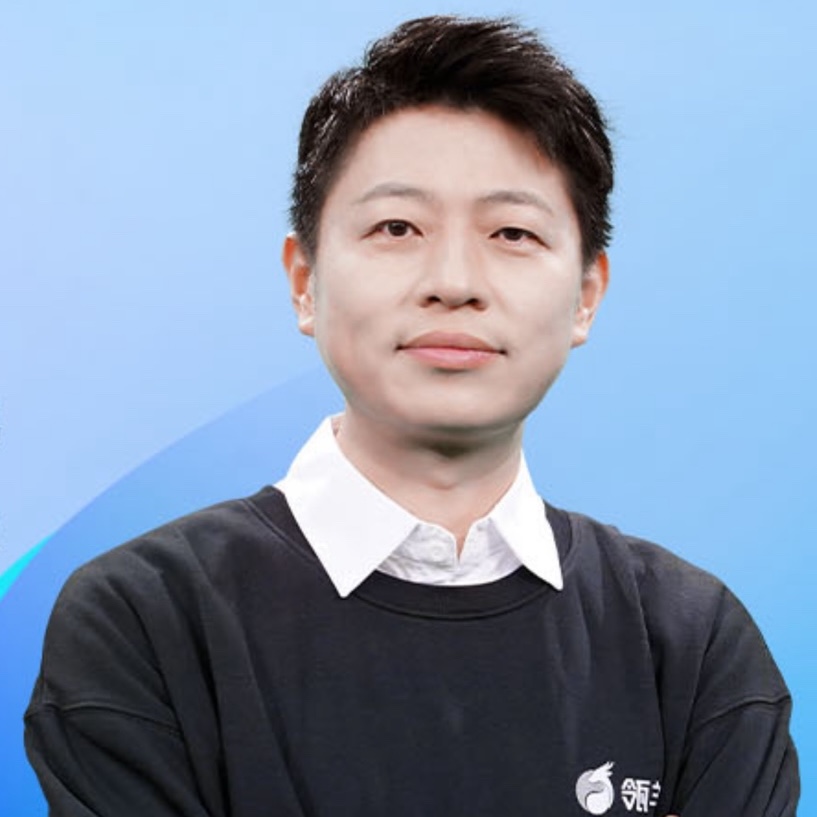
刘少伟
阿里云智能集团 高级技术专家 - Topic 2
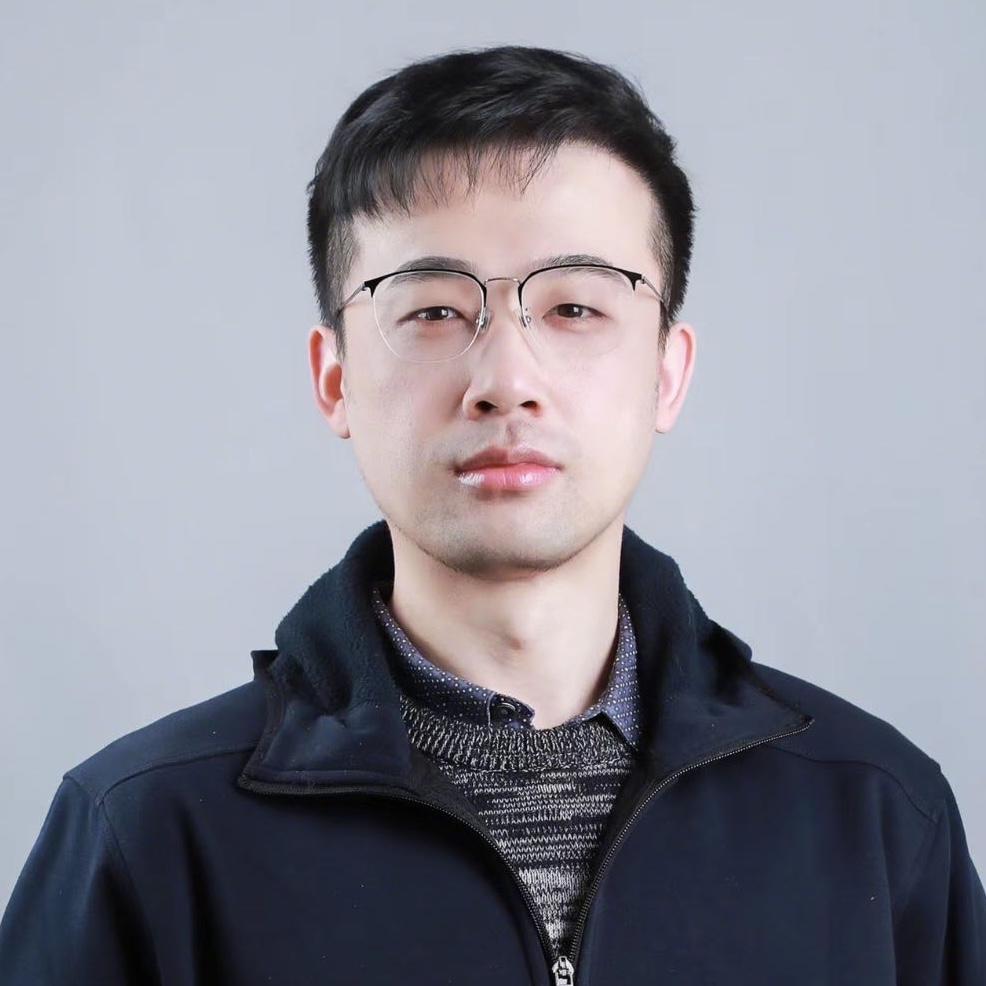
马进
抖音集团 数据引擎开发工程师 - Topic 3
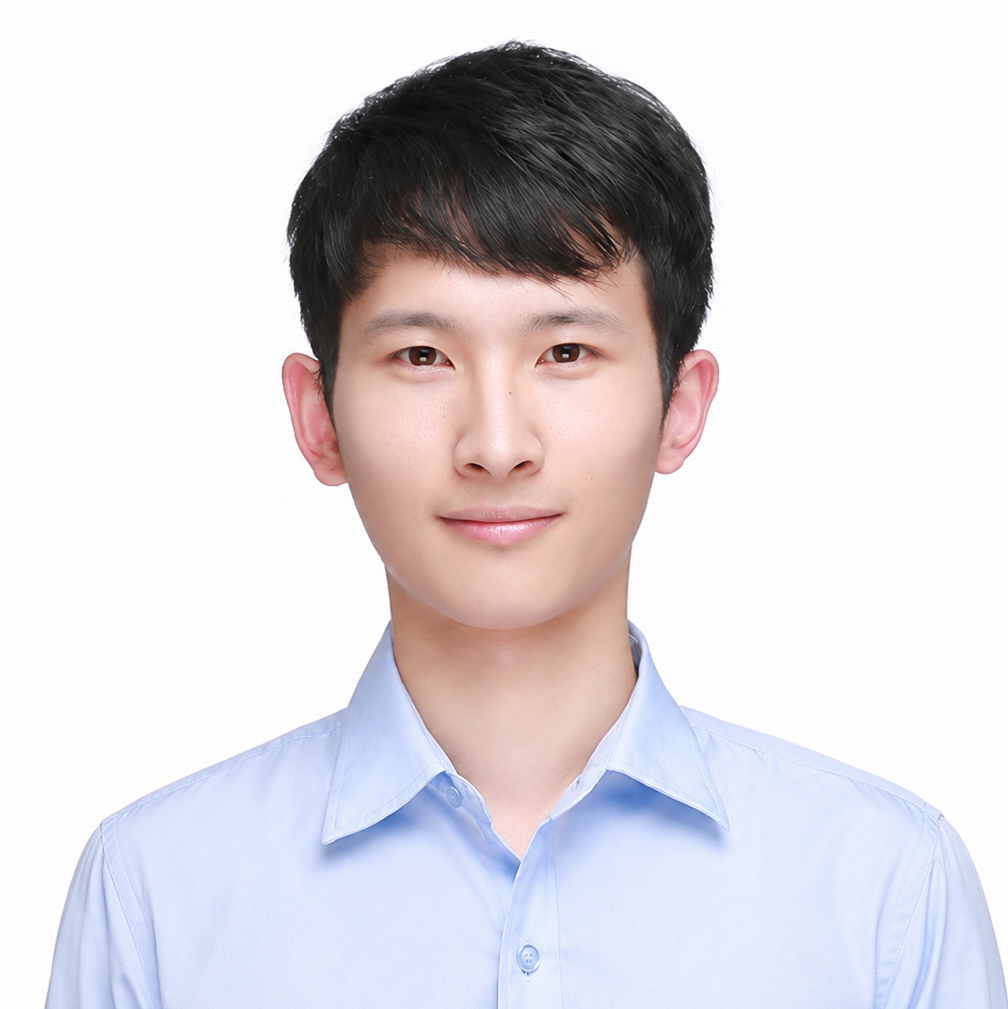
陈宇
小红书 数据引擎开发工程师 - Topic 4
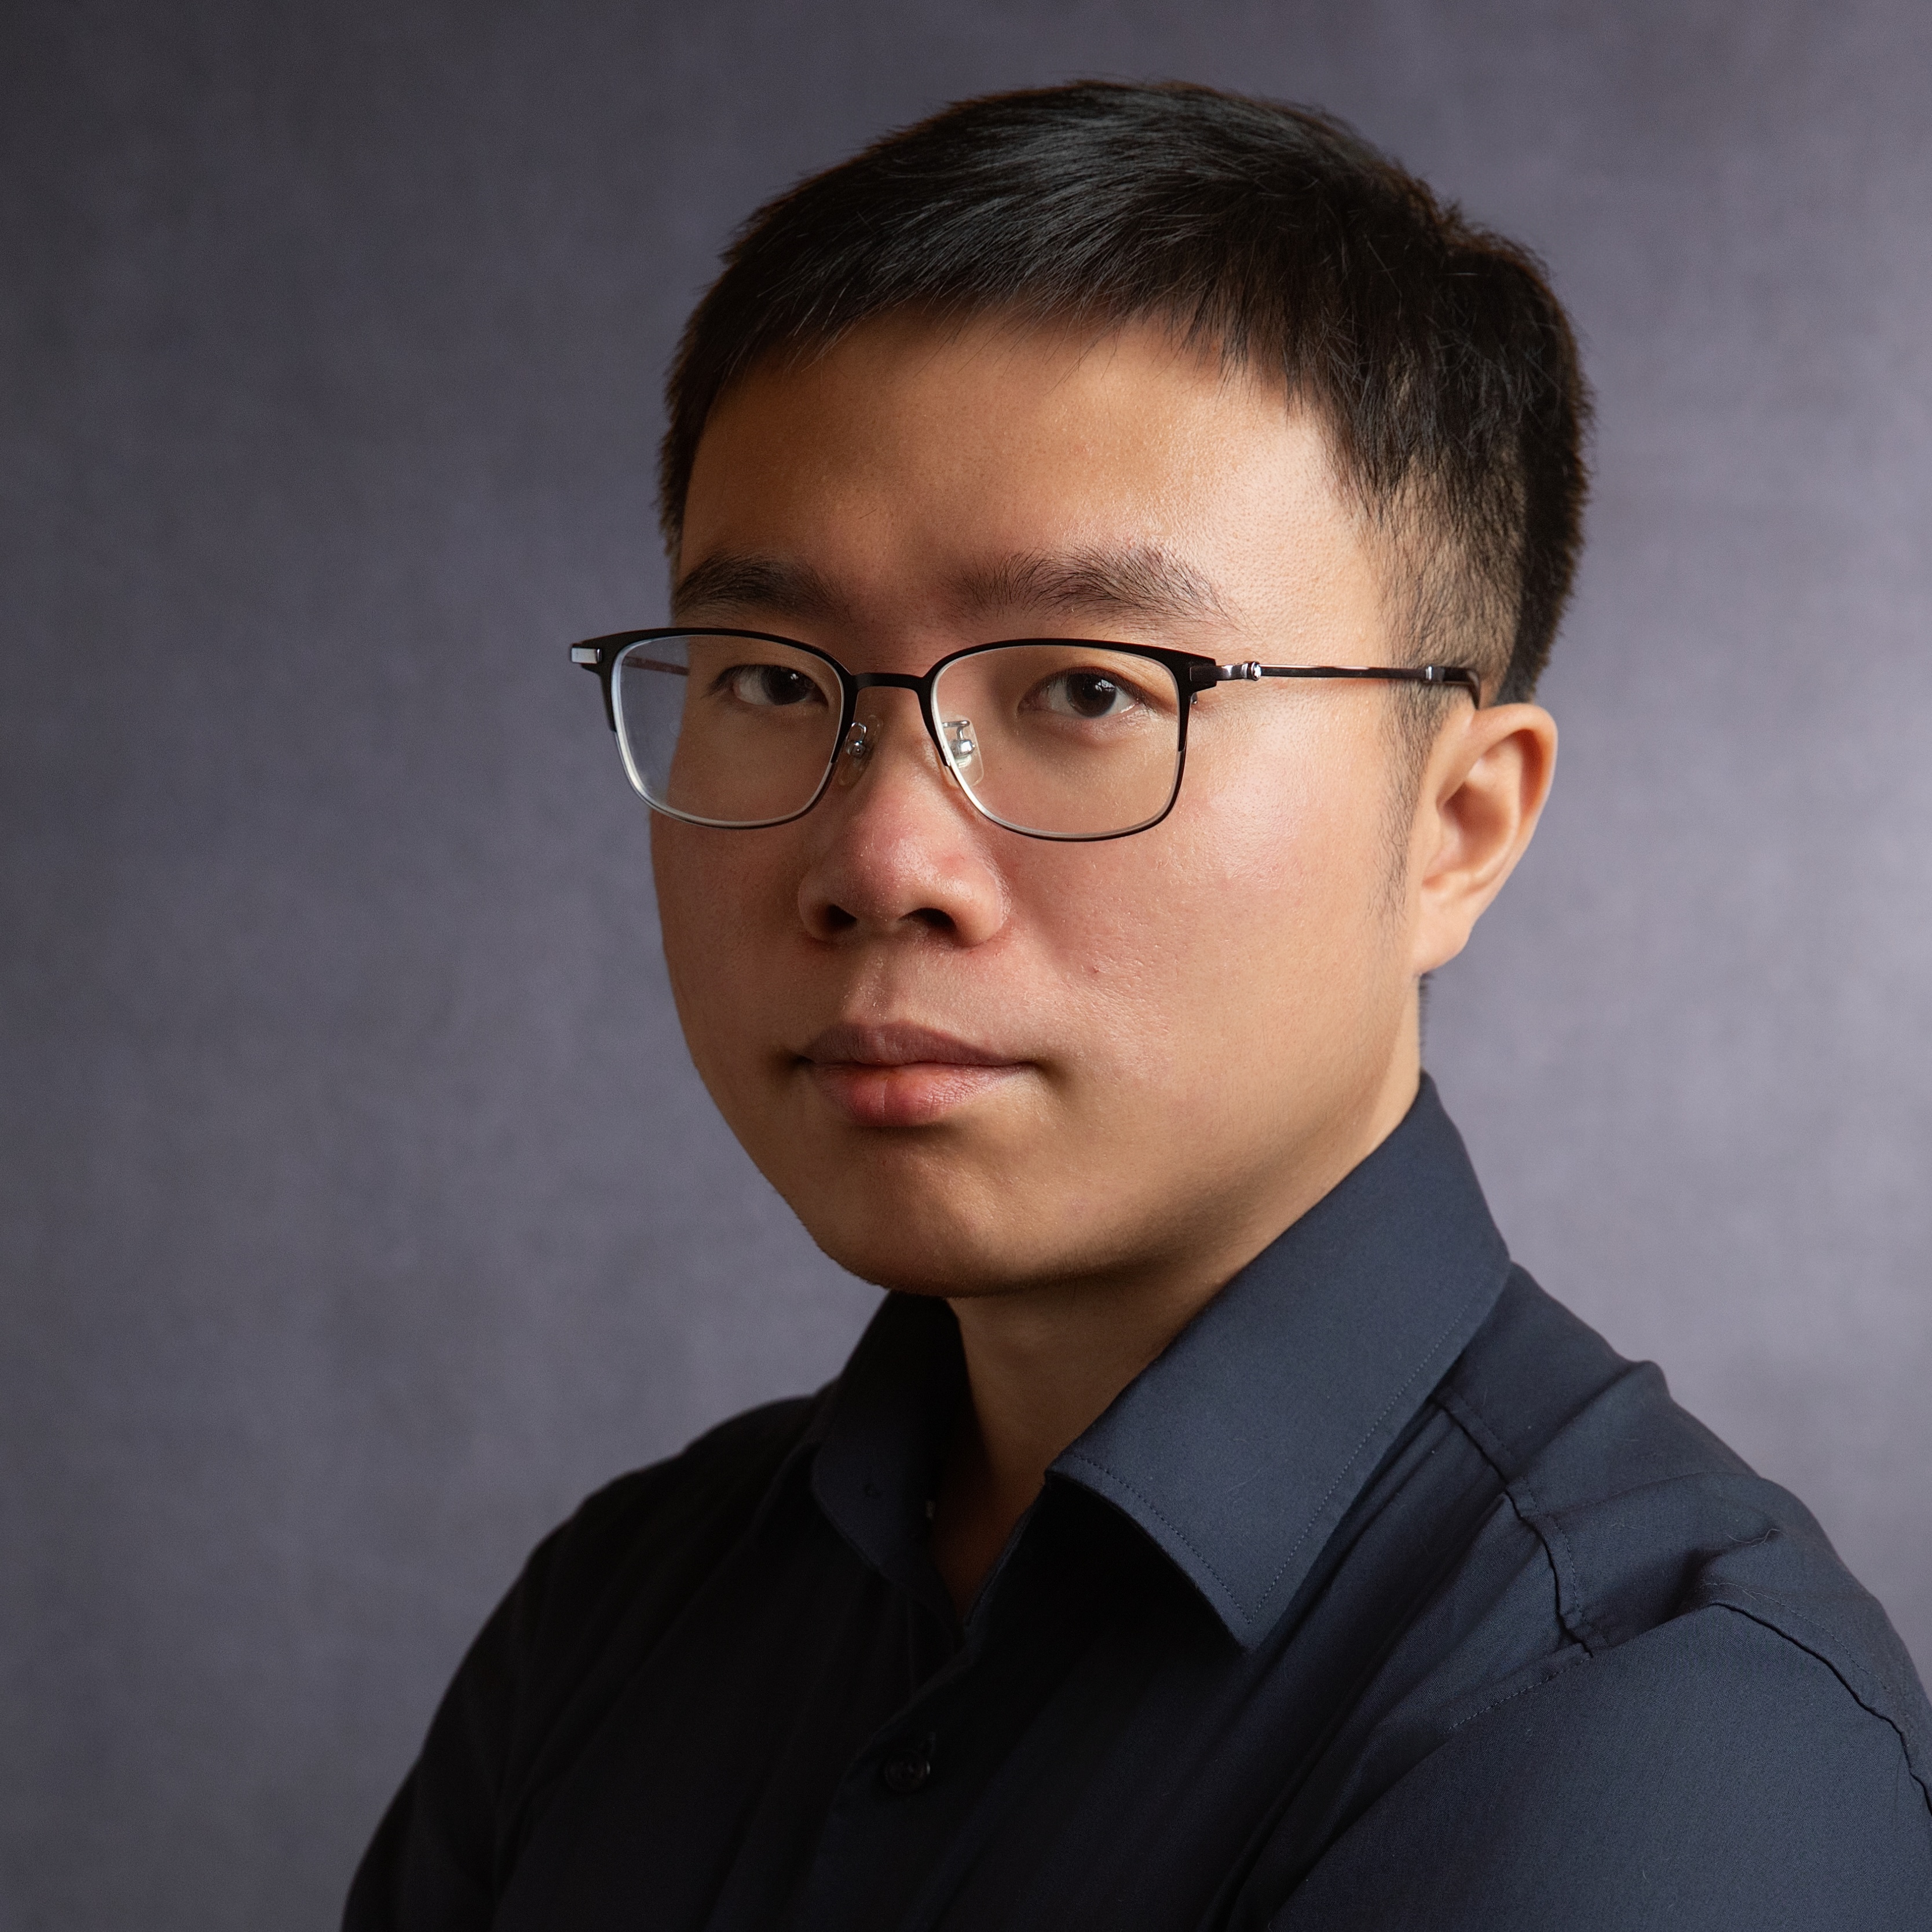
廖俊峰
深信服科技 首席专家
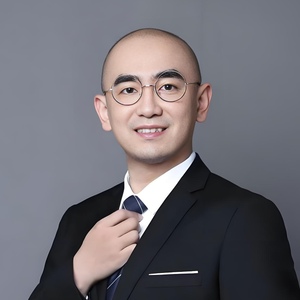
专题出品人:王彦辉
抖音集团数据引擎产品负责人
现任火山引擎数智平台产品总监,10+年大数据产品经验,曾就职于阿里云,目前担任火山引擎数智平台计算引擎负责人,负责AI数据湖服务、EMR、Bytehouse、Flink,同时负责火山引擎记忆解决方案Agent DataLake,为企业级Agent提供新一代数据底座。
地点:祥源宴会厅 东厅
专题:AI 原生数据工程
在大模型驱动的新一代 AI 应用体系中,数据工程正从"离线分析支撑"走向"在线智能核心",其职责不再局限于数据处理,而是直接参与模型能力构建与智能表现塑造。数据,正在从被动资源演进为 AI 系统中的关键组成模块。
本专题聚焦 AI 原生数据工程 的新一代技术体系,围绕"数据如何定义模型能力"这一核心命题,系统性拆解从训练到推理、从生产到反馈的全链路数据闭环,包括:
- 训练数据构建体系:文本、图像、视频等多模态数据的智能化标注、清洗与增强方法,以及面向大模型预训练与微调的高质量语料构建范式
- 合成数据与数据生成:基于模型自举(Self-Play)、知识蒸馏与场景仿真的高质量训练数据生成技术,探索数据规模与质量的扩展边界,以及合成数据的真实性评估与偏差控制
- AI 数据处理 Pipeline:面向多模态与大规模训练数据的高效处理框架,涵盖分布式数据加载、流式数据预处理、DataJuicer 等 AI 原生数据处理工具,及支持海量样本的弹性计算架构
- 多模态数据资产管理:面向大模型的多模态数据统一表征、元数据管理与血缘追踪,及 Lance、Hugging Face Datasets 等 AI 原生数据格式与存储实践,支持高效检索与版本控制
- 数据治理与质量评估:面向 LLM 与 Agent 系统的数据质量维度定义、自动化评估指标(如去重率、知识密度、毒性检测)、数据选择策略与持续优化机制
- 数据-模型协同进化:构建数据生产与模型反馈的闭环体系,实现基于模型表现的训练数据动态筛选、在线数据更新与 Agent 行为数据的回传优化
本专题将从 AI 工程实践与智能系统架构视角出发,深入探讨 AI 原生数据体系如何支撑下一代大模型应用的规模化落地与持续演进。
by 刘少伟
阿里云智能集团
高级技术专家当前企业级 AI 应用普遍面临落地瓶颈,核心挑战在于数据多停留于分析与决策阶段,难以直接转化为可执行的业务动作。本演讲提出一个以数据为中心的业务对象智能体平台WinNexO,旨在打通企业智能化从数据到行动的断层,探讨一种面向业务对象的智能体架构设计方法。我们将首先深入剖析企业 Agent 落地的现实挑战,随后系统阐述解决该挑战问题的技术架构设计关键:以多模态数据集成夯实基础,实现结构化和非结构化数据的统一存储;以基于业务对象的语义模型构建认知核心,让智能体真正理解业务;最终依托 AI Agent,实现深度洞察与自动化执行的无缝衔接。最后,结合典型行业实践案例,分析 WinNexO 在推动企业 AI 从“辅助决策”向“自主执行”演进中的技术路径与应用成效。
演讲提纲:
- 企业 Agent 落地的问题和挑战
- 个人 Agent 的爆炸式增长 vs 企业 Agent 的难产
- 企业的诉求和现实鸿沟:统一、时效、质量、准确、可信、可控
- 从数据到行动的断裂:数据停滞在分析和决策层面
- WinNexO:以数据为中心的业务对象智能体
- 宏观架构设计:多模态数据集成 → 统一标准的语义模型 → 智能体支撑决策和行动
- 应用关键:多租户管理、用户协同、细粒度数据权限控制、开放集成
- 多模态数据集成
- 统一多模态数据的采集、处理、存储
- 丰富的多模态处理算子
- 基于业务对象的语义模型
- 语义模型定义:让 “数据、算法、规则、经验、资源” 在一个对象上合体
- 语义模型和传统模型的区别
- 语义模型的核心优势
- 用智能体支撑从数据到行动
- 洞察分析:结构化数据/非结构化数据一体化分析
- 行动任务:基于事件感知的行动自动化
- 云端沙箱:多租户、资源隔离、弹性调度、并发控制
- Agent Runtime:决策编排、上下文和记忆、工具执行、人机交互和干预
- 行业实践应用
- 总结与未来展望
听众收益:
- 深入了解企业级 Agent 落地的核心痛点和解决途径
- 掌握以业务对象为中心的数据语义模型的重要性,洞察 “多模态数据集成 → 数据语义模型 → AI Agent” 全流程体系
by 马进
抖音集团
数据引擎开发工程师随着大模型应用从单轮问答走向 RAG、Agent 和多模态智能体,数据基础设施正在从传统数据湖演进为 AI 原生的多模态数据湖。传统数据湖更擅长管理结构化数据和离线分析任务,但在 AI 场景中,系统需要同时处理文本、图片、视频、音频、Embedding、标注、特征和索引等多种数据形态。现实落地中,这些数据往往分散在对象存储、Parquet 表、向量数据库、搜索引擎和离线脚本中,造成数据重复、链路割裂、版本难以追溯,也增加了模型实验、检索调优和应用迭代的复杂度。
Lance 正是面向这一变化设计的开放多模态 Lakehouse 格式。它通过高效随机访问、原生向量检索、全文检索、零拷贝 Schema 演进、对象存储适配和数据版本管理等能力,将原始多模态数据、元数据、Embedding、索引和版本统一到同一套开放数据层中。在此基础上,Lance 不仅可以支撑多模态数据湖中的数据治理、混合检索和模型训练,也进一步延伸到 RAG 与 Agent 场景,成为构建“记忆湖”的基础组件。
本次分享将围绕“从数据湖到记忆湖”的实践展开,介绍如何基于 Lance/LanceDB 设计一套面向 AI 应用的数据底座:从多模态数据的统一组织、Embedding 与索引管理、版本回溯,到面向 Agent Memory 的长期记忆存储与检索。分享也会结合实际建设过程中遇到的数据同步、检索性能、数据演进和系统复杂度问题,讨论 Lance 为什么正在从多模态数据湖方案逐步发展为 Agent Infra 的关键基础设施。该方案已在多模态数据管理和智能检索场景中完成验证,能够有效降低跨系统同步成本,提升数据复用、检索迭代和长期记忆构建效率。
演讲提纲:
- 从数据湖到记忆湖:AI 原生数据基础设施的演进
- 传统数据湖的局限性:结构化数据与离线分析的困局
- AI 场景的多模态数据挑战:形态多样、分散存储、链路割裂
- 从 RAG 到 Agent:数据基础设施的新诉求
- Lance:面向多模态 AI 的开放 Lakehouse 格式
- 核心能力:高效随机访问、原生向量检索、全文检索
- Schema 演进与数据版本管理
- 统一存储层:原始数据、元数据、Embedding、索引一体化
- 多模态数据湖的统一组织与管理
- 多模态数据的采集、处理、统一存储
- Embedding 与索引管理
- 数据版本回溯与演进
- 面向 Agent Memory 的记忆湖构建
- 长期记忆存储与检索
- Agent 场景下的数据底座设计
- 落地实践中的挑战与解法
- 数据同步与检索性能优化
- 数据演进与系统复杂度控制
- 跨系统同步成本降低与检索迭代效率提升
- 总结与未来展望
听众收益:
- 深入了解 AI 原生多模态数据湖的设计理念,掌握从传统数据湖到“记忆湖”的演进路径
- 学会基于 Lance/LanceDB 构建面向 AI 应用的数据底座,打通“多模态数据统一组织 → Embedding 与索引管理 → Agent Memory 存储”全链路
- 获取数据同步、检索性能、版本演进等落地实践中的关键挑战与解法,降低系统复杂度、提升迭代效率
by 陈宇
小红书
数据引擎开发工程师AI 数据生产贯穿模型研发的完整生命周期:模型诞生前,需要大规模准备预训练语料或 SFT 精调数据;模型上线前,需要对存量数据完成批量推理入库;模型上线后,需要对持续产生的增量数据实时推理入库。
这三个阶段对算力的诉求截然不同,没有一种资源供给模式能一劳永逸地满足所有场景。
小红书数据引擎团队以 Ray 为统一引擎底座,基于 Ray 引擎的统一调度能力与丰富的上层框架,覆盖了 AI 数据生产三个阶段截然不同的算力诉求——同一套引擎底座,通过不同的框架组合与资源供给策略,驱动从稳定常驻集群到海量弹性算力的全场景落地。
阶段一 · 训练数据准备: 预训练和 SFT 数据处理链路天然异构——去重依赖大规模 Shuffle,AI 质量打分依赖 GPU 批量推理,多模态内容处理需要高效的格式解析。我们在同一个 Ray 集群上通过 RuntimeEnv 沙箱隔离让 RayDP、Ray Data、Daft、DataJuicer 多种引擎共存协同,持续打磨万核百卡异构Ray集群稳定性。
阶段二 · 模型上线前离线刷库: 存量数据回扫是典型的"来得急、量级大、一次性"需求,但 GPU 资源天然离散在多家云厂商、多个可用区。我们经历了两代方案演进:第一代通过 Virtual Kubelet 将跨 K8s 集群的 CPU 混部资源汇聚为统一算力入口;第二代提出"存算分离"架构,以稳定 CPU 集群承载数据编排,通过 Ray Serve 联邦驱动弹性 GPU 资源完成推理,支持行级重试与断点续推,将原本因资源离散导致的长尾问题大幅收敛。此外,我们正在向 KubeRay 开源社区提出 KubeRay Federation 方案(kuberay#4561)。
阶段三 · 模型上线后近线增量入库: 新笔记、新商品需要分钟级持续入库,流量波动大且需要7*24h运行。我们自研了流批统一引擎 Ray Klein,基于 Chandy-Lamport 快照算法实现精确 Kafka offset 断点恢复,支持一套业务代码在全量批推与近线增量之间无缝切换。
本演讲将以这三个阶段为线索,分享 Ray 引擎如何凭借统一的调度底座,通过不同的框架组合与资源供给策略,覆盖 AI 数据生产全生命周期中截然不同的算力诉求,以及我们在工程实践中形成的核心判断:算力供给模式必须匹配业务阶段的特征,而非用单一模式覆盖所有场景。
演讲提纲:
- 一、开篇(为什么一套引擎覆盖三类场景)
- AI 数据生产分三阶段:训练数据准备(稳定常驻+多引擎协同)、离线刷库(短期爆发+容忍驱逐+跨云)、近线增量入库(持续自适应+精确断点恢复)
- Ray 的核心价值:统一调度、支持异构资源、上层生态丰富。整体规模:弹性 CPU 上亿核时/月,GPU 百万卡时/月
- 二、Ray 底座能力
- Ray Core:全局资源视图、任意节点发起分布式任务、高性能通信(小数据直传/大数据零拷贝)
- AutoScaler:按需扩缩容,无需预规划
- 生态:RayData、RayServe、RayKlein、Daft、RayDP、DataJuicer
- 三、训练数据准备(多引擎协同)
- 挑战:数据来源多样、处理链路复杂、无万能引擎且协同成本高
- 方案:多引擎统一在 Ray 底座,一个 Python 脚本无缝切换不同引擎
- 实践:RuntimeEnv 做依赖隔离,本地直连集群开发,大规模集群解决 GCS、调度、日志等稳定性问题
- 四、离线刷库(弹性算力)
- 挑战:任务紧急、规模大、资源碎片化(多云多区 GPU)
- 痛点:大任务拆分导致长尾严重
- 演进:
- Virtual Kubelet 聚合多集群 CPU,支持大规模推理,但扩容和驱逐成本高
- 存算分离:Serve 化模型算子,用轻量客户端驱动弹性 GPU
- KubeRay Federation:在框架层实现跨集群统一调度,从根本解决负载不均
- 近线增量入库(流式算力)
- 需求:分钟级处理、7×24运行、弹性扩缩容、精确恢复
- 方案:自研 Ray Klein
- 基于分布式一致性快照,实现 Kafka offset 级恢复
- 数据驱动+反压机制,自动平衡吞吐
- 全局重启与可观测性完善
- 一套代码支持流批统一
- 总结
- 训练数据:统一底座+多引擎协同。
- 离线刷库:VK 解决资源聚合,Federation 解决调度
- 近线入库:Checkpoint 粒度决定可靠性
- 核心结论:算力供给模式必须匹配业务阶段,Ray 提供灵活底座支持差异化
- 后续:推进 Federation、Ray Serverless 化、Daft 多模态规模化落地
听众收益:
- 了解如何基于 Ray 构建覆盖训练数据处理、离线推理、近线推理的统一算力供给体系
- 了解 RayDP、Ray Data、Daft、DataJuicer 在真实 PreTrain / SFT 数据处理链路中的选型逻辑与协同方式
- 获得流批统一引擎 Ray Klein 的设计思路,解决近线与离线场景代码割裂的问题
by 廖俊峰
深信服科技
首席专家问题背景: 传统数据湖信奉“先存后管”,导致大量非结构化数据处于不可视、不可用的“数据沼泽”状态,面临治理溃败与 ROI 难以证明的困境。AI 时代,Agent 应用对数据的需求从单纯“文件”转向可引用的“上下文”。
解决方案: 本次演讲提出从 Data Lake 向 AI 数据湖(Context Lake) 的战略升级。通过构建“湖原生存储底座+统一数据视图(UDV)”,实现非结构化数据的资产化激活,为 AI Pipeline 提供可信的记忆层。
技术细节: 核心依托高性能内置 Catalog 建立“原文-分块-向量”的深度血缘绑定,解决向量不可解释的痛点。结合目录桶技术提升高并发访问性能,并利用 Agent Sandbox实现秒级快照创建,确保 AI 在不污染主线数据的前提下进行安全试错与重切片验证。
实施效果: 该方案显著降低了数据搬迁与冗余成本,实现了“入湖即治理”。实验数据显示,通过目录桶与 S3 over RDMA 优化,可大幅提升 AI 训练数据读取效率;同时,利用统一数据视图,企业可渐进式纳管异构存储,将沉睡数据转化为可量化的 AI 知识资产。
演讲提纲:
- 背景与痛点:为什么传统数据湖在 AI 面前“哑火”了?
- 从“先存后管”到“数据沼泽”:
- 核心痛点: 传统数据湖信奉 Schema-on-Read,导致入湖门槛极低,缺乏强制元数据定义
- 现状: 存储只回答“文件在哪里”,不回答“数据是什么”。企业存了数 PB 数据,却因为找不到、不可信、权限乱,变成了“数据坟场”
- AI 应用的消费壁垒:
- 语义断层: AI 消费的不是原始 Byte,而是 Chunk 和 Embedding。传统存储与向量库之间存在巨大的工程断层
- 踩坑经验: 很多企业尝试直接在传统对象存储上跑 RAG,结果发现元数据检索极其缓慢(List 操作性能瓶颈),且向量数据与原始文档的血缘关系一旦丢失,AI 产生幻觉时根本无法追溯纠偏
- 从“先存后管”到“数据沼泽”:
- 解决方案选型:AI 时代的数据基础设施升级逻辑
- 从 Data Lake 转向 Context Lake:
- 目标: 不只是存数据,而是管理“上下文供应链”
- 核心组件选型:
- 底座层: 湖原生高性能存储(高性能文件+目录桶对象)
- 中枢层: 统一数据视图+ 高性能内置 Catalog
- 执行层: Agent 工作空间沙箱
- 从 Data Lake 转向 Context Lake:
- 深度技术细节:解决 AI 工程化落地的“三个关键点”
- 高性能内置 Catalog:解决“不可解释性”与“重切片难题”
- 技术原理: 在存储原生层建立“原文 - 分块 - 向量”的深度血缘绑定
- 独特优势: 支持“标量过滤+向量检索”的混合查询
- 实战经验: 当 Embedding 模型升级时,利用 Catalog 记录的元数据实现资产重构,避免全量重跑 pipeline,节省 70% 以上的算力浪费
- 目录桶与 S3 over RDMA:打通 IO 瓶颈
- 技术细节: 针对 AI 训练中大量小文件、高并发 List 的特征,采用层级目录组织
- 性能支撑: 支持 S3 over RDMA 与 GDS,大幅降低 GPU 等待 IO 的时延
- 踩坑经验: 普通对象存储的扁平命名空间在处理百万级分区时,List 操作会引发元数据节点抖动,目录桶通过物理分区隔离彻底解决了这个问题
- Agent Workspace Sandbox:让 AI 安全试错
- 技术细节: 基于快照技术,为 Agent 提供秒级创建的可写隔离空间
- 核心价值: AI 在沙箱内进行重切片验证、Prompt 调优,不污染生产主线数据
- 独特设计: 只有经过“审批发布”的产物才能进入主线,解决了 Agent 自动修改数据可能带来的安全性焦虑
- 高性能内置 Catalog:解决“不可解释性”与“重切片难题”
- 实施效果与数据支撑(基于内部测试与规划指标)
- 治理效率提升: 通过“入湖即治理”模式,非结构化数据的资产化处理时间缩短了 60%
- 访问性能突破:
- - 在分布式训练场景下,目录桶相较于普通对象桶,高并发 List 性能提升了 10 倍以上
- - 配合 S3 over RDMA,端到端吞吐量接近物理网速极限。
- 成本优化:利用温冷向量存储架构,将非活跃向量存储成本降低了 50%(不必全部挤在昂贵的在线向量数据库中)
- 跨协议互通:同一份数据同时支持 NFS 写入与 S3 读取,减少了 1:1 的数据冗余搬迁
听众收益:
- 学习如何通过存储原生的高性能 Catalog,在底层建立“原文-分块-向量”的深度血缘
- 掌握消灭 GPU “IO 饥饿”的极致性能调优方案,深入理解目录桶与传统对象存储扁平命名空间的本质区别,以及 S3 over RDMA/GDS 的落地细节
- 获取一种“数据平行宇宙”的系统级安全试错思路,了解如何利用快照技术构建 Agent Workspace Sandbox
关注主办方(InfoQ)
联系我们
交通指南
上海虹桥祥源希尔顿酒店
Hilton Shanghai Hongqiao
地址:上海市红松东路1116号
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手