专家级技术领袖,深信服AI及存储业务核心领航人。清华大学计算机科学与技术系博士,深耕高性能计算(HPC)、异构计算及大规模分布式存储领域十余年。曾任职于国家超算中心,相关科研工作入围全球高性能计算领域最高奖项“戈登贝尔奖”(Gordon Bell Prize)决赛前三。
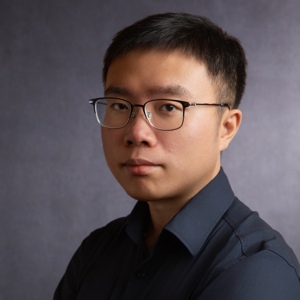
专题演讲嘉宾:廖俊峰
深信服科技首席专家
by 廖俊峰
深信服科技
首席专家问题背景: 传统数据湖信奉“先存后管”,导致大量非结构化数据处于不可视、不可用的“数据沼泽”状态,面临治理溃败与 ROI 难以证明的困境。AI 时代,Agent 应用对数据的需求从单纯“文件”转向可引用的“上下文”。
解决方案: 本次演讲提出从 Data Lake 向 AI 数据湖(Context Lake) 的战略升级。通过构建“湖原生存储底座+统一数据视图(UDV)”,实现非结构化数据的资产化激活,为 AI Pipeline 提供可信的记忆层。
技术细节: 核心依托高性能内置 Catalog 建立“原文-分块-向量”的深度血缘绑定,解决向量不可解释的痛点。结合目录桶技术提升高并发访问性能,并利用 Agent Sandbox实现秒级快照创建,确保 AI 在不污染主线数据的前提下进行安全试错与重切片验证。
实施效果: 该方案显著降低了数据搬迁与冗余成本,实现了“入湖即治理”。实验数据显示,通过目录桶与 S3 over RDMA 优化,可大幅提升 AI 训练数据读取效率;同时,利用统一数据视图,企业可渐进式纳管异构存储,将沉睡数据转化为可量化的 AI 知识资产。
演讲提纲:
- 背景与痛点:为什么传统数据湖在 AI 面前“哑火”了?
- 从“先存后管”到“数据沼泽”:
- 核心痛点: 传统数据湖信奉 Schema-on-Read,导致入湖门槛极低,缺乏强制元数据定义
- 现状: 存储只回答“文件在哪里”,不回答“数据是什么”。企业存了数 PB 数据,却因为找不到、不可信、权限乱,变成了“数据坟场”
- AI 应用的消费壁垒:
- 语义断层: AI 消费的不是原始 Byte,而是 Chunk 和 Embedding。传统存储与向量库之间存在巨大的工程断层
- 踩坑经验: 很多企业尝试直接在传统对象存储上跑 RAG,结果发现元数据检索极其缓慢(List 操作性能瓶颈),且向量数据与原始文档的血缘关系一旦丢失,AI 产生幻觉时根本无法追溯纠偏
- 从“先存后管”到“数据沼泽”:
- 解决方案选型:AI 时代的数据基础设施升级逻辑
- 从 Data Lake 转向 Context Lake:
- 目标: 不只是存数据,而是管理“上下文供应链”
- 核心组件选型:
- 底座层: 湖原生高性能存储(高性能文件+目录桶对象)
- 中枢层: 统一数据视图+ 高性能内置 Catalog
- 执行层: Agent 工作空间沙箱
- 从 Data Lake 转向 Context Lake:
- 深度技术细节:解决 AI 工程化落地的“三个关键点”
- 高性能内置 Catalog:解决“不可解释性”与“重切片难题”
- 技术原理: 在存储原生层建立“原文 - 分块 - 向量”的深度血缘绑定
- 独特优势: 支持“标量过滤+向量检索”的混合查询
- 实战经验: 当 Embedding 模型升级时,利用 Catalog 记录的元数据实现资产重构,避免全量重跑 pipeline,节省 70% 以上的算力浪费
- 目录桶与 S3 over RDMA:打通 IO 瓶颈
- 技术细节: 针对 AI 训练中大量小文件、高并发 List 的特征,采用层级目录组织
- 性能支撑: 支持 S3 over RDMA 与 GDS,大幅降低 GPU 等待 IO 的时延
- 踩坑经验: 普通对象存储的扁平命名空间在处理百万级分区时,List 操作会引发元数据节点抖动,目录桶通过物理分区隔离彻底解决了这个问题
- Agent Workspace Sandbox:让 AI 安全试错
- 技术细节: 基于快照技术,为 Agent 提供秒级创建的可写隔离空间
- 核心价值: AI 在沙箱内进行重切片验证、Prompt 调优,不污染生产主线数据
- 独特设计: 只有经过“审批发布”的产物才能进入主线,解决了 Agent 自动修改数据可能带来的安全性焦虑
- 高性能内置 Catalog:解决“不可解释性”与“重切片难题”
- 实施效果与数据支撑(基于内部测试与规划指标)
- 治理效率提升: 通过“入湖即治理”模式,非结构化数据的资产化处理时间缩短了 60%
- 访问性能突破:
- - 在分布式训练场景下,目录桶相较于普通对象桶,高并发 List 性能提升了 10 倍以上
- - 配合 S3 over RDMA,端到端吞吐量接近物理网速极限。
- 成本优化:利用温冷向量存储架构,将非活跃向量存储成本降低了 50%(不必全部挤在昂贵的在线向量数据库中)
- 跨协议互通:同一份数据同时支持 NFS 写入与 S3 读取,减少了 1:1 的数据冗余搬迁
听众收益:
- 学习如何通过存储原生的高性能 Catalog,在底层建立“原文-分块-向量”的深度血缘
- 掌握消灭 GPU “IO 饥饿”的极致性能调优方案,深入理解目录桶与传统对象存储扁平命名空间的本质区别,以及 S3 over RDMA/GDS 的落地细节
- 获取一种“数据平行宇宙”的系统级安全试错思路,了解如何利用快照技术构建 Agent Workspace Sandbox
关注主办方(InfoQ)


联系我们
交通指南
上海虹桥祥源希尔顿酒店
Hilton Shanghai Hongqiao
地址:上海市红松东路1116号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手