研究方向聚焦计算机视觉与人工智能领域,涵盖生成式AI、目标检测、图像分割、人体关键点估计、人体动作识别及三维重建等方向。2014 年于南洋理工大学(NTU)获得博士学位,师从黄俊松教授(Prof. Junsong Yuan)。此前曾在腾讯担任研究总监四年,并在旷视科(Face++)工作五年。
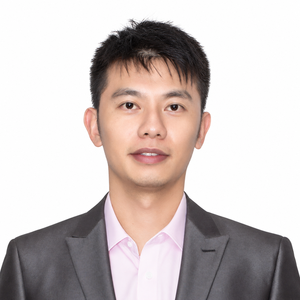
专题演讲嘉宾:俞刚
阶跃星辰副总裁
by 俞刚
阶跃星辰
副总裁随着以 Next-token prediction 为代表的大模型技术迅猛发展,其应用已从单一语言模型快速拓展至多模态领域。本次分享将以语言模型为切入点,系统介绍多模态场景下生成与理解技术的演进脉络,重点围绕语音、图像两大模态,探讨前沿多模态模型的架构设计思路,并展望未来核心研究方向。
演讲提纲:
- 大语言模型(LLM)2023年至今的发展变化
- Step 3.5 flash 相关介绍
- 文本与语音交互的融合及发展
- Step-audio 2 & Step-audio 2.5 相关介绍
- 文本+语音+视觉的多模态融合
- Step-image 2 & Step-audio-editx 相关介绍
- 生成一体化的难点与实现路径
- 未来探索方向整理
听众收益:
-
了解多模态生成和理解的前沿进展
关注主办方(InfoQ)


联系我们
交通指南
上海虹桥祥源希尔顿酒店
Hilton Shanghai Hongqiao
地址:上海市红松东路1116号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手