拥有清华大学硕士学位,目前任职于京东零售 AI Infra 方向,专注于 LLM 推理优化、投机推理、生成式推荐及端智能等方向的研究与应用。作为 xLLM 项目的 Core Maintainer,参与了项目从 0 到 1 的开发,负责多个核心组件的研发,为京东零售全场景 LLM 在线服务提供底层支持。同时深度参与端智能项目,主导关键算法与架构设计,相关成果已在京东 APP 内稳定运行,覆盖海量用户场景。致力于通过技术创新,推动大模型与智能系统在超大规模业务中的落地与实践。
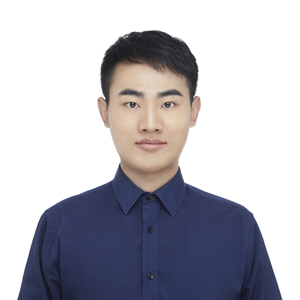
专题演讲嘉宾:梁志伟
京东算法工程师
by 梁志伟
京东
算法工程师议题介绍本次演讲将聚焦于xLLM 的投机推理架构设计。将从一个核心问题出发:如何让大模型推理在保证生成质量的前提下,实现数量级的效率提升?
传统的自回归推理如同“逐字思考”,速度存在瓶颈。投机式推理则引入了一个“快速草稿机”(小模型)和一个“权威审核员”(大模型)的协作范式,从根本上改变了推理流程。xLLM 不仅实现了这一范式,更通过一系列创新的系统架构设计,解决了将其投入实际生产时面临的计算、通信、调度等核心挑战。
演讲提纲:
- 大模型推理的挑战与投机式推理原理
- 当前大模型推理的延迟与计算资源矛盾
- 投机式推理的基本思想:用小模型“草案”引导大模型“验证”的加速范式
- xLLM 架构总览
- 设计目标:面向国产芯片的高性能、高稳定的企业级LLM部署引擎
- 核心功能介绍:
- 深度解耦的分布式推理:计算(专家)、调度、KV Cache、数据(输入/输出)的分离,为动态调度提供基础
- 全局多级KV Cache池:统一的内存抽象,支持跨请求、跨节点的快速缓存访问与复用,是投机候选序列生成与验证的关键
- 全局智能调度器:具备全局视图,能够协调草稿模型与主模型的执行,并实施严格的SLO保证
- 核心创新与工程挑战破解
- 挑战一:通信与主机开销
- 问题:中心式验证成为性能瓶颈,数据往返延迟抵消加速收益
- 解决方案:
- 逻辑下沉与本地缓存:将验证逻辑从master节点移至分布式子worker节点,减少数据往返
- 异步流水线调度:让输入准备与模型执行重叠进行,隐藏延迟
- 挑战二:大规模分布式部署支持
- 问题:投机推理在大规模集群上的高效运行问题
- 解决方案:适配DP并行与PD分离,保证每个节点的行为一致
- 挑战三:不同注意力结构的适配
- 问题:不同模型的KV cache缓存机制不同
- 解决方案:动态适配多种注意力变体,保证投机过程的正确性与内存效率
- 总结展望
听众收益:
- 深入理解投机式推理的工业级实现方案
- 掌握构建高性能、可扩展大模型推理系统的关键架构设计思想
- 了解工业界在降低大模型服务成本、提升集群效率方面的前沿工程实践与优化技巧
关注主办方(InfoQ)


联系我们
交通指南
上海虹桥祥源希尔顿酒店
Hilton Shanghai Hongqiao
地址:上海市红松东路1116号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手