2008-2017 年在清华大学电子系就读并获得博士学位。毕业后加入百度昆仑芯团队,作为技术骨干参与了人工智能芯片的研发与落地。于 2020 年加入快手算法引擎部,现担任计算引擎架构组负责人,主导了快手预估引擎的重要技术升级,支撑了快手从 SIM 系列到 OneRec 系列的模型优化与上线。
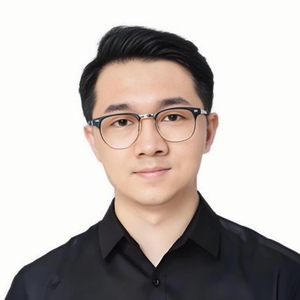
专题演讲嘉宾:柳嘉强
快手计算引擎架构负责人
by 柳嘉强
快手
计算引擎架构负责人随着深度学习推荐模型(DLRM)的广泛应用,推荐系统的算力重心正从以CPU为主全面转向以GPU为主。与此同时,生成式推荐的兴起进一步放大了算力需求,而异构硬件之间增速不均衡的矛盾也愈发突出。传统的资源供给模式已难以兼顾弹性、效率与稳定性,推动推荐系统底层基础设施走向算力池化成为必然选择。
本次演讲将系统阐述快手在推荐系统算力池化方向上的思考与实践。首先,我们将分析池化的三大驱动力:DLRM推动资源重心向GPU转移、生成式推荐带来的算力需求激增,以及异构算力发展节奏不匹配所带来的系统性挑战。
在此基础上,我们将剖析池化落地过程中面临的三组核心矛盾:一是服务分散化与网络传输开销之间的矛盾;二是资源灵活扩展与物理资源紧耦合之间的矛盾;三是资源高效利用与严格隔离及服务稳定性之间的矛盾。这些矛盾构成了池化方案设计的关键约束。
在实践层面,我们将重点介绍快手围绕上述挑战所构建的三项关键技术:面向推荐系统的高性能RDMA互联协议,实现跨节点高效通信;多维度极致CPU卸载,将非核心计算从GPU路径剥离;以及统一智能调度框架,在资源隔离与利用率之间取得精细平衡。
最后,我们将总结池化实践带来的收益,并对未来演进方向进行展望。通过算力池化,快手正以“新基建”支撑“新智能”,为生成式推荐时代的规模化演进奠定坚实的算力基础。新基建”支撑起推荐系统的“新智能”,并为未来更大规模的模型演进提供基础设施层面的无限可能。
演讲提纲:
- 为什么要做池化?
- 随着 DLRM 的应用,推荐系统资源从以 CPU 为主转向以 GPU 为主
- 生成式推荐对算力的需求持续增加
- 异构算力增速不均衡现象持续扩大
- 池化面临的挑战
- 服务分散化与网络传输开销之间的矛盾
- 资源灵活扩展和物理资源之间不可避免耦合的矛盾
- 资源高效利用与资源隔离及服务稳定性要求之间的矛盾
- 快手池化的实践
- 面向推荐系统的高性能 RDMA 互联协议
- 多维度极致 CPU 卸载
- 统一智能调度框架
- 总结与展望
听众收益:
- 了解推荐系统基建的发展历史和我们认为的演进方向
- 学习快手在池化过程中的技术经验
关注主办方(InfoQ)


联系我们
交通指南
上海虹桥祥源希尔顿酒店
Hilton Shanghai Hongqiao
地址:上海市红松东路1116号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手