北京邮电大学通信与信息系统博士,师承两院院士陈俊亮老师,在搜索推荐和机器翻译等人工智能相关领域有十年以上研发经验。有 10+ICLR/ICASSP 等顶会论文和国内外专利,带领团队获得 WMT/WAT NEWS/DOMAIN/QE/APE 冠军。
讲师介绍
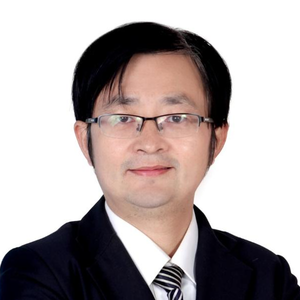
专题演讲嘉宾:杨浩
华为高级技术专家,人工智能科学家
议题介绍
演讲:基于昇腾算力的大模型推理加速研究与实践
以 AI Coding 长上下文场景为牵引,分析昇腾推理面临的四大核心挑战:算力利用率低、KV Cache 开销大、首 Token 延迟高以及多卡通信瓶颈,并围绕吞吐、时延、显存占用和 MFU 等关键指标展开系统性优化。
本次分享将沿着「研究 + 实践」两条主线展开:研究部分聚焦推理性能瓶颈分析与下一代算力演进;实践部分重点介绍基于 A3 平台的 Infra 调度优化,以及 TurboQuant 算子的工程落地,结合具体技术方案与实践收益,完整呈现从问题分析、技术优化到效果验证和未来展望的全过程。
演讲提纲
- AI 推理性能现状与目标
- AI Coding 长上下文场景最能放大访存、通信、显存瓶颈,长序列下 KV 随上下文线性膨胀。以模型量化(W4A8)和 KV Cache 量化为基础手段,目标是提吞吐、降 TTFT、压显存。
- 昇腾推理 Infra 加速实践
- 以昇腾 A3 为主力算力,落地 PD 分离、投机推理、动态批处理,并通过分级 KV 缓存与多卡并行调度,实现通信计算重叠。在并发与时延间找最优配比,给出 A3 实测数据
- 在 精度不变的前提下,摸高场景取得收益:1M 长序列请求,并发数从 4 提升到 10,提升 2.5 倍
- CANN 融合算子加速实践
- 核心是 TurboQuant:基于 Hadamard 旋转域量化,实现权重近优量化与 KV 3~4bit 压缩。用 CANN/Ascend C 融合算子链,消除中间 buffer、减少 kernel 调度,算子随 CANN 商发、vLLM-Ascend 主版本落地
- 在精度不变的前提下,业务场景取得收益:3P1D 架构下,TPOT 维持 30ms、TTFT 控制在 10s 以内,吞吐提升 3 倍 +
- 下一代昇腾与异构算力思考
- 结合昇腾 950 的应用进展,介绍其代际算力提升与适配。进一步探索异构算力池化、训推一体与近存互联,支撑复杂 Agent 和超大模型场景
听众收益:
- 理解 AI Coding 长上下文场景下,算力利用率、KV Cache、首 Token 延迟及多卡通信等核心瓶颈,了解 PD 分离、投机推理、动态批处理、分级 KV 缓存等 Infra 优化技术,以及它们在吞吐、时延和显存优化中的应用
- 理解低比特量化、KV Cache 压缩与融合算子的优化思路,掌握从算法设计、算子开发到推理框架集成的关键路径,并通过 A3 平台实测案例了解相关技术在长上下文场景中的性能收益
关注主办方(InfoQ)
联系我们
交通指南
北京新云南皇冠假日酒店
Crowne Plaza Beijing Sun Palace
地址:北京市
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手