负责阿里专有云大模型推理性能优化与 ASpeed 推理服务平台建设,聚焦低精度计算、推理引擎、高性能算子、超节点并行及集群调度。
讲师介绍
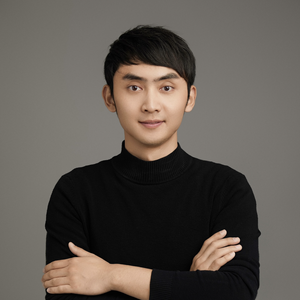
专题演讲嘉宾:冯梦轲(翼宏)
阿里云高级技术专家
议题介绍
演讲:从真实 Agent 负载到超节点推理:M890 优化与 ASpeed 集群协同
问题背景:
- Agent 应用将大模型推理带入多轮交互、工具调用与上下文持续增长的场景。请求之间的依赖、工具等待和跨轮缓存复用,共同改变了服务的性能瓶颈与资源需求。如何在模型响应时延约束下,提高每张加速卡可交付的服务能力,成为推理系统优化的核心问题。
方案与方法论:
- 本分享以 Abench、M890P加速卡 与 ASpeed 为主线,介绍贯穿评测、执行和调度的优化方法:通过 Abench 回放真实 Agent 轨迹,保留会话轮次、上下文增长与工具等待,以服务等级目标(SLO)评估容量;在 PPU1.5 上结合低精度、MoE 算子和推测解码优化执行路径;在超节点中协同设计并行策略、计算通信重叠、KV Cache 复用及 Prefill/Decode 资源配比;最后结合 ASpeed,讨论请求路由、弹性扩缩容与多模型资源共享的协作机制。
实施效果:
- 针对 DeepSeek-v4 系列模型,累计实现 7.4x 性能提升;并通过 ASpeed 集群弹性推理能力,进一步降低 71.9% 的硬件成本。
演讲提纲
- 用 Abench 建立 Agent 负载评测:
多轮依赖、工具等待的 Trace 回放、SLO 容量搜索,以及首轮和后续轮次的时延分析。
- PPU1.5 上的执行优化与收益取舍:
FP8/MXFP4、MoE 执行路径与推测解码,如何共同影响吞吐、首 Token 时延和生成速度。
- 超节点中的并行、通信与缓存协同:
结合上下文并行正反案例,讨论专家并行、计算通信重叠、KV 分层与 P/D 配比。
- ASpeed 如何组织集群服务能力:
缓存感知路由、容量规划、多模型放置及会话恢复设计,以及面向真实负载的验证方法。
听众收益
-
掌握一套面向 Agent 多轮业务的评测方法,明确会话并发、请求压力、缓存行为与 SLO 的关系。
-
建立从算子、并行通信到集群调度的性能分析思路,判断低精度、推测解码和缓存复用的适用条件。
-
获得可用于方案评审与上线验证的实践框架:固定负载和质量要求,逐项对照优化,统一统计时延、有效吞吐与资源成本。
关注主办方(InfoQ)
联系我们
交通指南
北京新云南皇冠假日酒店
Crowne Plaza Beijing Sun Palace
地址:北京市
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手