多模态大模型正在融合文本、图像、音频、视频等多种模态,推动跨模态理解与生成能力不... 展开 >
多模态从技术突破到创新应用落地
会议室:秦宫出品人:高婷婷
- Topic 1
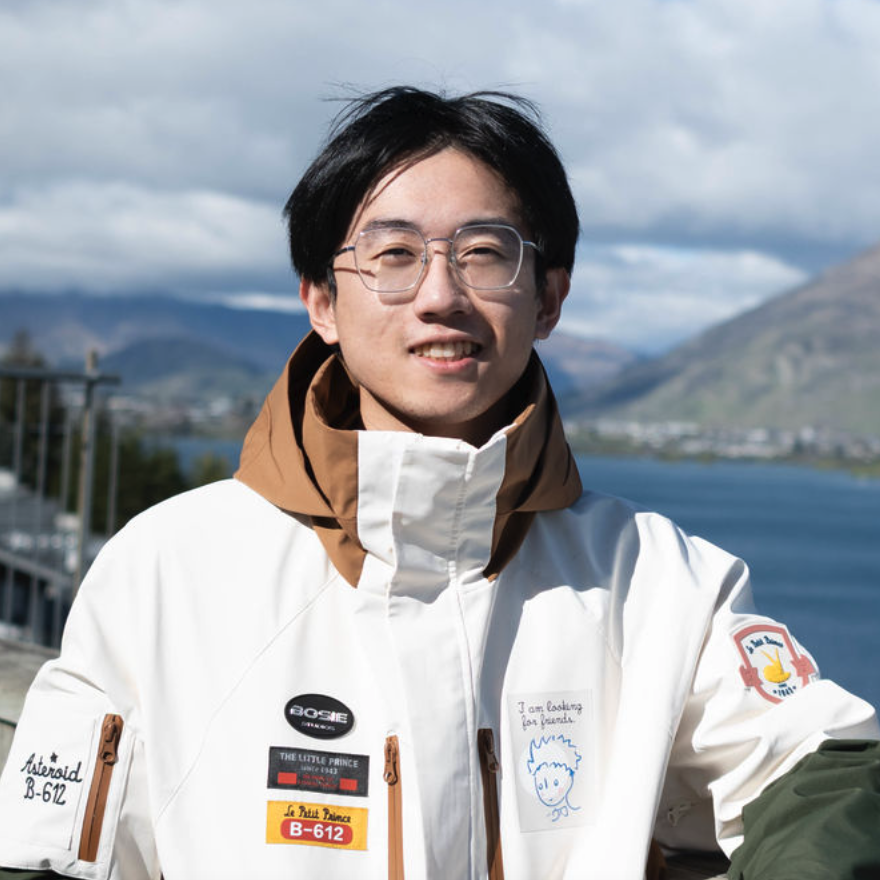
余天予
清华大学 博士生 - Topic 2
宋阳
OPPO 算法专家 - Topic 3
吴翔宇
快手 算法专家 - Topic 4
邵帅
腾讯混元 专家研究员
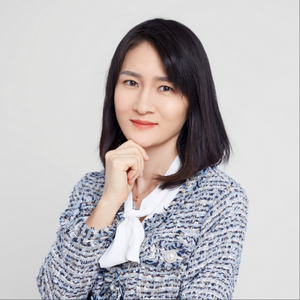
专题出品人:高婷婷
快手多模态大模型 Keye 及大模型落地应用负责人
长期深耕多模态大模型技术研发与商业化落地,现任快手Keye多模态大模型及大模型应用负责人。主导研发的Keye多模态大模型,在综合感知能力对标同规模顶尖模型的基础上,在视频理解场景实现显著优势,并在开源社区引发广泛关注。
同时持续推进大模型工业化落地,构建覆盖短视频内容理解、直播实时交互、电商智能互动、广告AIGC的全链路技术方案,有效推动技术价值与商业价值的协同增长。
地点:秦宫
专题:多模态从技术突破到创新应用落地
多模态大模型正在融合文本、图像、音频、视频等多种模态,推动跨模态理解与生成能力不断增强。本专题将聚焦多模态模型的最新技术进展与实践,分享应用场景与创新价值,探讨其在场景落地中的机遇与挑战。
by 余天予
清华大学
博士生多模态大模型作为人工智能的最前沿领域之一正在快速发展。然而,多模态大模型的训练与推理效率已成为影响其普及性与可扩展性的核心瓶颈。为应对这一挑战,我们推出 MiniCPM-V 4.5 训练方案,兼具训练推理的高效性和强大的性能。我们在模型结构、数据策略与训练方法三个方面进行了关键改进:使用了统一的 3D-Resampler 模型架构,实现对图像与视频的高压缩率紧凑编码;构建了统一的文档知识与文本识别学习范式,无需繁重的数据工程;并设计了混合强化学习策略,使模型在短推理与长推理两种模式下均具备卓越能力。
MiniCPM-V 4.5 在 OpenCompass 评测中超越了广泛使用的闭源模型(如 GPT-4o-latest)以及显著更大的开源模型(如 Qwen2.5-VL 72B)。MiniCPM-V 4.5 在保持强大性能的同时也展现出极高的效率。例如,在广泛采用的 VideoMME 基准测试中,MiniCPM-V 4.5 在 30B 规模以下的模型中取得了最优秀的性能,甚至仅用 46.7% 的 GPU 显存成本和 8.7% 的推理时间(相较于 Qwen2.5-VL 7B)。
演讲提纲
- 多模态大模型的效率瓶颈
- 结构:通过 3D-Resampler 提高压缩率
- 数据:通过统一文档&OCR学习简化数据工程
- 训练:混合强化学习提高训练效率
您认为,这样的技术在实践过程中有哪些痛点?
- 3D-Resampler 在高压缩率的同时对于空间特征的编码有所取舍;
- 统一训练的噪声参数有一定敏感性;
- 混合训练的比例参数具有一定敏感性。
您的演讲有哪些前沿亮点?
通过 3D-Resampler 提高压缩率、通过统一文档&OCR学习简化数据工程、混合强化学习提高训练效率。
听众收益
- 多模态大模型效率瓶颈分析;
- 多模态大模型的结构、数据、训练高效率构建方案。
by 宋阳
OPPO
算法专家OPPO在2025年开发者大会上发布了“AI实景对话”首次让助手“走出屏幕”。在线下门店场景中,我们与大众点评达成深度合作,支持用户在逛街时(CityWalk),通过实景对话功能调用手机中大众点评的店铺信息与菜单数据,完成类似“AI版探店助手”的体验。即使站在餐厅门口,也无需手动搜索,AI即可提供评价、推荐菜品与价格信息。
CityWalk Agent作为“AI实景对话”一个独特的Agent,在实际场景中遇到并解决了诸多技术挑战:
- 路由意图:粗粒度路由识别CityWalk领域,细粒度意图识别锚定上屏卡。
- 店铺指代:结合用户多轮语音提问和点击动作准确关联店铺名,支持随时打断。
- 记忆管理:综合历史对话和历史画面,动态管理视频记忆。
- 后处理:基于poi坐标距离和相似度过滤,店名难例rag和图像超清。
通过组合优化,CityWalk Agent意图店名的召回率和准确率达到了90%以上的效果。
演讲提纲
1、同行VideoAgent产品或有影响力的开源项目
2、CityWalk Agent整体交互流程图和“AI实景对话”其它Agent
3、技术拆解(路由意图、店铺指代、记忆管理)和实际案例,推荐AndesVL
4、VideoAgent未来技术展望
您认为,这样的技术在实践过程中有哪些痛点?
在流式视频问答中,将videoqa转化为单帧imageqa可以解决大部分问题,但是仍然存在多画幅问题,目前取帧数量动态调整算法尚处于研究阶段,过多取帧会引入更大时延,过少取帧会牺牲效果,于是产生了tradeoff。
您的演讲有哪些前沿亮点?
- 点击链路:通过主体检测圈定店铺牌匾grounding,结合visual prompt进行准确的店铺锚定,在多店场景尤为好用。
- 视频记忆:围绕时间戳的记忆回溯,综合历史qa和历史caption检索店铺,无需用户持续对着店铺拍摄。
- 反思模块:结合下游mcp反馈,避开非餐饮短板领域,持续提升意图和上屏卡的准确率。
听众收益
- CityWalk Agent整体交互链路和各子模块设计思路;
- 同行VideoAgent产品或者有影响力的开源项目;
- VideoAgent未来技术展望,例如端侧omni和云端vlm协作。
by 吴翔宇
快手
算法专家随着直播行业的飞速发展,快手平台每天产生海量的直播内容。传统的技术手段在内容理解深度、用户交互实时性、以及个性化体验优化方面逐渐面临瓶颈。例如,如何精准刻画数亿用户与千万主播之间的匹配关系?如何实现主播与观众之间更自然、有趣的互动?又如何推进用户对主播的第一印象的形成来促进主粉关系的转化?这些问题在大模型能力日新月异的当下,有了越发清晰的回答。
演讲提纲
- 内容理解升级——从“标签”到“灵魂刻画”
- 大模型都是夸夸怪,用户对主播的评论也都是正向居多,我们怎么能够相对客观地刻画主播的特点与用户的偏好?
- 智能交互升级——从“工具”到“AI分身”
- 主播的服务能力与用户的体验息息相关,本节将介绍我们如何通过个性化的主播分身的打造,对主播全链路的服务质量进行升级,打造全新的交互方式。
- 体验优化与关系转化——从“惊鸿一瞥”到“一见如故”
- 用户对新主播的认知很少,那么我们如何通过主播信息的外显,来优化用户与主播的第一触点,进而带动用户筛选效率与看播体验的提升。
您认为,这样的技术在实践过程中有哪些痛点?
-
如何在有限资源下做好U-A的个性化;
-
如何差异性优化头部好主播与中长尾主播的策略。
您的演讲有哪些前沿亮点?
-
技术创新上,我们如何通过多模态大模型与用户反馈信息,实现主播与用户的理解,并通过强化学习进一步拟合用户对主播的偏好,带来直播业务的提升。
-
业务落地上,在直播这样相对成熟的业务场景下,大模型能力如何优化用户的看播体验,提高主播的服务质量。
听众收益
- 了解到在应用视角下,大模型如何联动用户行为进行兴趣建模。
- 了解到在大模型时代下,快手尤其是快手直播的一些创新和变化。
by 邵帅
腾讯混元
专家研究员随着生成式多模态大模型技术的爆发,游戏行业正经历从“人工密集型”到“AI原生驱动”的颠覆性变革。面对高成本、长周期、创意同质化的行业瓶颈,AIGC通过文本、图像、视频、3D、代码等多模态生成,已实现美术、设计、开发的效率提升。然而,游戏美学、风格一致性控制、物理规则、生成内容版权争议等问题仍待解决。本次分享将介绍腾讯在AIGCx游戏领域的技术进展和业务实践。
演讲提纲
- 游戏创作的痛点与AIGC的机遇
- 生成式大模型赋能游戏的核心技术生成质量与游戏美学
- 头部企业的工业化实践交互逻辑的升级
- 未来展望:游戏创作的AI原生时代
您认为,这样的技术在实践过程中有哪些痛点?
- 视觉质量要求高
- 高质量数据稀缺
- 普通用户与专业设计师的交互习惯差异
您的演讲有哪些前沿亮点?
- 最新的 AIGC 创作的交互方式
- 腾讯公司在 AI + 游戏创作的最新实践经验
听众收益
- 了解头部游戏公司的AIGC技术落地方法论
- 预判游戏行业与AIGC融合的未来发展方向
关注主办方(InfoQ)
联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Realm Beijing
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手