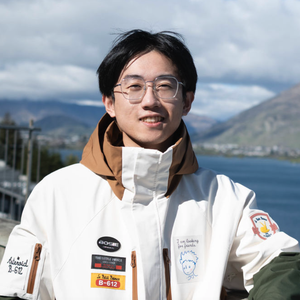
清华大学自然语言处理实验室博士生,MiniCPM-V 系列多模态大模型核心作者,发表 CVPR 等人工智能顶会论文多篇,主要研究方向为多模态大模型。
讲师介绍
议题介绍
地点:秦宫
所属专题:多模态从技术突破到创新应用落地
演讲:突破多模态大模型的效率瓶颈:结构、数据与训练优化
多模态大模型作为人工智能的最前沿领域之一正在快速发展。然而,多模态大模型的训练与推理效率已成为影响其普及性与可扩展性的核心瓶颈。为应对这一挑战,我们推出 MiniCPM-V 4.5 训练方案,兼具训练推理的高效性和强大的性能。我们在模型结构、数据策略与训练方法三个方面进行了关键改进:使用了统一的 3D-Resampler 模型架构,实现对图像与视频的高压缩率紧凑编码;构建了统一的文档知识与文本识别学习范式,无需繁重的数据工程;并设计了混合强化学习策略,使模型在短推理与长推理两种模式下均具备卓越能力。
MiniCPM-V 4.5 在 OpenCompass 评测中超越了广泛使用的闭源模型(如 GPT-4o-latest)以及显著更大的开源模型(如 Qwen2.5-VL 72B)。MiniCPM-V 4.5 在保持强大性能的同时也展现出极高的效率。例如,在广泛采用的 VideoMME 基准测试中,MiniCPM-V 4.5 在 30B 规模以下的模型中取得了最优秀的性能,甚至仅用 46.7% 的 GPU 显存成本和 8.7% 的推理时间(相较于 Qwen2.5-VL 7B)。
演讲提纲
- 多模态大模型的效率瓶颈
- 结构:通过 3D-Resampler 提高压缩率
- 数据:通过统一文档&OCR学习简化数据工程
- 训练:混合强化学习提高训练效率
您认为,这样的技术在实践过程中有哪些痛点?
- 3D-Resampler 在高压缩率的同时对于空间特征的编码有所取舍;
- 统一训练的噪声参数有一定敏感性;
- 混合训练的比例参数具有一定敏感性。
您的演讲有哪些前沿亮点?
通过 3D-Resampler 提高压缩率、通过统一文档&OCR学习简化数据工程、混合强化学习提高训练效率。
听众收益
- 多模态大模型效率瓶颈分析;
- 多模态大模型的结构、数据、训练高效率构建方案。
关注主办方(InfoQ)
联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Realm Beijing
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手