聚焦AI软硬件及生态系统的建设,讨论如何打造高效的AI开发与应用环境。
... 展开 >AI 基础设施与生态构建
会议室:201AB出品人:ZOMI 酱
- Topic 1
曹宇
阿里巴巴 算法专家 - Topic 2
尹良升
SGLang 核心开发者 - Topic 3
马介悦
蚂蚁集团 高级专家 - Topic 4
武云峰
Zilliz 技术总监
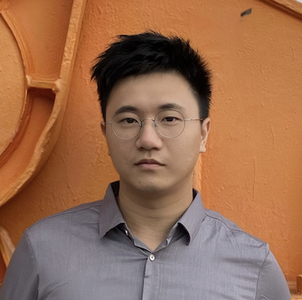
专题出品人:ZOMI 酱
华为昇腾技术专家
ZOMI 酱,华为昇腾生态技术专家,第一作者著有《 AI 系统:原理与架构》、《深度学习:原理与实践》、《深度强化学习:原理与实践》3 本专著,并累积发表了 113 篇发明类专利。B 站 AI 领域著名 UP 主( ZOMI 酱),全网播放量超千万。
地点:201AB
专题:AI 基础设施与生态构建
聚焦AI软硬件及生态系统的建设,讨论如何打造高效的AI开发与应用环境。
by 曹宇
阿里巴巴
算法专家强化学习作为推动大语言模型进一步提升智能程度的手段,一直是大语言模型训练环节中最核心且复杂的环节。其中的复杂度不仅仅体现在其算法方面,也体现在其系统的整体要求上,本次分享从传统的 RLHF 系统开始,结合算法实践展示出 RL 系统的现状及发展脉络。通过具体的实践,与从业者共同探讨未来超大规模 RL 的发展方向,分享内容既包括理论基础,也包含业界实践,最后开源生态及社区共建也会涉及。
演讲提纲:
- RLHF 系统:从理论到工程化的起点
-
理论基础
- RLHF 核心框架:人类反馈如何与强化学习结合(奖励建模、策略优化)
- 关键公式解析:KL 散度约束、奖励函数设计、策略梯度更新
-
传统系统架构
- 数据闭环:偏好数据收集→奖励模型训练→策略微调
- 工程痛点:数据标注成本高、训练稳定性差、系统耦合性强
-
发展脉络
- 早期实践:OpenAI 的 InstructGPT DPO
- 典型挑战:反馈稀疏性、奖励模型过拟合、策略灾难性遗忘
- 算法突破与实践:从 PPO 到更优解
-
核心算法挑战
- 探索 - 利用权衡:如何在生成多样性(Exploration)与策略收敛(Exploitation)间平衡
- 稀疏奖励优化:长文本生成中的延迟奖励问题(如对话连贯性)
- 对抗性训练:如何避免模型“欺骗”奖励模型(Reward Hacking)
-
实践案例
- PPO 改进:Clipped Objective、自适应 KL 惩罚项设计
- 课程学习:分阶段训练(从短文本到长文本生成)
- 混合监督:RL 与 SFT(监督微调)的动态权重调整
- 超大规模 RL 系统的工程革命
-
系统架构升级
- 分布式训练框架:SPMD MPMD
- 混合并行策略:数据并行(偏好数据分片)+ 模型并行(万亿级参数切分)
- 内存优化:梯度检查点、Off-policy 经验回放池设计
-
阿里巴巴、字节等的业界实践
- 未来方向:算法、系统与理论的融合
- 算法前沿
- 多模态反馈融合:文本、人类评分、物理世界信号联合优化
- 离线强化学习(Offline RL):利用历史数据降低交互成本
- 自对齐(Self-Alignment):模型自我迭代生成高质量反馈
-
系统规模化
- 动态资源调度:按训练阶段弹性分配算力(如奖励模型 vs. 策略模型)
-
理论开放问题
- 收敛性证明:超大规模 RL 训练的数学边界
- 泛化能力:从训练任务到开放域场景的迁移机制
- 开源生态与社区共建
- 开源项目全景
- openrlhf verl areal
- 结语
从 RLHF 到超大规模 RL 系统,技术演进需算法创新、工程极致与生态协作三者共振。未来的智能突破,或许始于今日的开源开放与跨领域共创。
您认为,这样的技术在实践过程中有哪些痛点?
成本高
您的演讲有哪些前沿亮点?
算法融合系统
by 尹良升
SGLang 核心开发者开源大语言模型快速发展,如 Deepseek V3 和 R1,展现了卓越的性能表现,同时其高效的部署方案大幅降低了推理成本。该方案整合了多项前沿技术,包括大规模专家并行、注意力并行、推测解码、Prefill 与 Decode 的分离部署,以及高效的 KV 缓存落盘实现。这些技术的结合,构成了当前最先进、最高效的大语言模型推理体系。
作为主流开源推理框架之一,SGLang 已深度集成这些技术。本次演讲将深入解析这些关键技术,并探讨其在实际应用中的优化与落地,同时结合最新版本展示如何以极低的成本部署 Deepseek V3/R1 等开源大语言模型。
演讲提纲:
-
PD 分离技术的高效实现
-
大规模专家并行、注意力并行等多种并行方案的兼容和高效部署
-
多级 KV Cache 的缓存设计
-
高效的 Eagle 推测解码、引用推测解码和基于语法的结构解码设计
-
SGLang 社区生态与发展
您认为,这样的技术在实践过程中有哪些痛点?
-
高质量的开发人员人手不足
-
技术兼容性问题
您的演讲有哪些前沿亮点?
被多个行业巨头采用的推理引擎背后,多项核心技术深度解析
听众收益:
-
学习前沿大模型推理技术的开源实现
-
学习开源社区的开发经验和管理方案
by 马介悦
蚂蚁集团
高级专家随着ChatGPT的横空出世,在Scaling Law的驱动下,大模型训练规模呈指数级增长,但随之而来的稳定性问题频发,导致大量GPU计算资源浪费。如何实现训练异常的快速发现与容错,保障模型第一时间恢复训练,成为提升训练效率的关键。
本次演讲将从万卡大模型训练的痛点出发,以业界通用的有效训练时长为核心指标,系统性介绍大模型训练稳定性的挑战,并结合蚂蚁集团的实践经验,重点介绍开源项目DLRover(分布式训练容错框架)和XPUTimer(性能分析工具),整体提升训练稳定性的关键技术难点。目前业界对蚂蚁的国产卡训练也表现了极大的兴趣,本次演讲也会把国产卡场景下的踩坑经历和大家一起分享。
演讲提纲
- 引言
- 万卡大模型训练的痛点和挑战
- 业界SOTA
- 基础设施的交付和运维挑战
- 任务快速容错挑战
- 核心技术介绍与实践:DLRover、XPUTimer
- 典型案例分析
- 任务hang解决方案
- 慢节点探测与定位
- 国产卡场景
- 总结展望
您认为,这样的技术在实践过程中有哪些痛点?
- 国产卡异构性较强,我们只是介绍了昇腾的产品,其他诸如寒武纪等其他国产卡并未有涉及。
您的演讲有哪些前沿亮点?
- 万卡规模训练如何高效容错,探测性能瓶颈,以及常见疑难问题的解决方案
- 国产卡场景下如何提升训练稳定性
- 如何使用先进的性能分析工具xputimer
听众收益
- 了解到大规模训练场景下的关键挑战与解决方案
- 了解到蚂蚁集团在这方面的开源贡献,并应用到自己的生产环境实践中
by 武云峰
Zilliz
技术总监在GenAI 快速发展的背景下,企业在使用向量数据库时面临多重挑战。当前用户在大量使用向量数据库过程中遇到的主要痛点有:
- 数据迁移复杂,切换成本高:随着业务需求的变化,企业可能需要更换向量数据库。然而,不同向量数据库在数据格式、查询接口和性能指标等方面存在差异,导致数据迁移成为一项复杂且高成本的任务。传统的 ETL 工具主要针对结构化数据,缺乏对向量数据特性的支持,使得向量数据库之间的数据迁移更加困难。
- 数据合规性与主权问题:在全球部署 AI 应用时,企业需遵守各地的数据保护法规,如 GDPR 等。传统基础设施在灵活适应不同地区的合规需求方面存在限制,难以满足数据主权和合规性的要求。
- 数据模型演进(Schema Evolution)困难:随着业务的发展,数据模型可能需要变更,例如增加新的向量或标量字段,并填充历史数据。在传统数据库中,模式演进可能导致数据不一致或需要大量的手动干预
过去一年,Zilliz Cloud在这几个问题上取得了一些关键进展:开发专门针对向量数据的迁移工具,如基于 Apache SeaTunnel 的 VTS(Vector Transport Service),以支持向量和非结构化数据的高效迁移;采用 BYOC(Bring Your Own Cloud)模式,使组织能够在自己的私有云环境中托管数据,确保数据主权和合规性。同时,实施透明加密机制和严格的访问控制,保障数据安全;引入支持 Schema Evolution with data backfill 的机制,保证上层业务模型发生改变时,能够快速应对。
演讲提纲
- AI基础设施的行业重塑浪潮
- AI Gen时代对数据基础设施的新需求
- 向量数据库在生成式AI中的关键角色
- 从存储数据到理解数据:基础设施的范式转变
- 当前用户或业务遇到痛点问题
- 数据迁移复杂,切换成本高
- 数据合规性与主权问题
- 数据模型演进(Schema Evolution)困难
- 核心能力进展与技术亮点
- 数据迁移复杂,切换成本高,让数据迁移更像“流动”而不是“搬家”
- 向量数据从本地、第三方云无缝迁移
- 集群内迁移场景的灵活调度:降低业务中断、支持弹性资源伸缩
- 用例:客户在训练/推理阶段的多集群协同处理
- 数据合规性与主权问题,引入BYOC Deployment Mode
- 企业能够在自己的云环境中托管数据,确保数据主权和合规性,又可以实现服务的完全托管
- TDE(Transparent Data Encryption)如何守护AI时代的数据隐私
- 高级数据处理:从数据库走向智能数据平台
- 支持数据模型的演化
- 更适配AI场景中的模型重训练、数据补充等操作
- 数据迁移复杂,切换成本高,让数据迁移更像“流动”而不是“搬家”
- 构建全球分布式的AI数据云
- Geo Replication:多地域/多云同步,提升响应速度与容灾能力
- 托管模型(Model Hosting):下一步计划支持轻量推理与在线嵌入
- 服务全球AI开发者,打造“模型 + 数据 + 算法”的一体化平台
听众收益
- 理解向量数据库在AI系统中的核心价值与应用场景
- 获取AI基础设施在数据迁移、安全合规、数据处理方面的最新实践经验
- 了解如何通过Zilliz Cloud快速构建企业级、可演进的AI数据平台
- 获取Zilliz Cloud在Geo Replication、托管模型等未来能力的前瞻信息
关注主办方(InfoQ)
联系我们
交通指南
北京国际会议中心
Beijing International Convention Center
地址:北京市朝阳区北辰东路8号
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手