目前负责开源项目DLRover,专注于AI训练引擎的稳定性和性能相关工作。硕士毕业于东南大学计算机系,有超过十年的系统软件及云计算研发经验。先后就职于阿里云,蚂蚁集团,并担任蚂蚁容器团队负责人。
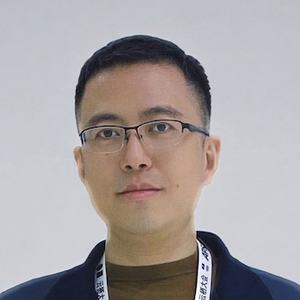
专题演讲嘉宾:马介悦
蚂蚁集团高级专家
by 马介悦
蚂蚁集团
高级专家随着ChatGPT的横空出世,在Scaling Law的驱动下,大模型训练规模呈指数级增长,但随之而来的稳定性问题频发,导致大量GPU计算资源浪费。如何实现训练异常的快速发现与容错,保障模型第一时间恢复训练,成为提升训练效率的关键。
本次演讲将从万卡大模型训练的痛点出发,以业界通用的有效训练时长为核心指标,系统性介绍大模型训练稳定性的挑战,并结合蚂蚁集团的实践经验,重点介绍开源项目DLRover(分布式训练容错框架)和XPUTimer(性能分析工具),整体提升训练稳定性的关键技术难点。目前业界对蚂蚁的国产卡训练也表现了极大的兴趣,本次演讲也会把国产卡场景下的踩坑经历和大家一起分享。
演讲提纲
- 引言
- 万卡大模型训练的痛点和挑战
- 业界SOTA
- 基础设施的交付和运维挑战
- 任务快速容错挑战
- 核心技术介绍与实践:DLRover、XPUTimer
- 典型案例分析
- 任务hang解决方案
- 慢节点探测与定位
- 国产卡场景
- 总结展望
您认为,这样的技术在实践过程中有哪些痛点?
- 国产卡异构性较强,我们只是介绍了昇腾的产品,其他诸如寒武纪等其他国产卡并未有涉及。
您的演讲有哪些前沿亮点?
- 万卡规模训练如何高效容错,探测性能瓶颈,以及常见疑难问题的解决方案
- 国产卡场景下如何提升训练稳定性
- 如何使用先进的性能分析工具xputimer
听众收益
- 了解到大规模训练场景下的关键挑战与解决方案
- 了解到蚂蚁集团在这方面的开源贡献,并应用到自己的生产环境实践中
关注主办方(InfoQ)


联系我们
交通指南
北京国际会议中心
Beijing International Convention Center
地址:北京市朝阳区北辰东路8号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手