阿里巴巴算法专家,主要从事大模型相关的算法研究及训练工作,对于强化学习在大模型中的应用有多年研究及实际工作经验。参与过阿里巴巴多个大模型的人类反馈强化学习,推理模型的算法设计及实际训练,了解超大规模强化学习系统设计,对于大规模大语言模型的算法及系统协同设计有一定积累。
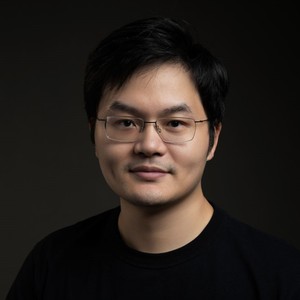
专题演讲嘉宾:曹宇
阿里巴巴算法专家
by 曹宇
阿里巴巴
算法专家强化学习作为推动大语言模型进一步提升智能程度的手段,一直是大语言模型训练环节中最核心且复杂的环节。其中的复杂度不仅仅体现在其算法方面,也体现在其系统的整体要求上,本次分享从传统的 RLHF 系统开始,结合算法实践展示出 RL 系统的现状及发展脉络。通过具体的实践,与从业者共同探讨未来超大规模 RL 的发展方向,分享内容既包括理论基础,也包含业界实践,最后开源生态及社区共建也会涉及。
演讲提纲:
- RLHF 系统:从理论到工程化的起点
-
理论基础
- RLHF 核心框架:人类反馈如何与强化学习结合(奖励建模、策略优化)
- 关键公式解析:KL 散度约束、奖励函数设计、策略梯度更新
-
传统系统架构
- 数据闭环:偏好数据收集→奖励模型训练→策略微调
- 工程痛点:数据标注成本高、训练稳定性差、系统耦合性强
-
发展脉络
- 早期实践:OpenAI 的 InstructGPT DPO
- 典型挑战:反馈稀疏性、奖励模型过拟合、策略灾难性遗忘
- 算法突破与实践:从 PPO 到更优解
-
核心算法挑战
- 探索 - 利用权衡:如何在生成多样性(Exploration)与策略收敛(Exploitation)间平衡
- 稀疏奖励优化:长文本生成中的延迟奖励问题(如对话连贯性)
- 对抗性训练:如何避免模型“欺骗”奖励模型(Reward Hacking)
-
实践案例
- PPO 改进:Clipped Objective、自适应 KL 惩罚项设计
- 课程学习:分阶段训练(从短文本到长文本生成)
- 混合监督:RL 与 SFT(监督微调)的动态权重调整
- 超大规模 RL 系统的工程革命
-
系统架构升级
- 分布式训练框架:SPMD MPMD
- 混合并行策略:数据并行(偏好数据分片)+ 模型并行(万亿级参数切分)
- 内存优化:梯度检查点、Off-policy 经验回放池设计
-
阿里巴巴、字节等的业界实践
- 未来方向:算法、系统与理论的融合
- 算法前沿
- 多模态反馈融合:文本、人类评分、物理世界信号联合优化
- 离线强化学习(Offline RL):利用历史数据降低交互成本
- 自对齐(Self-Alignment):模型自我迭代生成高质量反馈
-
系统规模化
- 动态资源调度:按训练阶段弹性分配算力(如奖励模型 vs. 策略模型)
-
理论开放问题
- 收敛性证明:超大规模 RL 训练的数学边界
- 泛化能力:从训练任务到开放域场景的迁移机制
- 开源生态与社区共建
- 开源项目全景
- openrlhf verl areal
- 结语
从 RLHF 到超大规模 RL 系统,技术演进需算法创新、工程极致与生态协作三者共振。未来的智能突破,或许始于今日的开源开放与跨领域共创。
您认为,这样的技术在实践过程中有哪些痛点?
成本高
您的演讲有哪些前沿亮点?
算法融合系统
关注主办方(InfoQ)


联系我们
交通指南
北京国际会议中心
Beijing International Convention Center
地址:北京市朝阳区北辰东路8号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手