大模型浪潮推动数据管理与分析进入全新阶段。本专题将探讨如何提升数据质量、优化检索... 展开 >
大模型时代的数据处理与分析
会议室:第二会议室B出品人:郭峰
- Topic 1
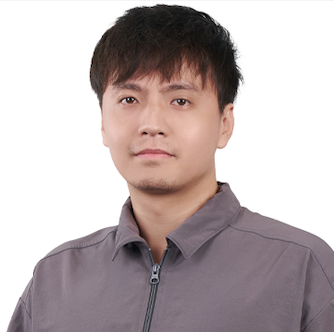
凌霄
货拉拉 大数据专家 - Topic 2
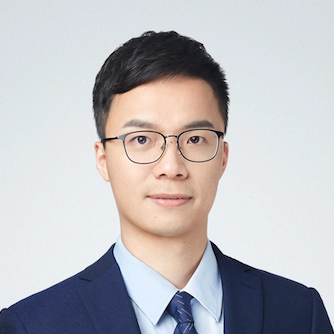
单海军
中电金信研究院 副院长 - Topic 3
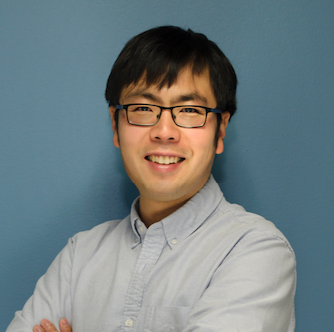
范斌
Alluxio VP of Technology - Topic 4
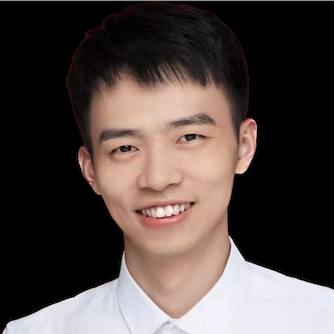
覃睿
BISHENG 联合创始人
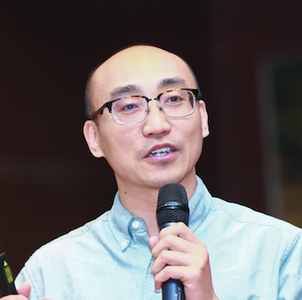
专题出品人:郭峰
DaoCloud 道客联合创始人兼首席技术官
郭峰,DaoCloud 道客 联合创始人兼首席技术官;曾就职于 EMC 中国研究院,担任云计算首席架构师/主任研究员,其间深度参与了OpenStack、CloudFoundry等分布式计算平台的早期研发与设计,对分布式系统、云原生、算力调度技术有深入研究,并在上述领域拥有23项美国专利,73项国内专利。2014 年,他联合创立 DaoCloud 道客,公司专注于云原生技术创新,已发展成为该领域的创新领导者,并入选国家专精特新小巨人企业。近一年,DaoCloud 在 Kubernetes 代码贡献排名中位列全球前三,持续推动开源共建。
地点:第二会议室B
专题:大模型时代的数据处理与分析
大模型浪潮推动数据管理与分析进入全新阶段。本专题将探讨如何提升数据质量、优化检索效率,构建智能化数据管理体系,让数据在大模型的应用中发挥最大效能。话题包括但不限于:
- 高质量数据集构建:数据筛选、清洗、标注,打造支撑大模型性能的优质数据集。
- RAG优化:提升数据索引与检索效率,让数据最大化赋能大模型应用。
- 智能数据管理:应对大模型时代的新挑战,覆盖数据治理、安全、存储与传输等关键环节。
本专题适合数据科学家、工程师、企业管理者等不同角色的从业者。通过实际案例分析和专家分享,参会者可以学习如何优化数据管理,提升大模型的应用效果,并为企业的 AI 落地提供更强的数据支撑。
by 凌霄
货拉拉
大数据专家大模型的迅猛发展正逐渐重构各类垂直领域的生产方式,其中大数据结合AI方向作为大模型元年就持续讨论的话题,对大数据行业尤其是数据分析产生了深刻的影响。
本次演讲将从业务场景出发(如:智能指标ChatBI、数据开发AISQL等),并结合真实的业务应用,阐述领域内的主要矛盾、相关的技术方案和选型。也希望和各位一起讨论大数据处理技术、企业数据模型、大模型等领域如何结合的痛点和相关问题。
演讲大纲
- 货拉拉指标场景的准确率挑战
- 准确率和通用性如何兼顾
- 指标领域知识理解问题
- 数据模型与规范性
- 可维护、轻量化、可观测如何解决
- 货拉拉在数据智能化探索过程中遇到哪些坑
- Text2SQL or Text2DSL
- Workflow如何结合Agent达到业务预期
- MCP是解决已有系统能力接入的银弹与否
- AI 对大数据平台的机遇与挑战
您认为,这样的技术在实践过程中有哪些痛点?
- 准确性与泛用性:如chatBI用于指标场景,但实践下来,技术路线和产品形态不一定适用其他子领域如数据开发
- 成本与收益:如没有风口的加持,对于人效的提升难量化,且短期并不能cover目前大多数企业动辄千万级别的智能化投入
- 其他:是改革还是革命问题,如业务使用方的惯性怎样改变如何与已在运行的业务体系兼容,动了蛋糕的冲突
听众收益
- 开拓数据xAI领域新思路,用新方法如何解决传统分析问题
- NL2DSL方式的探索经验
- 数据Agent的探索经验
by 单海军
中电金信研究院
副院长大模型训练调优演进很快,高质量的数据处理与标注也一直是大模型训练与调优的痛点。DeepSeek最新构建的大模型使用纯强化学习的方式进行大模型训练。未来大模型的训练是否还需标注的数据,数据构建标注是否还有意义?如何高效处理与构建,并进行指令数据的进化,值得研究与探索。
演讲提纲
- 背景介绍:大模型训练调优对数据的需求变化
- 大模型后训练数据准备与处理
- SFT指令数据构建及处理
- RLHF数据的构建与训练
- 大模型数据安全与版本管理
您认为,这样的技术在实践过程中有哪些痛点?
- 未来是否还需要数据标注悬而未决
- 如何保证数据的质量
- 如何降低人工标注数据的工作量
您的演讲有哪些前沿亮点?
- 端到端介绍大模型数据工程的处理链路
- 除了介绍SFT指令数据的构建之外,还会介绍SFT指令数据的进化等
听众收益
- 掌握和了解大模型数据工程处理的全链路
- 可以看到大模型数据处理的趋势
by 范斌
Alluxio
VP of Technology在 AWS S3 等云对象存储中将数据存储为 Parquet 文件,不仅在大规模数据湖中非常流行,而且还可作为用于训练和推理的轻量级特征存储,或作为用于检索增强生成(RAG)的文档存储。然而,直接从 S3 查询 PB 到 EB 级规模的数据湖所面对的共同挑战是速度很慢,延迟时间通常从数百毫秒到数秒不等。
此次演讲将介绍如何利用 Alluxio 作为超大规模数据湖上的高性能缓存和加速层,对 Parquet 文件进行查询。在不使用专用硬件,不更改数据格式或对象寻址方案,不从数据湖迁移数据的情况下,Alluxio 如何实现亚毫秒级的首字节时间(TTFB)性能,以及Alluxio 的吞吐量与集群规模的线性扩展。
演讲提纲
- 数据驱动型组织直接在云对象存储上存储和提供 Parquet 文件的普遍方式,以及给AI应用所带来的挑战;
- 应对挑战的常见解决办法有哪些;
- 实现Parquet 查询 1000 倍性能提升,Alluxio 系统架构及优化设计(单节点优化,可扩展的分布式层,计算卸载等);
- 低延迟存储方案的成本对比;
- 未来工作展望。
听众收益
- 了解Alluxio的架构和工作原理,并学习核心优化技术
- 了解数据湖查询性能优化实践,掌握查询优化的方法并了解实际案例
by 覃睿
BISHENG
联合创始人2月 OpenAI 推出 DeepResearch,3 月同类产品 Manus 国内出圈,3 月底字节开源通用智能体 Tars。2023 年初就曾爆火的 AutoGPT,其思想在今年再次被大家致敬,背后原因是包含 Computer use、Reasoning 模型、MCP 工具生态等在内技术成熟度的持续提升。
虽然能看到希望,但模型幻觉问题仍然存在、解决复杂问题能力仍待提升、垂直领域知识缺乏问题仍然存在。进一步地,如果想要在企业内场景落地,还将面对包含可控性、推理成本、安全等在内的更多问题。
我们结合过去两年 BISHENG 在企业内大模型应用落地的经验,尝试提出一套经过改良、更加适合企业应用落地的 DeepResearch 框架。更加注重对企业内部知识、文档、数据的解析与应用,更加注重人在过程中的互动与可控,同时考虑管理者视角对使用记录数据的自动分析、观测与持续优化。
演讲提纲
- 企业内大模型应用落地难,DeepResearch 能否破局?
- DeepResearch 技术介绍:成为链接技术与业务的关键
- 从 Deepsearch 到 DeepResearch
- 多步研究能力和规划能力
- 本地文档搜索与高阶文档分析
- DeepResearch 在企业内的应用场景探讨
- DeepResearch 在企业内落地的难点与挑战:幻觉、安全、推理成本、交互友好性...
- 我们的解法与思考
技术实践痛点
- 放弃看起来更酷炫的应用场景,优先解决更真实的企业业务诉求
- 仍然无法从根本上解决模型幻觉,只能通过更强的控制降低概率
- 效果与落地成本(算力、效果持续提升)两者之间必将有所取舍
演讲前沿亮点
- DeepResearch 如何重构上一代 RAG 技术
- 面向 DeepResearch 类通用 Agent,企业应当如何完成数据准备
- 一线企业落地经验
听众收益
- 提供一种企业落地通用智能体的框架设计参考
- 共享一些企业私有化落地过程中的真实难题与解决思路
关注主办方(InfoQ)
联系我们
交通指南
北京国际会议中心
Beijing International Convention Center
地址:北京市朝阳区北辰东路8号

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手