范斌,Alluxio 创始成员和 VP of Technology。加入 Alluxio 前, 范斌在 Google 从事下一代大规模分布式存储系统的研究与开发。范斌博士毕业于卡内基梅隆大学计算机系,博士期间在分布式系统算法和系统实现等方向发表多篇包括 SIGCOMM、 SOSP、NSDI 等顶级国际会议论文以及多篇专利。
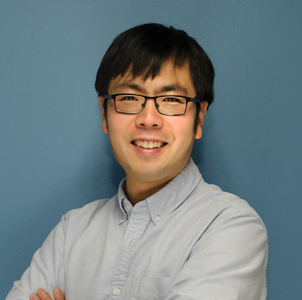
专题演讲嘉宾:范斌
AlluxioVP of Technology
by 范斌
Alluxio
VP of Technology在 AWS S3 等云对象存储中将数据存储为 Parquet 文件,不仅在大规模数据湖中非常流行,而且还可作为用于训练和推理的轻量级特征存储,或作为用于检索增强生成(RAG)的文档存储。然而,直接从 S3 查询 PB 到 EB 级规模的数据湖所面对的共同挑战是速度很慢,延迟时间通常从数百毫秒到数秒不等。
此次演讲将介绍如何利用 Alluxio 作为超大规模数据湖上的高性能缓存和加速层,对 Parquet 文件进行查询。在不使用专用硬件,不更改数据格式或对象寻址方案,不从数据湖迁移数据的情况下,Alluxio 如何实现亚毫秒级的首字节时间(TTFB)性能,以及Alluxio 的吞吐量与集群规模的线性扩展。
演讲提纲
- 数据驱动型组织直接在云对象存储上存储和提供 Parquet 文件的普遍方式,以及给AI应用所带来的挑战;
- 应对挑战的常见解决办法有哪些;
- 实现Parquet 查询 1000 倍性能提升,Alluxio 系统架构及优化设计(单节点优化,可扩展的分布式层,计算卸载等);
- 低延迟存储方案的成本对比;
- 未来工作展望。
听众收益
- 了解Alluxio的架构和工作原理,并学习核心优化技术
- 了解数据湖查询性能优化实践,掌握查询优化的方法并了解实际案例
关注主办方(InfoQ)


联系我们
交通指南
北京国际会议中心
Beijing International Convention Center
地址:北京市朝阳区北辰东路8号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手