随着数据量的爆炸性增长,如何有效管理和治理数据。如何更自动化的实现数据清洗、数据... 展开 >
结合AI模型的数据生命周期管理|ArchSummit
会议室:九华厅出品人:金晓军
- Topic 1
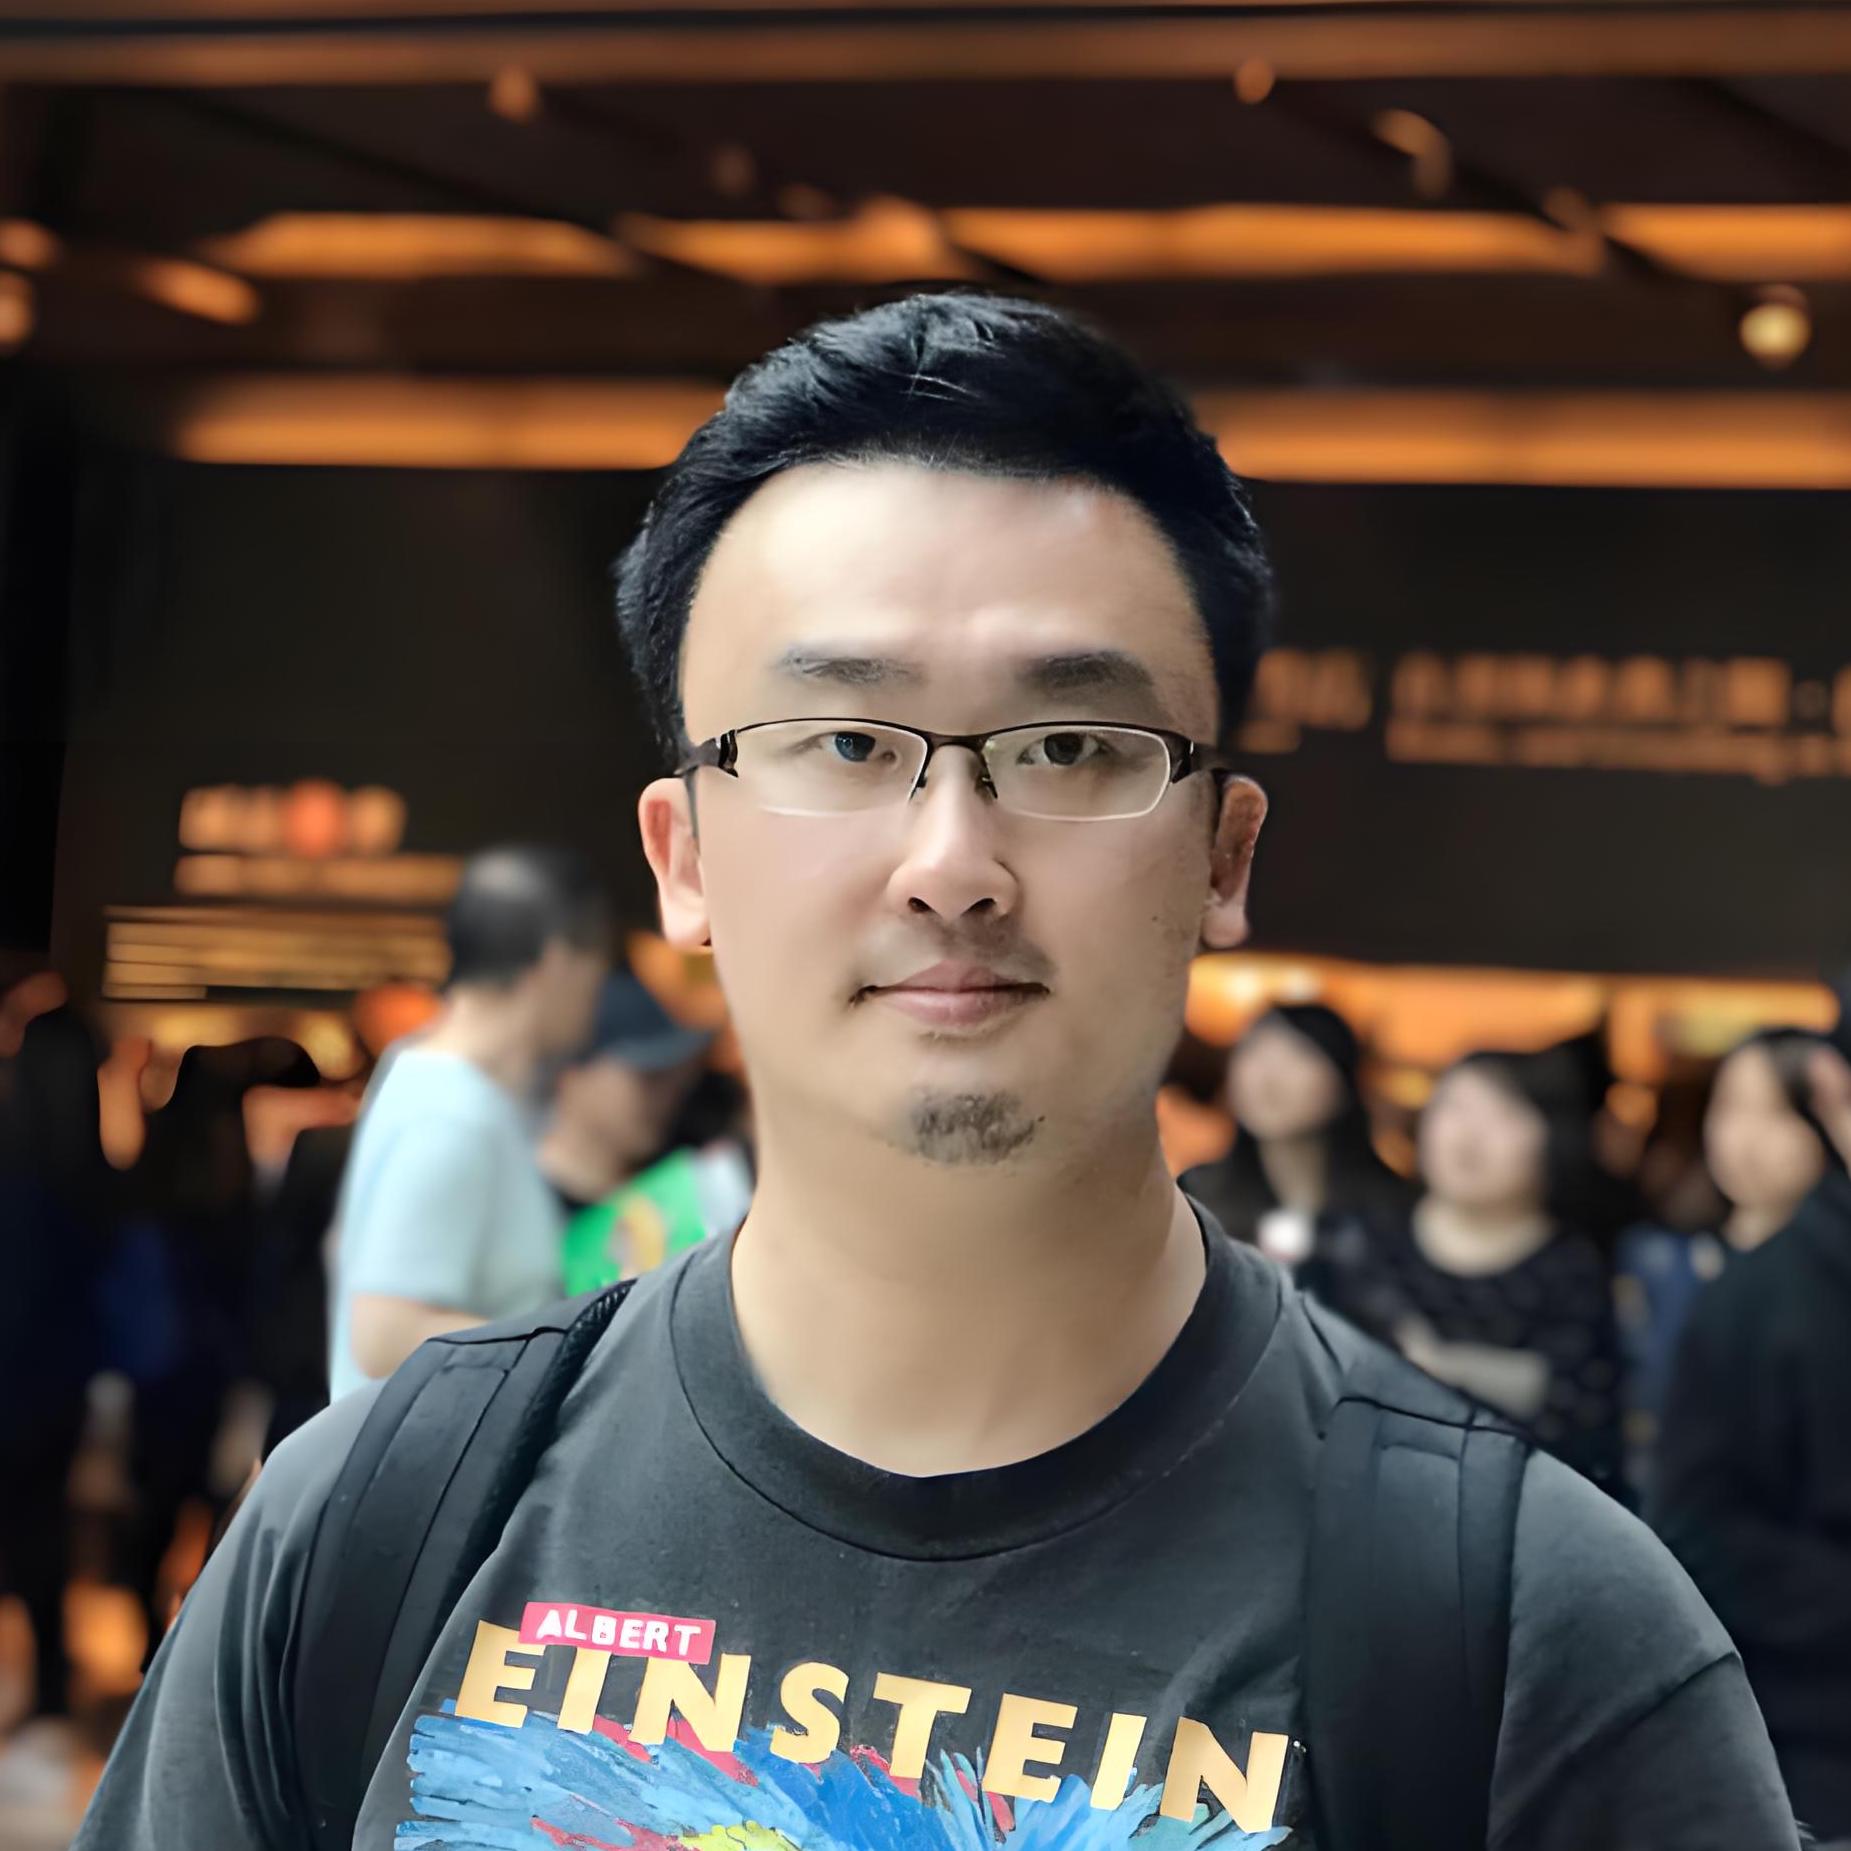
邵轶琛
ProtonBase 首席科学家 - Topic 2
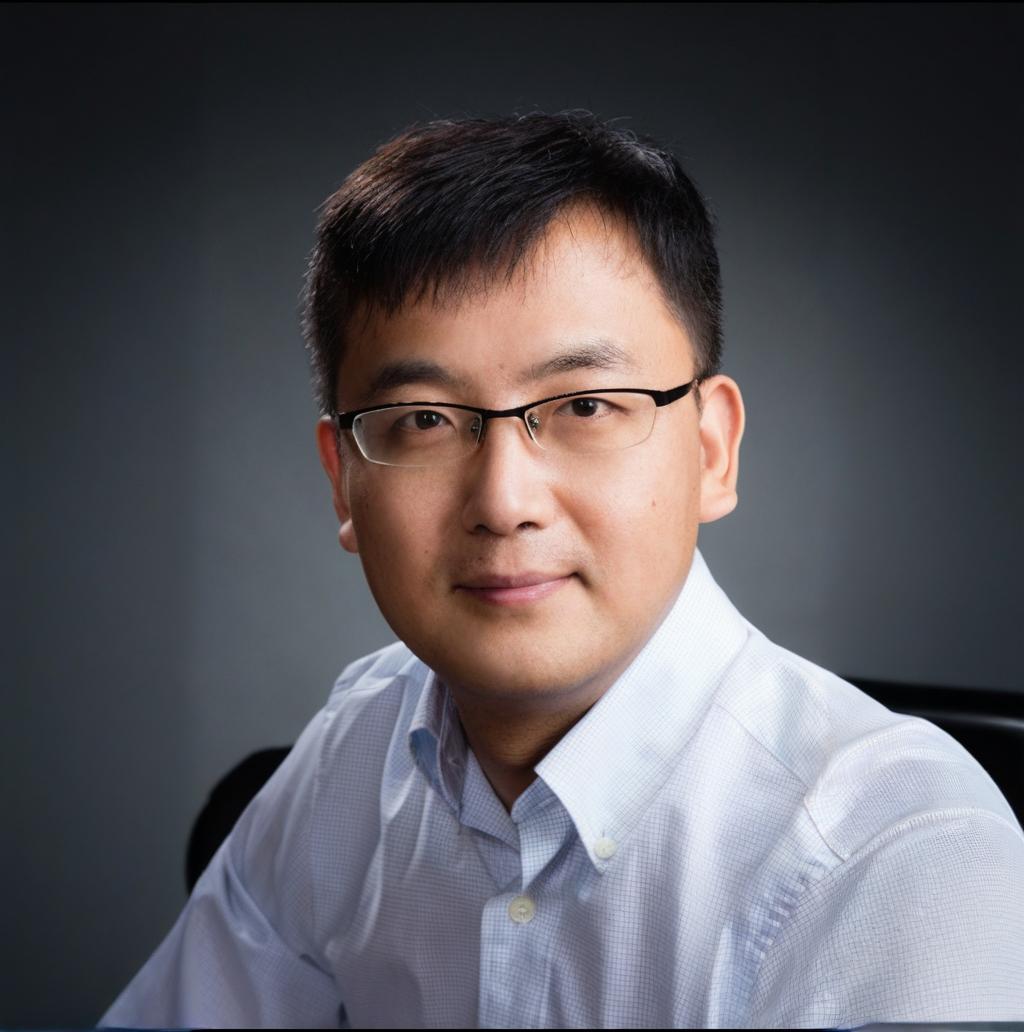
史少锋
Datastrato VP of engineering - Topic 3
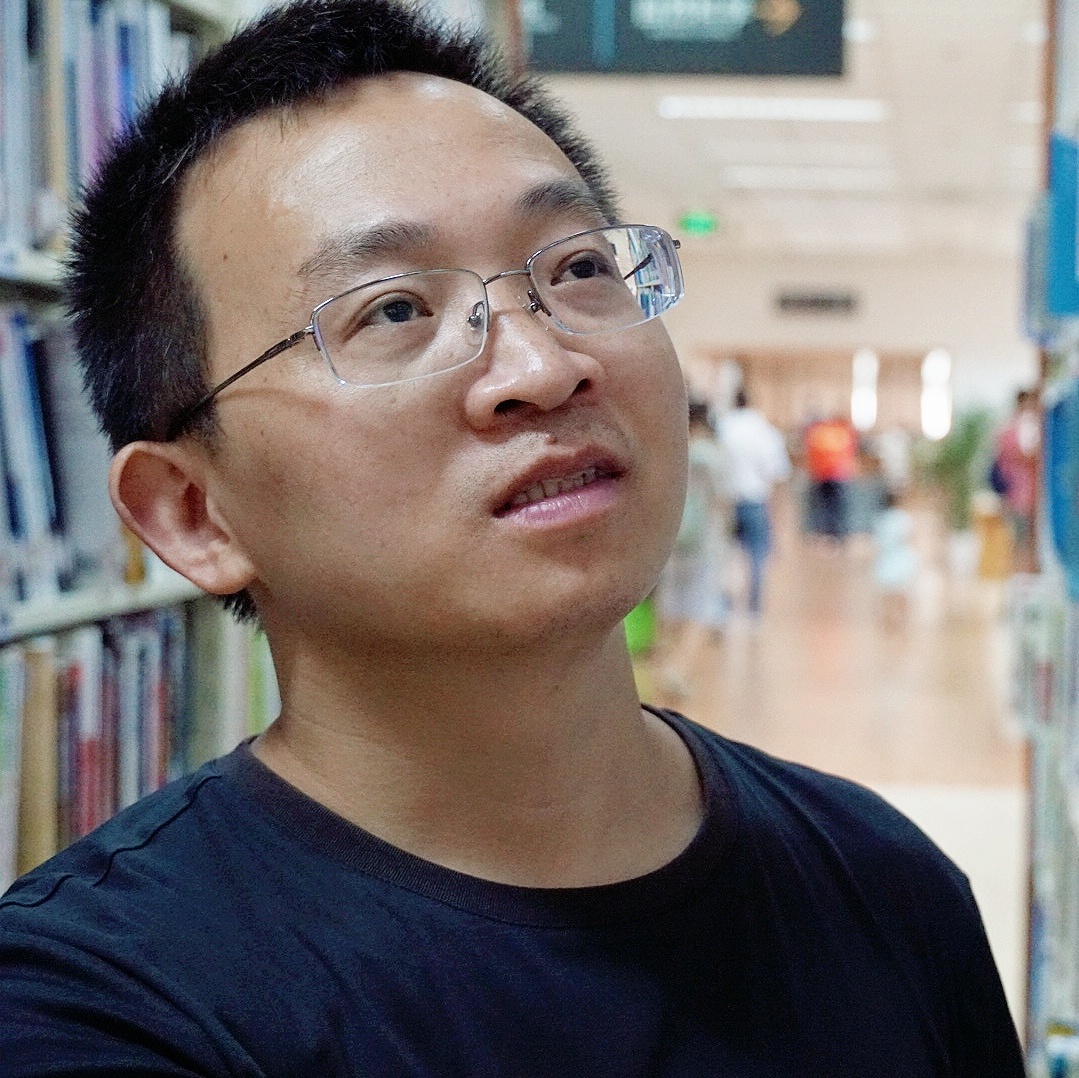
李海军
阿里国际 高级数据技术专家 - Topic 4
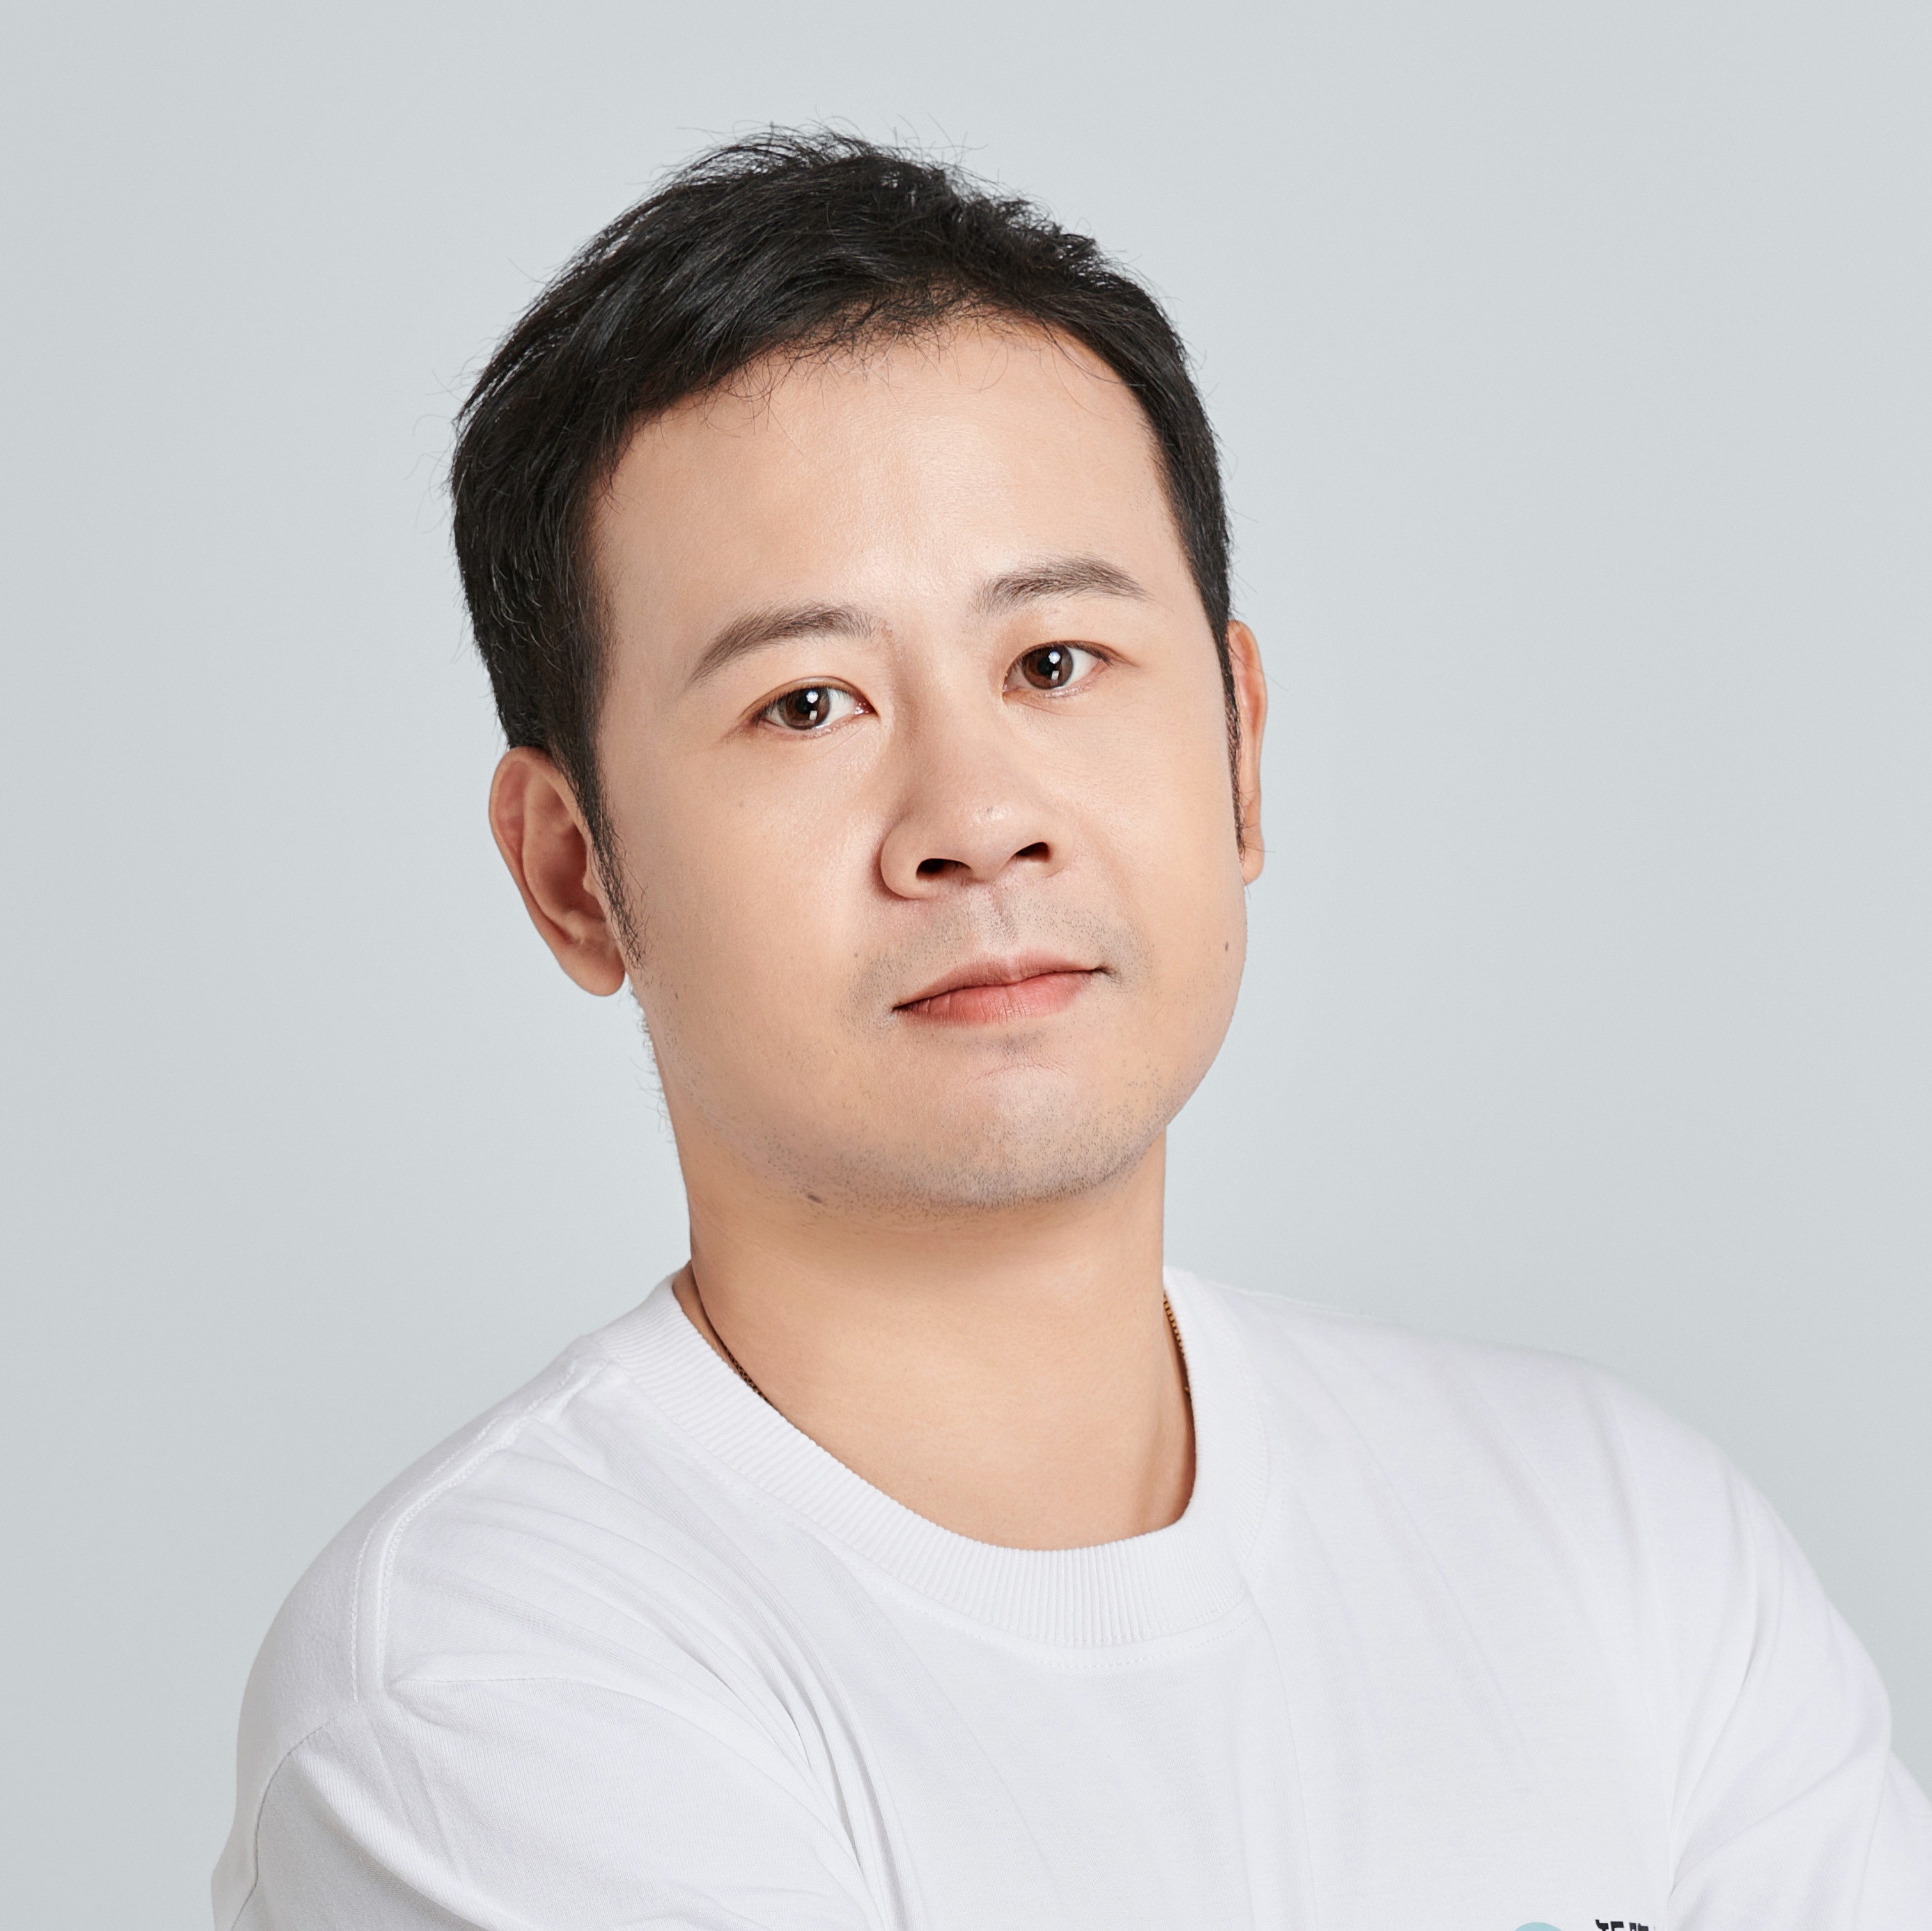
赵晨阳
矩阵起源 研发副总裁 - Topic 5
专题出品人:金晓军
ProtonBase 技术 VP
现任 ProtonBase 技术 VP,曾任阿里巴巴资深技术专家、网易数据科学中心大数据平台技术负责人。是阿里云交互式分析产品 Hologres 核心开发,担任 Hologres 产品的研发以及商业化相关工作。还曾设计开发阿里云流计算产品 StreamCompute V1.0/Galaxy,支持多届阿里巴巴双 11 实时大屏业务及集团大部分流计算业务。担任网易数据科学中心大数据平台技术负责人期间,负责网易大数据平台建设,自研系统研发与开源组件功能扩展与集成、大数据产品化输出。
地点:九华厅
专题:结合AI模型的数据生命周期管理|ArchSummit
随着数据量的爆炸性增长,如何有效管理和治理数据。如何更自动化的实现数据清洗、数据标准化,甚至结合AI模型训练和推理进行数据生命周期管理等等。本专题关注数据管理与治理的应用,以及与AI技术结合的实践分享。
by 邵轶琛
ProtonBase
首席科学家随着 AI 技术的快速发展,数据架构也在不断演化,以适应实时数据处理的需求。特别是在生成式 AI 和大模型的推动下,传统的离线特征库面临越来越大的挑战,实时特征工程和在线特征库逐渐成为支撑现代 AI 系统的核心技术之一。本次演讲将重点讨论一种新的 AI 数据处理架构——分布式 Data Warebase(Data Warehouse + Database)。我们将探讨这种架构如何在实时数据处理和大规模并行计算的支持下,构建一个高效的 AI 湖仓环境,进而支持实时特征的提取和计算,从而提升 AI 应用场景中的数据流动性和响应速度。
演讲提纲:
- 从湖仓一体到实时 AI 湖仓
- 从湖仓一体到 AI 湖仓的演进
- 机器学习与传统 AI:离线特征库的角色
- 生成式 AI 和大模型的崛起对特征工程带来的冲击
- AI 时代的湖仓架构需求
- AI 数据架构的基础:在线特征库的关键作用
- 实时特征工程的要求与在线特征库的技术挑战
- 实时 AI 湖仓的架构特点
- AI 数据底座:Data Warebase
- 适应 AI 需求的底层数据平台是什么样的?
- Data Warebase 的定位与架构特点、技术解析
- 实际应用场景与案例
- 总结与未来展望
听众收益:
- 深入理解 AI 数据架构的演进:从湖仓一体到实时 AI 湖仓的演变逻辑与关键驱动力
- 掌握实时特征工程的关键技术:深入了解在线特征库在实时 AI 架构中的作用与技术要求
by 史少锋
Datastrato
VP of engineering在 AI 时代,企业为构建高质量 AI 应用,需要采集和挖掘更多数据,其中包括结构化数据(数据库、数据仓库)、非结构化数据(数据湖、文档库)、历史数据、实时数据等;数据的完整性、准确度对构建 AI 的应用的起到了关键作用。为 AI 用户提供一个统一的数据管理平台,供他们可以更好地发现和使用多源异构数据,包括数据发现、数据语义、数据血缘、数据权限等,并结合企业治理需求,管理好数据生命周期,避免资源浪费和数据外泄等,成为每个企业的现实挑战。
本次分享会为大家介绍企业在 AI 时代所面临的最直接的数据挑战,包括难以高效地管理、获取全域数据,缺乏统一地进行数据治理和权限控制,传统的数据湖体系和 GenAI 框架之间的鸿沟等等。为了应对这些挑战,我们研发了统一元数据湖项目,并做了很多前沿创新,包括:统一的结构化和非结构化数据模型来管理异构数据,统一权限模型来简化多源数据的安全管理,基于 Fileset 概念简化非结构化数据的访问和自动化它们的生命周期管理,在主流框架如 LlamaIndex 的基础上构建下一代企业级 Data Agent 来提升RAG方案等。
演讲提纲:
- 生成式 AI 时代对数据的需求介绍及 Gap 分析
- 现有技术所面临的挑战
- 如何解决 AI时代的统一元数据管理
- 如何抽象与实现统一的数据模型,来涵盖结构化和非结构化数据
- 如何实现统一的异构、跨域、跨云的数据视图
- 如何构建统一的权限模型来统一管理云上和云下数据
- 如何基于 Fileset 实现数据生命周期管理
- 如何构建一个高效且通用的 Data Agent,来支持基于文档数据库与数据湖的混合语义检索
- 用户案例分享
- 总结与展望
听众收益:
- 了解当下 AI 应用对数据平台的切实需求和挑战,并了解业界有哪些创新方案,以及它们各自的侧重点和优劣势。
by 李海军
阿里国际
高级数据技术专家最近两年来,大语言模型和多模态大模型得到了迅猛发展,但是目前市面上通用大模型在多语言表现上仍然存在一些问题,特别是在一些特定语种上表现较为欠缺。特别是在跨境电商领域的迫切需求下,我们进行了多语言大模型的研发,以提升在全球各种语言环境下的表现。本演讲将介绍多语言大模型研发过程中面临多语言数据的挑战,对解决多语言数据的方法进行探索,并对阿里国际在多语言数据研发及对应多语言大模型研发进行介绍
演讲提纲:
- 多语言大模型数据特征
- 稀缺语言数据解决方案
- 多语言数据质量优化实践
- 数据建设与模型迭代联动机制
- 多语言大模型典型应用案例
听众收益:
- 了解多语言大模型研发下面临的多语言数据挑战
- 了解多语言数据问题的解决方法,多语言大模型的进展与表现
by 赵晨阳
矩阵起源
研发副总裁在当前大语言模型(LLM)和AI代理广泛应用的背景下,数据质量成为构建高效应用的核心。本次演讲将分享一套系统化的数据处理方法,专为企业应对其最大的技术挑战之一——如何将多源非结构化数据转换为适合LLM处理的高质量知识库。该流程集成了OCR、公式识别、多模态标注与嵌入生成等关键步骤,通过构建统一的管道,能够高效地处理来自PDF、DOCX、PPTX、XLSX、RTF等多种格式的数据文件。通过定制化训练的视觉语言模型(LLM)和专用嵌入模型,此流程显著提升了对复杂表格、图像和公式的识别与解析能力。
为了进一步优化数据处理效率,流程引入了MatrixOne的HSTAP架构,并结合GPU加速的向量化计算。该技术框架在透明的数据环境中,使得数据的标签、嵌入和结构信息能够通过自然语言查询快速检索,显著提高了数据使用的灵活性和响应速度。该方法论的核心在于通过深度处理企业现有数据,提供AI驱动的技术支持和洞察能力,以此提升决策的质量与精度。同时,这一方法显著简化了基于LLM的应用开发流程,在多个行业场景(如科技、智能制造、金融、教育、电商、法律和电信)中效果显著。
演讲提纲:
- 引言与背景
- 多模态检索的需求及应用场景
- 企业数据处理的挑战与痛点
- 多模态模型的混合检索架构
- 多模态模型的架构与核心技术
- 混合检索的实现策略:融合传统索引与向量化模型的结合
- 多源数据的融合与标准化处理的挑战
- GPU加速的数据处理与模型优化
- GPU在数据向量化与处理加速中的应用
- 构建快速反馈与模型微调机制的难点
- LLM辅助的检索结果筛选与优化
- LLM在检索结果筛选与重排序中的应用
- 结合Reranker和LLM提高检索结果的相关性和用户体验
- 引导式数据标注与自动化数据洞察
- 引导式标注Agent的自动化实现
- Agent辅助下的数据洞察和提升搜索效率的方法
- 总结与展望
听众收益:
- 了解如何充分挖掘和利用非结构化数据中的深度信息,进而提升数据驱动决策的精准性
- 理解如何通过高效的数据处理流程加速基于LLM的应用开发,从而缩短企业AI项目的上线时间
- 了解如何简化复杂的数据清洗与准备流程,帮助团队集中精力于更高价值的任务上,提升整体效率
研讨话题:
-
大模型时代,如何平衡数据的广泛性与精细化处理?具体实践中有哪些有效的解决方案?
-
如何应对实时性要求高的数据处理与推理场景,确保数据的时效性和精度?
-
大模型时代,需要什么样的ETL工具?
-
大模型如何助力传统数据 ETL Pipeline?
-
将大模型应用在数据治理领域,如何最小化AI幻觉问题产生的影响?如何评估 ROI 和风险?
关注主办方(InfoQ)
联系我们
交通指南
北京丰大国际大酒店
Beijing Fengda International Hotel
地址:北京市大兴区荣华中路20号
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手