深入讨论模型的基础设施构建,涵盖硬件配置、数据管理、网络架构、软件工具以及成本效... 展开 >
大模型基础设施构建
会议室:会议室 7+8出品人:张科
- Topic 1
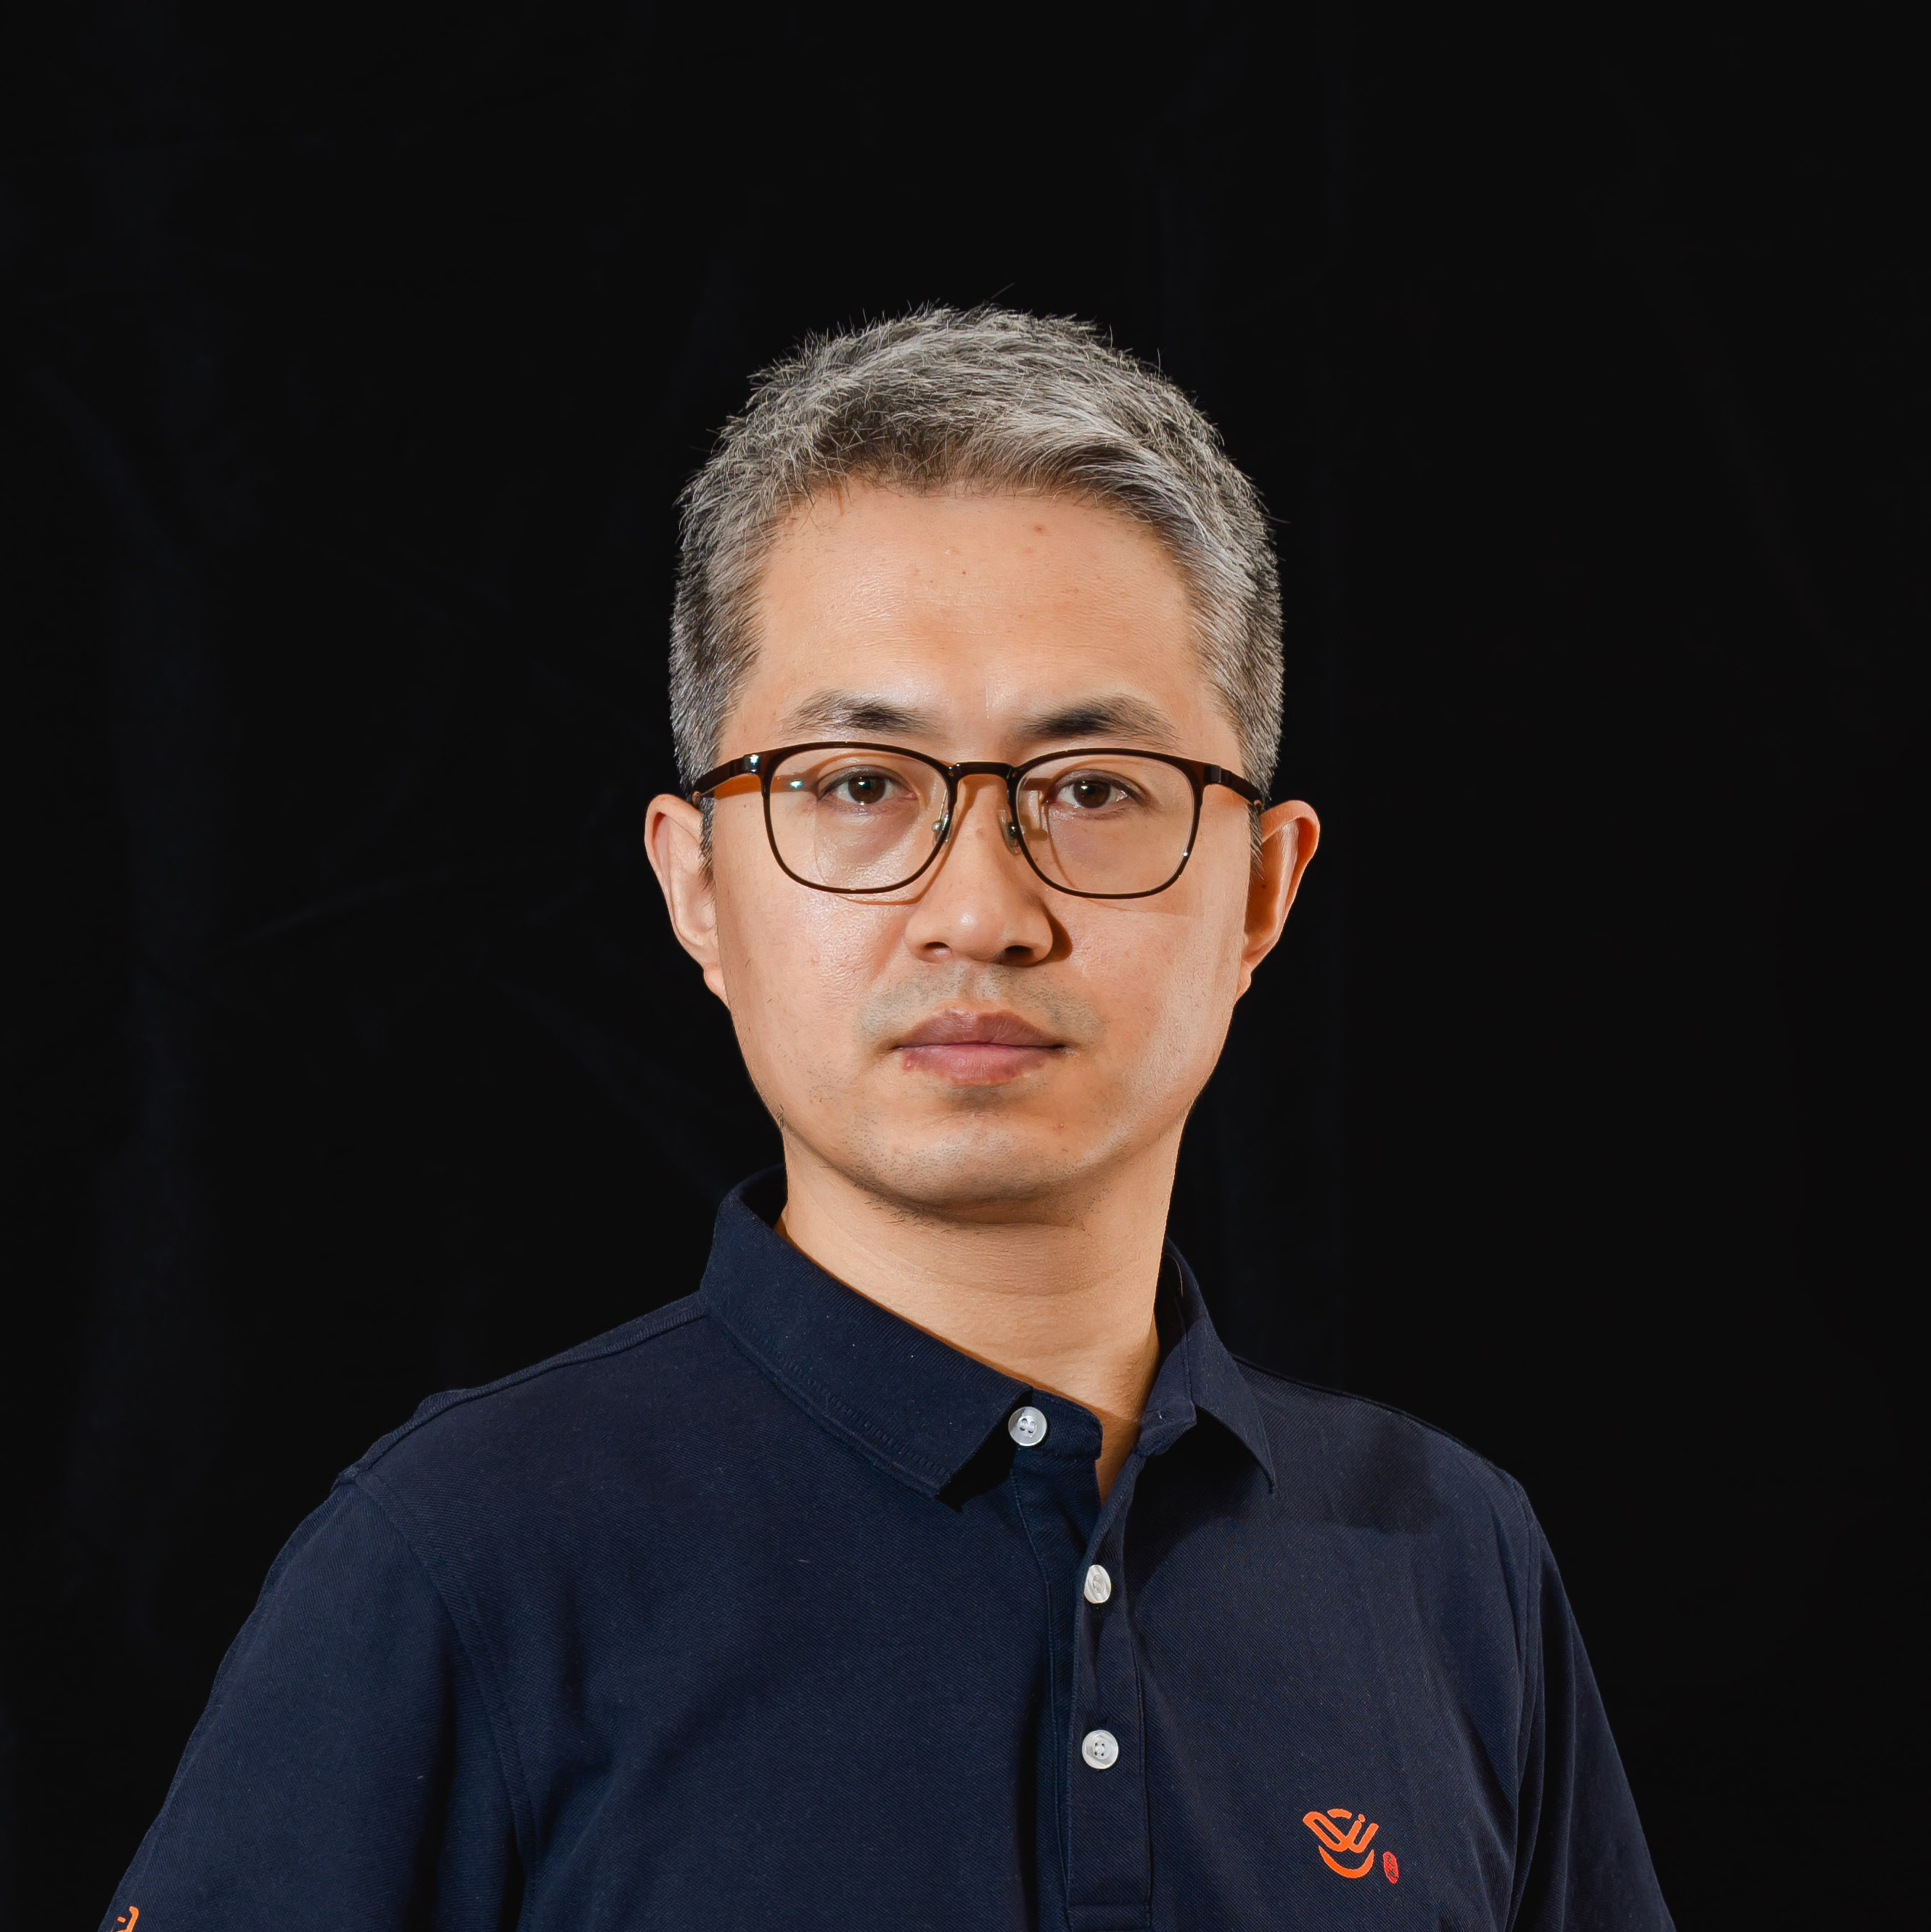
席永青
阿里巴巴 资深网络架构师 - Topic 2
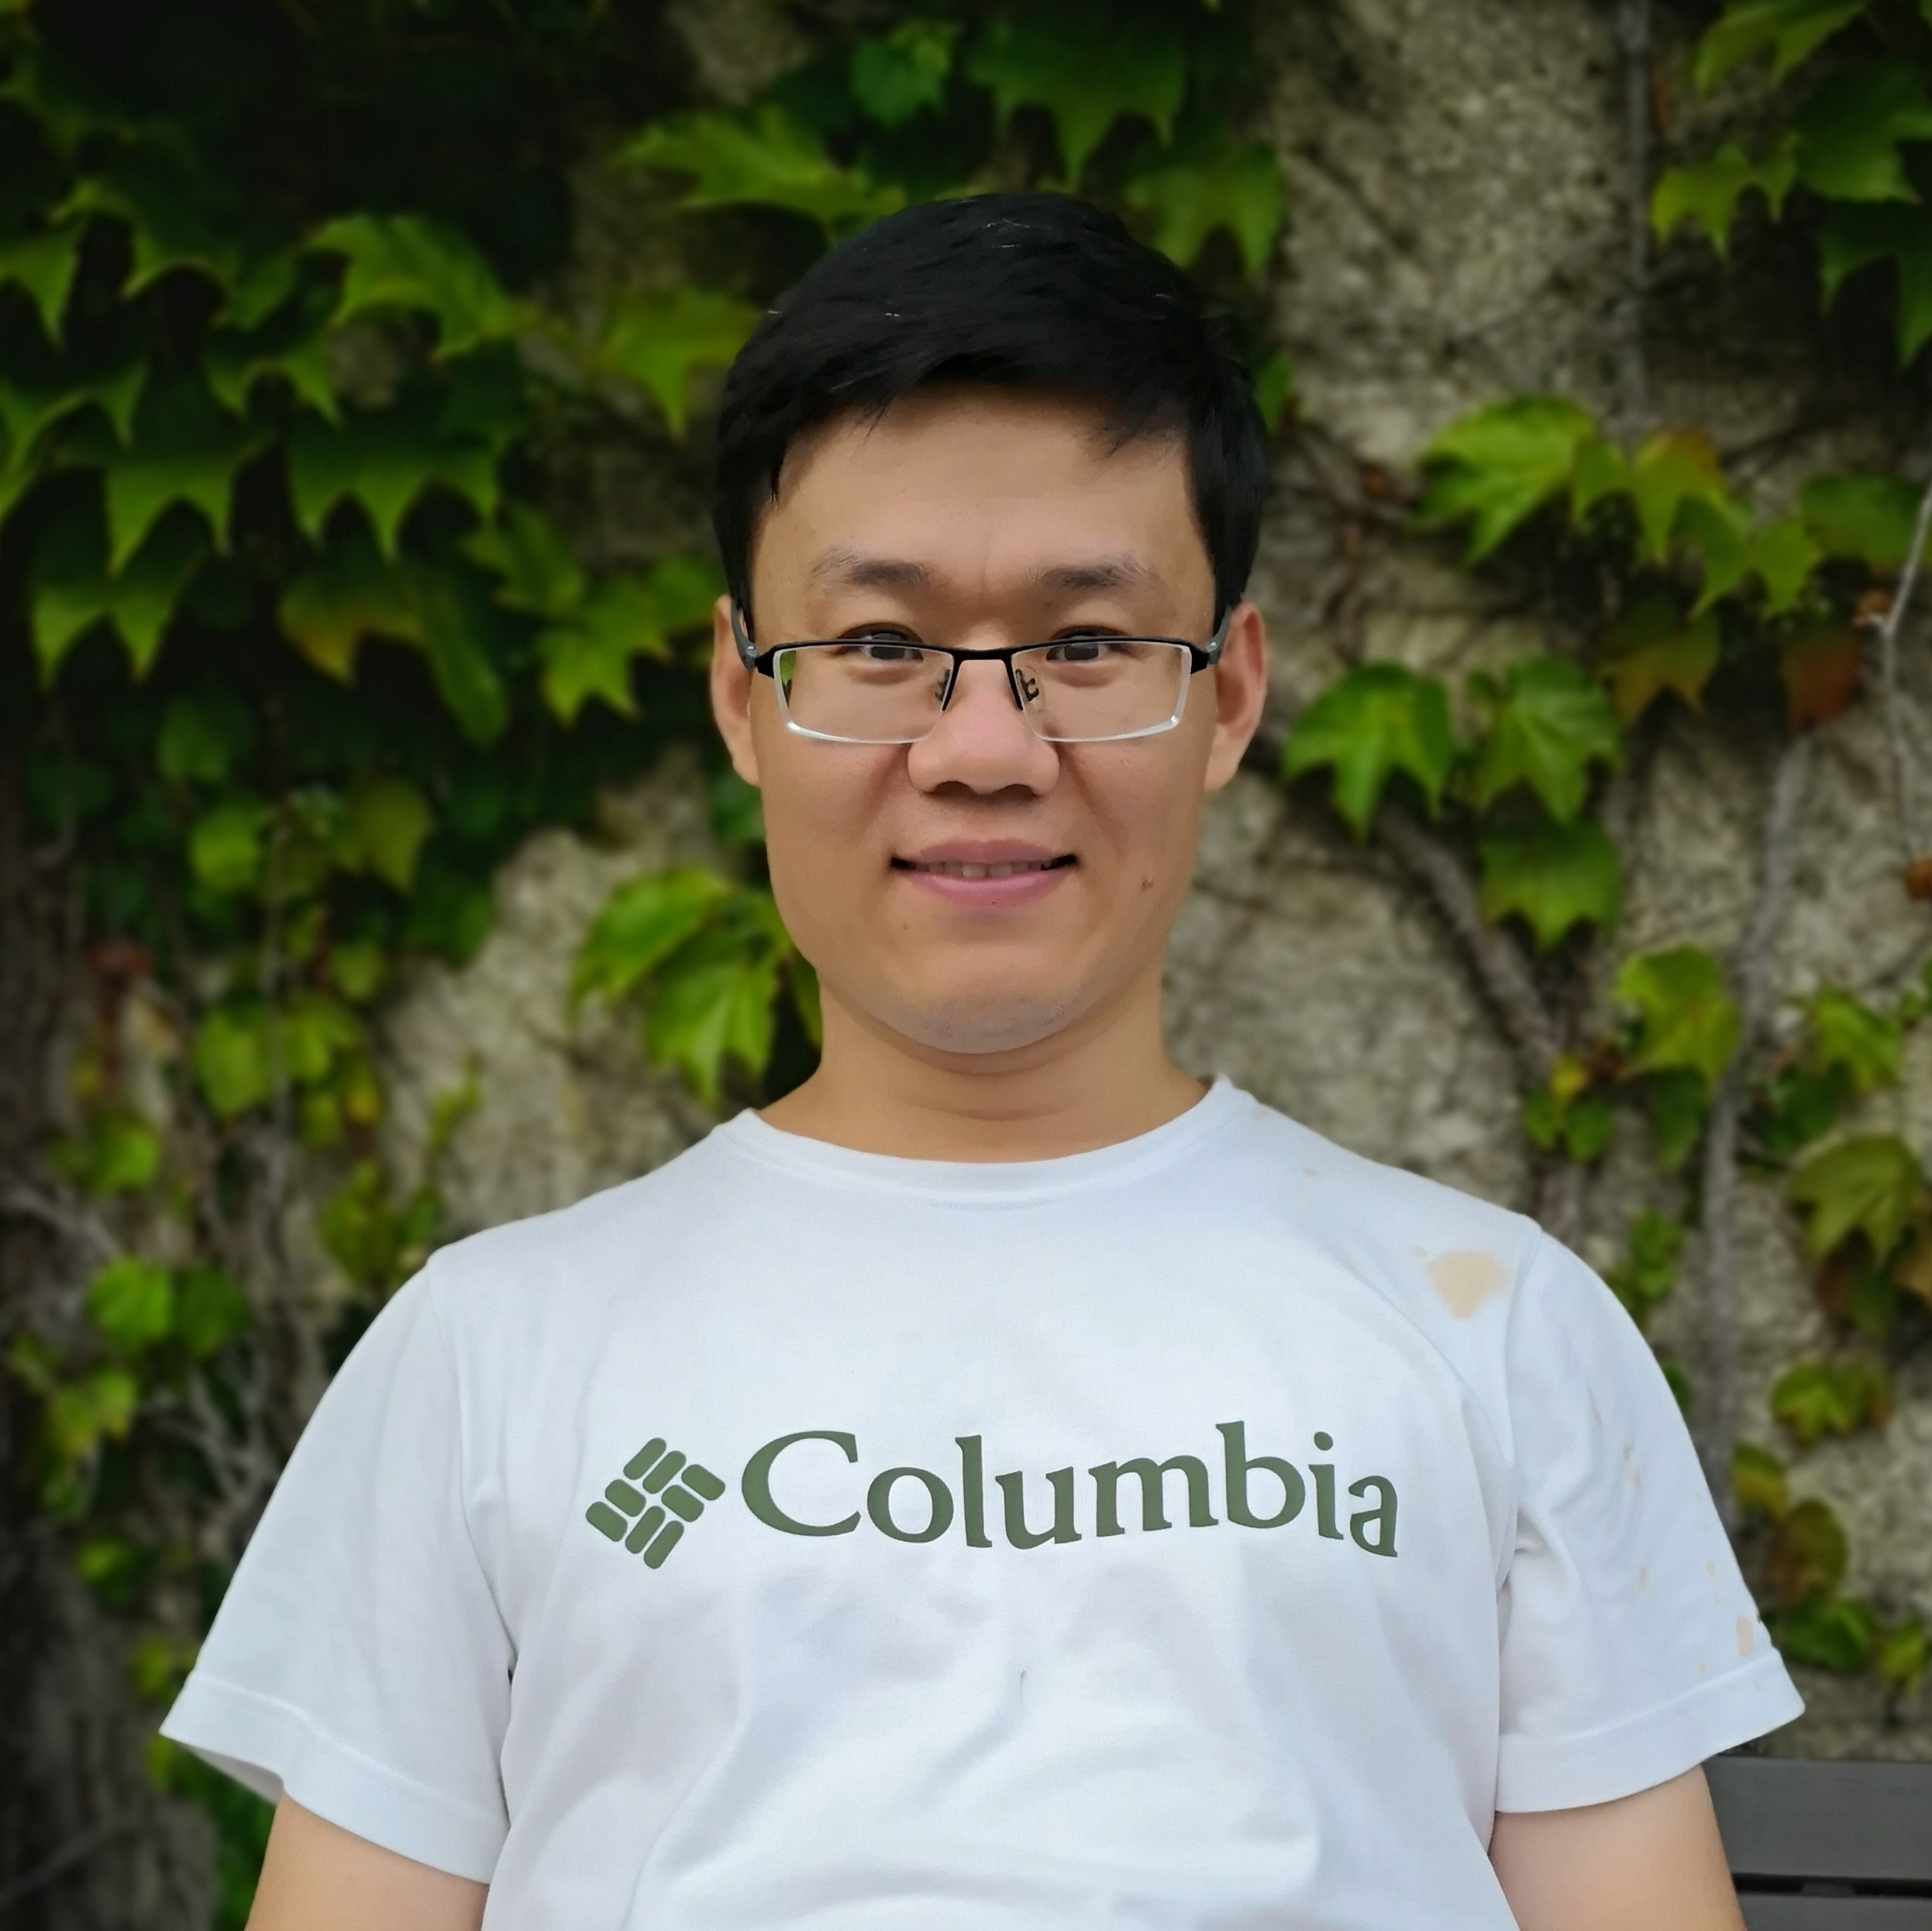
赵军平
蚂蚁集团 基础智能-AI Infra 异构计算负责人 - Topic 3
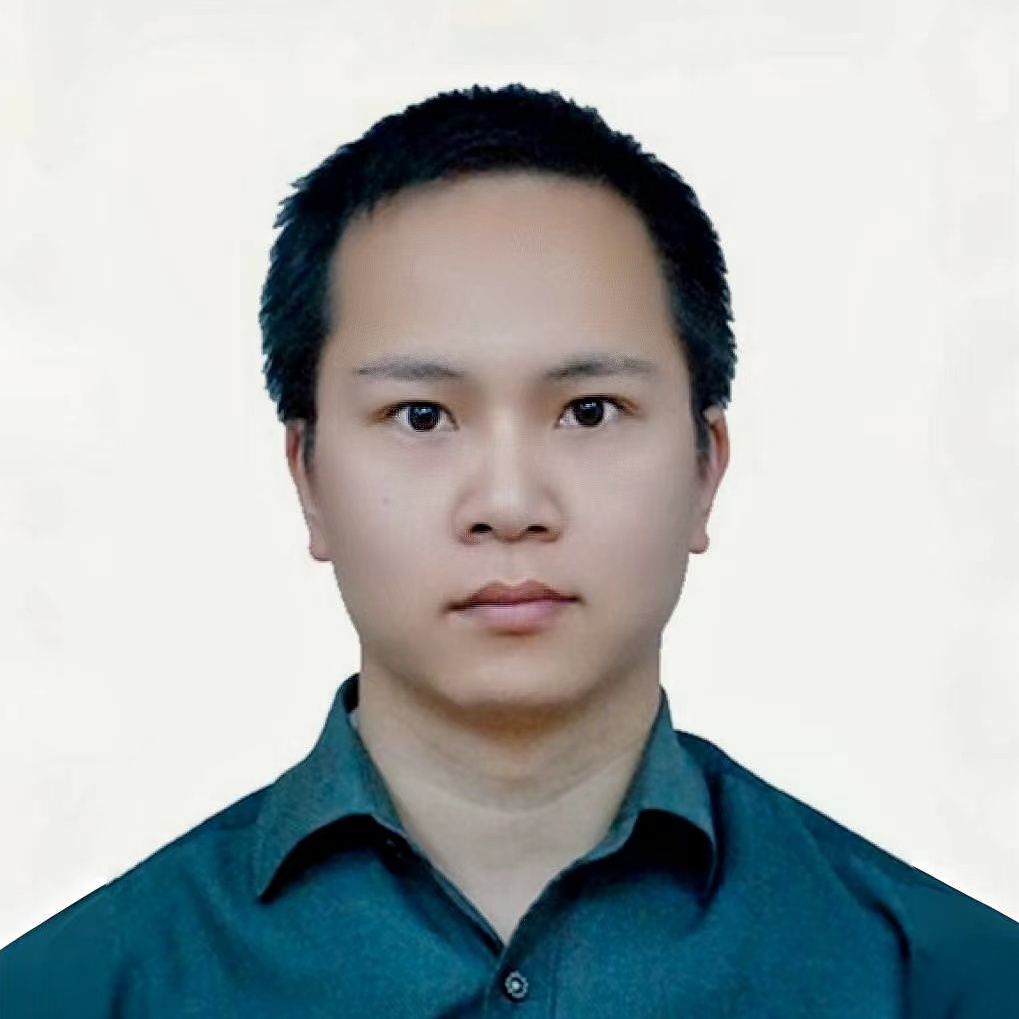
王建辉
华为 昇腾计算首席架构师 - Topic 4
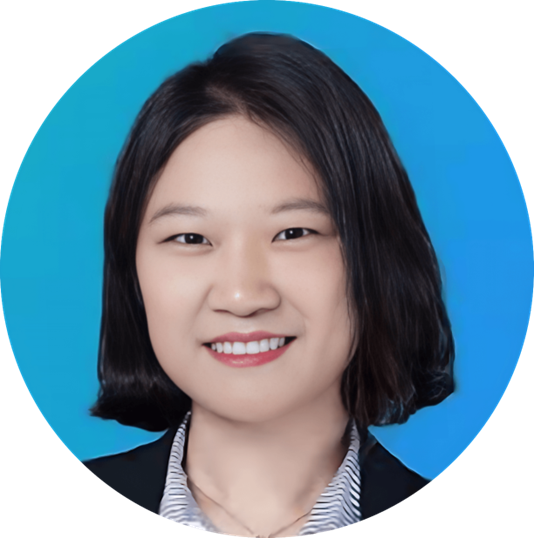
崔慧敏
中科加禾 创始人 & CEO - Topic 5
星龙
MiniMax 基础设施负责人
专题出品人:张科
蚂蚁集团 AI Infra 负责人
2009 年中国科学院毕业加入微软,主要工作有必应搜索引擎排序系统重构和广告主平台研发,开源深度学习模型标准 ONNX 以及推理引擎 ONNXRuntime 的主要作者之一。2020 年加入蚂蚁,负责蚂蚁 AI 基础设施建设。
地点:会议室 7+8
专题:大模型基础设施构建
深入讨论模型的基础设施构建,涵盖硬件配置、数据管理、网络架构、软件工具以及成本效益优化。
by 席永青
阿里巴巴
资深网络架构师AI 训练场景的算力 Scaling 核心是网络,依赖于大规模、高性能的数据中心网络集群来实现算力的规模扩展,为此,阿里云设计了 HPN7.0 架构系统,基于 Ethernet 来构建超大规模、极致性能的网络互联,本演讲分享 AI 网络系统架构的设计思考和最佳实践。
演讲提纲:
- AI计算对网络的核心诉求
- 网络集群设计的关键要素
- 阿里云 HPN 7.0 架构
- 高性能数据中心网络系统未来展望
听众收益:
- 了解 AI Infra中网络系统架构设计的重要性
- 了解网络集群设计和高性能系统能力的关键要求是什么,为高效训练系统带来哪些方面的价值
by 赵军平
蚂蚁集团
基础智能-AI Infra 异构计算负责人大模型训练和部署需要大量的显存。业界提出了很多方案,如 offloading、PP 并行、量化等,但通常需要修改模型代码或权衡精度损失。我们观察到,框架层如 PyTorch 由于缓存分配器中频繁的 split-merge 操作,带来严重的管理开销即碎片,尤其分布式训练或叠加使用 DeepSpeed、FSDP 时问题更加突出。
我们分享介绍 GLake(ASPLOS24):一种高效、全局的显存优化方案,可无缝接入 PyTorch 框架并显著减少显存碎片。在内部,GLake 基于虚拟 - 物理指针和定制化的策略,对显存进行动态重映射;并支持跨进程、跨卡、跨框架的全局显存池化;可用于大模型训练或推理(与 vLLM PagedAttention 不同)。
GLake 实测训练可节省 34% 显存,训练吞吐提高最高 4 倍,与 DeepSpeed、LoRA 等正交;并优于 PagedAttention。开源地址:https://github.com/intelligent-machine-learning/glake
演讲提纲:
- 大模型的显存与传输挑战分析
- 现有方案简介
- GLake 总体方案
- GLake 在大模型训练时的针对性设计和效果对比
- 推理时的显存挑战与初步优化
- 开源与未来展望
听众收益:
- 如何系统性分析、优化显存与传输问题:包括硬件与框架能力 / 不足,显存完整生命周期,全局视角的管理与优化包括多卡、多进程、多任务等
- 不同场景下多种优化手段的优劣,如何合理定位和取舍
- 探讨未来可能的演进和有趣的软 - 硬结合
by 王建辉
华为
昇腾计算首席架构师目前以大模型为代表的 AI 技术高速发展,目前 Scaling Law 依然生效,模型参数持续增大,序列不断增长,响应速度越来越快,但大模型商业闭环依赖推理的规模落地,如何在不断提升用户体验的基础上不断降低推理成本,以满足大模型规模落地的诉求,成为大模型推理技术研究的核心关键。为了满足大模型推理规模落地对客户体验和成本的诉求,昇腾推出高性能大模型推理软硬件解决方案,满足客户多样性开发诉求,助力大模型规模落地。
演讲提纲:
- 大模型发展趋势分析
- 昇腾大模型推理软硬件方案
- 昇腾大模型推理关键特性
- 应用案例与关键进展
听众收益:
- 了解昇腾在大模型推理方向的技术探索
- 了解昇腾大模型推理关键特性
by 崔慧敏
中科加禾
创始人 & CEO目前以通用大模型为代表的AI技术高速发展,带来了对高性能智算算力需求的爆发式增长;而各厂商围绕自身硬件特性构建相对独立且排他的工具链系统,适配集成各类 AI 框架形成分支版本,构成“中间件/框架+工具链+硬件”紧密协同的长链条式智算生态,并且厂商间互不兼容,致使上层智算应用与特定系统的锁定,难以在多个竖井生态系统间迁移部署,无法形成系统的整体运用效能。
为了实现大模型基础设施对多种加速卡的兼容,以统一的编程模型和范式为基础,以跨架构编译优化技术为依托,首先通过多层次统一编译器IR为上层应用提供“性能+编程”的归一化抽象,其次通过归一化的代码生成将上层应用翻译到多层次统一编译器IR,并通过芯片虚拟机支持跨多种国产芯片的执行,最后借助编译技术针对大模型应用的特性进行多层次全局优化,确保跨硬件执行的性能。
演讲提纲:
- 大模型算力基础设施的现状
- 构建碎片化智能芯片的统一编译基础
- 跨硬件平台的优化
- 应用方向与进展
听众收益:
- 了解针对大模型应用的跨硬件基础设施研究进展和应用方向
by 星龙
MiniMax
基础设施负责人当前预训练模型的规模和模型复杂性不断增加,这给基础设施带来了巨大的压力。为了应对这些挑战,构建更大规模的高性能训练集群, 企业往往需要进行全链路的优化,包括算法、硬件架构和系统设计的创新,以提高效率和性能。同时, 高性能算力面对较大的供给压力, 通过混合云的方式来缓解算力不足, 完成成本与灵活性的双收益。
演讲提纲
- 硬件基础设施的现状与展望
- 预训练场景下的挑战与全链路优化
- 混合云场景下的算力挑战
听众收益
- 了解大模型训练/推理的基础设施构建经验与工程实践
关注主办方(InfoQ)


联系我们
交通指南
北京乐多港万豪酒店
Beijing Marriott Hotel Changping
地址:北京市昌平区南口路29号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手