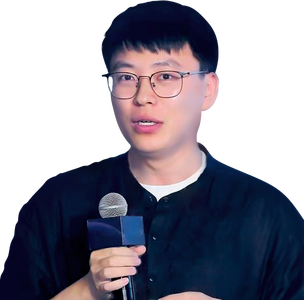
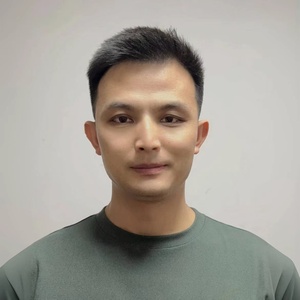
清华大学计算机系博士,研究方向为人工智能及自然语言处理,在人工智能领域顶级国际会议及期刊发表论文三十余篇,获得清华大学优秀博士毕业生、北京市优秀博士毕业生等荣誉称号,入选“全国博士后创新人才支持计划”。博士期间研究成果获得钱伟长中文信息处理科学技术奖一等奖,Google Scholar 累计引用 2900 余次。
讲师介绍
议题介绍
地点:万豪宴会厅 3
所属专题:大模型+行业创新应用
演讲:法律大模型在具体业务场景中的应用实践
法律作为典型的文本输入、文本输出的场景,与语言大模型高度匹配。在这一大模型赋能垂直行业的浪潮中,OpenAI、Anthropic 等通用大型模型龙头厂商纷纷进军法律赛道,全球领先的法律数据库巨头汤森路透、lexisNexis 等也投入数亿美元用于法律 AI 的研发与布局。然而,一个好的法律大模型需要什么样的能力,如何打造一个真正“好”的法律大模型,却是一个备受关注的问题。幂律凭借在法律行业多年深厚的专业积累,为满足客户在智能合同及法律服务场景多样化的需求,联合智谱 AI 共同打造千亿参数法律垂直大模型 PowerLawGLM,并深度应用于智能合同等业务场景。
演讲提纲:
- 法律大模型的行业特点
- 如何打造法律大模型
- 智能合同业务场景的痛点及法律大模型应用实践
听众收益:
- 了解法律行业的场景痛点
- 了解法律行业大模型训练实践
- 了解法律场景大模型实际应用问题
关注主办方(InfoQ)


联系我们
交通指南
北京乐多港万豪酒店
Beijing Marriott Hotel Changping
地址:北京市昌平区南口路29号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手