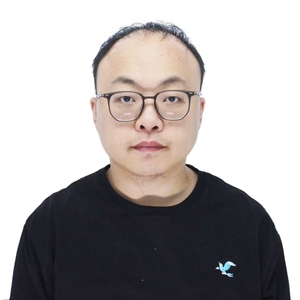
曹智勇,TraceLite AI 联合创始人,中科院自动化所博士生。长期关注大模型Agent、Agent Harness、Benchmark评测体系与可信AI工程化实践,重点研究如何通过组件化拆解、轨迹追踪、自动评分与错误归因,提升 Agent系统在真实任务中的可复现性、可解释性和可治理性。目前主导Harness Benchmark相关工作,围绕执行环境、工具调用、上下文记忆、任务编排、可观测性、结果验证与安全治理等方向,构建面向Agent Harness的组件级评测方法,致力于推动Agent评测从结果排名走向工程诊断与系统优化。
从成功率到失败归因:Agent Harness组件级评测实践
所属专题:Harness Engineering:模型之外的智能体工程
嘉宾 : 曹智勇 博士 | TraceLite AI联合创始人
会议室 : 大宴会厅B
讲师介绍
议题介绍
演讲:从成功率到失败归因:Agent Harness组件级评测实践
现有很多 Agent Benchmark 主要是在测模型本身的能力,或者测模型和Harness适配的程度,但难以定位并分析Harness哪个维度的设计对结果产生了影响。
我们的核心思路是Harness组件化+错误归因:将Harness从完整Agent系统中解耦出来,拆分为执行环境、工具调用、上下文记忆、任务编排、可观测性、结果验证和安全治理等组件,并进一步细化为可以单独测试的子能力。
基于这些拆解,我们设计可复现、可自动评分的任务,并配套开发轨迹追踪和归因模块,让Benchmark不只是判断最后是否完成任务,还能分析到底是哪个Harness组件在起作用、哪里成为瓶颈。
这一方法也在招聘Agent、房产视频内容生成Agent等产业化长链路场景中持续验证:一方面用组件级评测定位真实业务中的Harness能力缺口,另一方面将业务落地中暴露的问题反哺到任务设计、轨迹分析和归因规则中,形成技术研究与产业实践的闭环。
演讲提纲
- 为什么Agent Benchmark需要从成功率走向失败归因
- 介绍现有Agent Benchmark的局限:很多评测能判断任务是否完成,但很难解释失败来自模型能力、Harness设计,还是模型与Harness的适配问题。进一步说明在长程任务中,执行环境、工具调用、上下文管理、验证机制等工程组件会显著影响结果。
- 产业化长链路Agent中暴露出的Harness问题
- 结合我们实际落地的招聘Agent、房产视频内容生成Agent等落地场景,提炼长链路Agent的共性挑战:需求澄清不充分、上下文约束丢失、工具调用结果不稳定、多阶段任务容易早停、最终结果缺少可验证证据链等。这些问题并不总是模型能力不足,而往往来自Harness在工具、上下文、编排、验证和治理等环节的能力缺口。
- Agent Harness的组件化拆解方法
- 介绍我们如何将Harness从完整Agent系统中解耦出来,并拆成执行环境、工具调用、上下文记忆、任务编排、可观测性、结果验证、安全治理等维度。
- 重点说明拆解原则:组件必须可观测、可造题、可归因,且能进一步细化成单独测试的子能力。
- 企业级Harness设计:从能力封装到可治理运行时
- 结合组件拆解,进一步讨论企业级Harness应如何设计:它不只是模型调用外壳,而是Agent的运行时控制层,需要统一处理工具权限、上下文注入、任务编排、轨迹观测、结果验证和安全治理。
- 结合我们在招聘Agent和房产视频内容生成Agent中的Harness设计实践,重点分析企业落地中的几个关键取舍:自主性与可控性、通用框架与业务定制、完整可观测性与运行成本之间的平衡。
- 可归因任务如何设计:从真实问题到单组件压力测试与corner case挖掘
- 任务设计方法:从真实长链路场景中抽象出可复现的Harness子能力问题,每道任务围绕一个主要组件构造压力源,同时控制其他因素。包括任务描述、初始workspace、隐藏verifier、评分脚本、isolation说明等模块。
- 如何避免题目变成“大而全”的综合任务;
- 在测评产业级Harness时的迭代机制:通过Benchmark持续暴露真实业务中的corner case,将失败样本、边界输入、异常工具返回和长链路中断等问题沉淀为新的测试任务,再反向推动Harness在工具协议、上下文管理、任务编排和验证闭环上的优化。
- 轨迹追踪模块:让Benchmark看见过程而不只看结果
- 介绍轨迹追踪模块如何记录模型输入、工具调用、工具结果、文件修改、命令执行、最终回答和失败状态。说明为什么只有final answer不足以做归因,必须结合执行轨迹判断Agent是否走了错误路径、跳过验证、误用工具或被上下文污染。
- 错误归因模块:把失败映射回Harness组件
- 结合典型失败模式说明如何将失败归因到具体Harness维度,例如工具schema理解错误、上下文检索不充分、任务早停、验证证据不足、沙箱边界失效、安全策略绕过等。重点讲归因规则、隐藏检查项和trace证据如何结合。
- 实践踩坑:可复现、可评分、可归因之间的取舍
- 分享任务构造和评测框架开发中的关键问题:单组件隔离难、verifier设计容易过窄、真实Harness的trace格式不统一、过强规则可能降低任务真实性、过程评分与最终评分可能不一致等。
- 后续演进:从组件评测到数据-模型-应用闭环
- 展望完整题库扩充后,如何形成组件能力画像、Harness框架对比、成本与可靠性分析,并帮助团队判断应该优先优化工具层、上下文层、验证闭环还是安全治理能力。进一步讨论如何从真实业务Agent的轨迹和失败案例中沉淀高质量任务、过程监督信号和修复路径,探索面向AGI的数据合成范式。
这样的技术在实践过程中有哪些痛点?
- 组件隔离与真实复杂度之间存在天然冲突
- 如果任务设计过于纯粹,归因会更清晰,但可能脱离真实业务;如果任务过于贴近招聘Agent、房产视频内容生成Agent这类长链路场景,又很容易变成多组件耦合,难以判断到底是哪一层Harness起作用。
- 真实业务中的失败往往是多组件耦合问题
- 产业级Harness的失败很少是单点问题,可能同时来自需求澄清不充分、上下文约束丢失、工具返回异常、任务编排早停、结果验证缺失等多个环节。因此错误归因不能只看final answer,需要结合任务设计、隐藏检查项和执行轨迹共同判断。
- 自动评分的确定性和业务语义覆盖难以兼得
- 程序化verifier可复现、成本低、稳定性强,但容易只覆盖显式结果;而招聘匹配质量、内容生成质量、业务表达准确性等问题往往带有语义判断,需要引入更复杂的规则、人工评审或LLM judge,这又会带来不稳定性和评审偏差。
- Trace标准化和可观测性建设成本很高
- 不同Agent Harness暴露的轨迹粒度不同,有的能完整记录tool call、文件修改和中间状态,有的只能从日志、session文件或最终输出中恢复过程。要做稳定归因,必须先解决trace格式统一、关键事件抽取、隐私脱敏和存储成本问题。
- 持续挖掘corner case会带来Benchmark维护压力
- 在测评产业级Harness时,Benchmark会不断暴露新的边界输入、异常工具返回、长链路中断和业务规则冲突。这些case很有价值,但如果缺少分层管理、版本控制和回归机制,题库会越来越难维护,也可能导致Harness过度适配某一批测试任务。
- 更强的Harness往往意味着更高成本
- 增加验证轮次、上下文压缩、工具保护、安全审计、人工确认和失败重试机制可以提升可靠性,但也会带来token成本、执行时延、系统复杂度和用户体验成本。企业落地时必须在可靠性、效率、成本和可控性之间做取舍。
听众收益
- 获得一套可复用的Agent可靠性诊断方法
- 从pass/fail进一步定位到上下文、工具、沙箱、验证、可观测、安全治理等Harness组件,帮助团队把“Agent为什么没做好”拆解成可分析、可优化的工程问题。
- 学会如何设计可归因的Agent Benchmark
- 结合招聘、房产视频内容生成等场景,理解如何从真实长链路Agent场景中抽象评测任务,设计单瓶颈任务、隐藏verifier、isolation预注册、trace replay和失败分类机制,让Benchmark不只用于排名,也能用于诊断和迭代。
- 获得企业级Harness落地的设计参考
- 结合招聘、房产视频内容生成等场景,理解企业级Harness在工具权限、上下文工程、任务编排、验证闭环、可观测与安全审计之间的关键取舍,并判断团队应该优先补哪一层能力。
- 理解面向AGI的高质量数据合成思路
- 学习如何从真实业务Agent的失败轨迹、corner case和修复路径中提炼可验证任务、过程监督信号和能力边界标注,为后续模型训练、Agent对齐与“数据-模型-应用”闭环提供更高质量的数据来源。
本专题下其他演讲
关注主办方(InfoQ)


联系我们
交通指南
深圳湾万丽酒店
Shenzhen Bay Marriott Hotel
地址:深圳南山区粤海街道高新区社区科技南路18号


Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

微信联系我们
如您在购票过程中遇到问题,请扫码咨询票务小助手