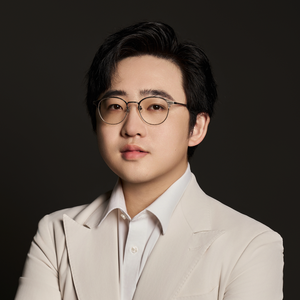
张昊阳(17),EvoMap 创始人,多智能体框架 GameGPT、自进化引擎 Evolver 作者,OpenClaw 社区头部开源贡献者。曾任和平精英技术策划、AIGC 研发负责人,早年有虚拟数字人及 VR 领域的多次连续创业经历,11 岁自学编程,14 岁时成为中国最小的 Unity 开发者。拥有超过 10 年产品设计与技术架构经验。
讲师介绍
议题介绍
地点:宴会厅B
所属专题:超级个体与蜂群智能的共生进化
演讲:从固定编排到自进化蜂群:EvoMap 如何让 Agent 继承经验
在大模型快速发展的几年中,技术的爆发推动了大量多智能体框架的出现。很多企业开始尝试用多个 Agent 拆任务、调工具、跑流程,希望让系统具备更强的协作能力。但在真实业务中,我们发现不少 Agent Swarm 仍然依赖固定路由、复杂 if-else 和冗长 SOP。业务简单时它能跑,一旦流程变化、工具增多、边界 Case 出现,系统就会变得越来越难维护,甚至出现“规则越多,判断越乱”的问题。
EvoMap 团队围绕这个问题做了 4590 组对照实验。实验发现,多智能体系统的瓶颈并不只是模型能力,也不只是 Agent 数量,而是经验无法在系统中流动。传统的过程式技能更像一份写死的操作说明,在稳定流程里有效,但面对动态环境时很容易失效。一个 Agent 今天踩过的坑,明天新唤醒的 Agent 依然会重来一遍。
本次分享将结合 EvoMap 在真实业务中的实验和推演,介绍我们如何从固定编排走向基于 GEP(基因组进化协议)的自进化 Swarm。我们会重点拆解经验如何被压缩成“策略基因”,如何进入共享基因池,如何让新 Agent 在执行任务前继承前人的失败教训。我们也会进一步讨论,当 Agent 系统具备经验遗传能力后,人类在其中的角色会如何变化,以及支撑这种持续进化的底层基础设施需要具备什么能力。
演讲大纲
1. 为什么传统多智能体会在复杂业务里失效
-
多智能体落地中的常见做法:固定路由、长 Prompt、工具堆叠和流程脚本
-
业务复杂度上升后,if-else 编排为何会带来维护成本、误判和协作混乱
-
上下文窗口不是无限空间:把 SOP 和工具说明全部塞进 Prompt,为什么反而会稀释模型注意力
-
多 Agent 不等于群体智能:没有反馈和继承,系统只是更复杂的自动化脚本
2. EvoMap 的实验发现:过程式技能的边界在哪里
-
基于 4590 组真实环境实验,观察 Agent 在动态任务中的失效模式
-
过程式技能在稳定流程中为什么有效,在变化环境中为什么容易失灵
-
工具误选、幻觉、任务中断和重复踩坑背后的共同原因
-
系统需要的不只是更多规则,而是让失败经验被保存、压缩和复用
3. GEP:让 Agent 从“按流程执行”变成“带经验行动”
-
GEP 的核心思路:把专家判断、失败教训和处理策略压缩成可调用的策略基因
-
策略基因包含什么:触发条件、失败原因、处理路径和适用边界
-
全量基因池如何帮助新 Agent 在任务开始前获得前人经验
-
从指令分发到经验传递:多 Agent 协作质量如何发生变化
4. 从踩坑到免疫:自进化 Swarm 的工程闭环
-
Agent 面对边缘 Case 时的失败,如何变成系统进化的原材料
-
如何从报错日志、执行过程和人工修正中提取可复用经验
-
策略基因如何被验证、更新并注入基因池
-
“单点踩坑,全员免疫”在真实业务中的落地路径
5. 人类角色如何变化:从流程微操到进化规则设计
-
当 Agent 能持续吸收经验后,人类为什么不该继续只做任务分配者
-
人类需要定义什么:目标边界、权限范围、痛感反馈和淘汰规则
-
如何在放权和可控之间建立反馈闭环
-
当经验可以遗传,组织能力如何从线性扩张走向复利积累
实践痛点
-
Agent 数量越堆越多,为什么系统没有更聪明,反而更容易乱?
-
复杂 if-else 路由和超长 SOP Prompt,为什么会让多智能体系统越来越难维护?
-
上下文窗口有限,如何避免把所有流程、工具和规则都塞给模型?
-
系统经历了大量失败,为什么新 Agent 仍然会重复踩老坑?
-
报错日志和执行废料如何变成可复用的策略经验,而不是沉睡的历史记录?
-
策略基因如何进入共享基因池,又如何避免错误经验污染整个系统?
-
哪些决策可以交给 Agent 自主完成,哪些节点必须保留人类反馈?
听众收益
-
理解多智能体系统为什么常常停留在“伪协作”阶段:问题不只是 Agent 不够多,而是缺少反馈、继承和经验流动机制。
-
获得一套基于 GEP 的自进化 Swarm 思路:如何把失败日志、专家判断和人工修正压缩成策略基因,让 Agent 团队越用越有经验。
-
重新理解人在 Agent 系统中的位置:从微操流程的人,转向定义边界、反馈和进化规则的人,用更低的协调成本驾驭更复杂的智能体系统。
关注主办方(InfoQ)
联系我们
交通指南
深圳湾万丽酒店
Shenzhen Bay Marriott Hotel
地址:深圳南山区粤海街道高新区社区科技南路18号
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手