Open-Falcon、Nightingale 开源项目发起人,极客时间专栏《运维监控系统实战笔记》作者,公众号 SRETALK 主理人,目前是在可观测性领域创业。
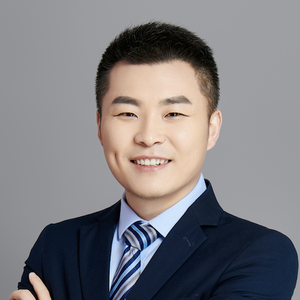
专题演讲嘉宾:秦晓辉
快猫星云联合创始人
by 秦晓辉
快猫星云
联合创始人AI SRE 进入真实运维后,难点往往不在模型能不能回答问题,而在它能否在多人协作、生产权限和长会话里可靠地完成任务。本次分享基于一个 AI SRE 平台的生产工程实践,拆解三个运行时问题:一是多人群聊中,身份如何跟着任务走、资料如何在放进执行环境前按范围加载、业务接口如何用按发起人签发的临时凭据鉴权,以及凭据如何经专用通道交付而不进入 Shell 环境;二是长会话每轮重发整段上下文时,如何保持提示词前缀稳定,并及时发现缓存失效;三是在“没有报错”的表象下,如何结合工程信号、用户中断与 LLM-as-a-Judge 审计会话,把发现落到正确位置并分流验证。最后分享团队用 AI 协作排障、共建知识与沉淀 Skill 的方法。
演讲提纲
- 代码大量由 AI 生成后,排障更难了
- 越来越多代码由 AI 写、AI 审,上线后内部逻辑没人说得清,出了故障也很难查。于是排障也开始交给 AI。本次分享怎么做一个能在生产环境用起来的 SRE Agent。
- 已经有 Codex、Cursor,为什么还要 SRE Agent
- 研发人手一个 Coding Agent,它也能接数据和工具,但它是个人助手。SRE Agent 要在团队群里和多人一起排障,要自动拿到故障上下文、7×24 值守,还要管住权限和成本。
- 让它查得准:数据和工具怎么组织
- 告警、指标、日志、变更、代码、K8s,数据来源很多。先把告警收敛成故障,各类可观测性数据使用统一语义的标签,数据可以串联,才方便 Agent 排查。
- 让它跑得稳:Harness 怎么设计
- 推理放在云端,执行放进内网。长会话压缩时,既要保住上下文,也要保住缓存命中。还要从大量会话里找出那些"没报错、但其实没帮上忙"的失败,做好评测和持续改进。
- 让团队用起来:知识、入口和权限
- 知识交给 AI 来整理,人只负责告诉它怎么整理。Agent 要以同事的身份进 IM 群,群里不同的人找它办事,权限也要按人区分。
- 全流程样例演示
- 数据接入、AI init、发现问题、AI 介入、IM 里协作、复盘沉淀,全流程演示
听众收益
- 掌握多人群聊场景下身份传递、资料范围、接口授权与凭据交付的设计思路,以及保持提示词前缀稳定、发现缓存失效的具体规则
- 了解从挑选会话、LLM-as-a-Judge 评审与复核到修复验证的会话审计方法,识别“调用成功但任务未完成”的问题并追溯到具体证据
- 获得结构化数据工具、群聊知识采集、受约束操作接入和协作排障的具体做法,让一次任务的成果沉淀为团队可复用的知识与 Skill
演讲亮点
- 来自生产代码与真实踩坑:服务重启后恢复任务丢失发起人、四个导致缓存失效的真实改动,讲清楚怎么发现、怎么修
- 可直接借鉴的具体机制:按发起人签发的临时凭据、经继承文件描述符交付且不进入 Shell 的凭据通道、前缀不变量测试、“默认推翻”的二次复核
- 讲清边界与取舍:每个机制都说明能防什么、不能防什么,例如凭据通道“防带走、不防运行期间滥用”,不夸大效果
- 工程机制与团队方法结合:既讲如何把 Agent 做可靠,也讲 SRE 团队如何在群里协作使用、共建知识、沉淀 Skill
关注主办方(InfoQ)
联系我们
交通指南
北京新云南皇冠假日酒店
Crowne Plaza Beijing Sun Palace
地址:北京市
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手