计算机科学博士,现任范式智能研发负责人,曾在新加坡科研机构及大型跨国科技企业从事科研与技术开发工作。长期专注于人工智能与计算机系统领域,研究方向包括大模型推理优化、异构计算及人工智能基础设施。拥有从前沿研究、核心技术研发到产品工程化落地的丰富经验。为企业级大模型推理基建开源项目 ModelSphere(模域) 发起人、信创算力社区 ModelHub XC(信创模盒) 发起人。
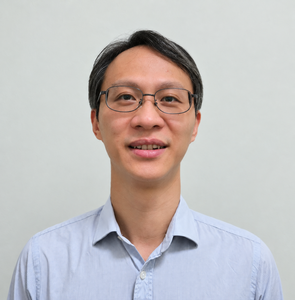
专题演讲嘉宾:卢冕
范式智能AI Infra 部门负责人
by 卢冕
范式智能
AI Infra 部门负责人企业把大模型迁到私有化环境后,既要在异构算力上尽快完成可用部署,也要在上线后稳住服务质量与生成连续性,并随负载变化持续优化。围绕这条从 Day-0 到线上稳态的主线,本演讲将介绍:
- 如何结合专家知识与调优能力给出面向不同硬件与工作负载的部署方案
- 如何在网关侧用 TTFT、解码速率等信号做自适应限流,并在质量优先与吞吐优先之间取舍
- 如何在服务崩溃或断连时于网关层续写,使客户端仍看到完整输出
- 如何基于线上蓄水做周期自动调优。最后结合互联网与信创案例,在写清基线与 SLO 的前提下说明吞吐提升与峰值 TPM 的成立条件
演讲提纲
- 背景与需求:企业大模型私有化部署的挑战
- 驱动因素:数据安全、隐私保护、合规与数据主权,推动自建推理基础设施
- 工程难点:部署复杂、GPU 成本高、异构硬件适配难,同时要兼顾高并发、低延迟与高可用
- 核心目标:统一、易用、高性能且可持续优化的推理基础设施
- ModelSphere 整体技术架构与定位
- 定位:基于开源技术,将模型部署、资源调度、推理服务、性能优化与运维管理整合为完整方案
- 核心特性:开箱即用、面向生产;统一支持多种异构加速器
- Day-0 与持续演进:结合专家知识与调优能力,尽快给出可部署方案,并随负载持续优化
- 质量感知的动态限流
- 难点:静态 RPM/TPM 难以约束 TTFT、输出速率等体验指标
- 方法:网关侧基于实时解码速率(TPS)的自适应并发控制(ACC);EWMA 平滑采样;借鉴 TCP 拥塞控制的 MIMD(减快增慢)
- 取舍:反馈周期、限流速率、质量目标阈值可配置;策略可倾向质量优先或吞吐优先
- Day-0 部署与流式生成中断续写
- Day-0 难点与方法:引擎参数空间巨大;结合领域专家知识与 tuning agent,经 model catalog 发布面向不同硬件与工作负载的部署方案
- 续写难点:引擎迭代快,生成过程中崩溃、断连、EOF 或长时间停滞会导致答案不完整
- 续写方法:网关层单请求有状态编排(不改引擎);累积已输出、前缀拼接后续写;SGLang / vLLM 路径差异与适用边界
- 真实负载驱动的自动调优
- 难点:负载变化后,已部署优化方案可能不再适用
- 方法:基于线上蓄水数据(蓄水周期可配置);网格搜索、启发式、基于大模型的 tuning agent 三类策略
- 节奏:按 workload 变化频率控制调优力度与资源分配(一般推荐周度)
- 实际部署案例与小结
- 案例一(互联网):相对 SGLang Cookbook 基线吞吐提升 30%+;在 TTFT < 10s、OTPS > 20 的 SLO 下稳定提供峰值千万量级 TPM
- 案例二(信创):信创算力适配与深度优化后上线;结合自动扩缩容平衡异构资源效率与服务质量
- 可带走:开源对照 ModelSphere(含续写网关 / AutoTune 组件);对外数字须带基线、SLO 与峰值口径
听众收益
- 掌握企业大模型私有化部署与推理生产的技术思路:统一平台如何覆盖 Day-0 部署、异构适配、服务质量与持续优化
- 借鉴一线工程实践:质量感知限流、流式中断续写、线上蓄水自动调优的方法要点与适用边界
- 获得可对照的案例口径:在写清基线与 SLO 的前提下理解吞吐 / 峰值 TPM 表述,以及信创算力适配与扩缩容的实践参考
关注主办方(InfoQ)
联系我们
交通指南
北京新云南皇冠假日酒店
Crowne Plaza Beijing Sun Palace
地址:北京市
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手