苏乐,蚂蚁集团 AI Infra 技术专家,目前主要负责 AReno 项目的研发,曾就职隐私计算初创公司担任高级技术专家,负责隐私计算核心系统研发,曾在蚂蚁负责 Ray 分布式计算系统的研发,对 Ray 进行过系统性的底层优化。本科毕业于清华大学,曾参与工控系统安全相关科研,低功耗蓝牙安全相关科研。
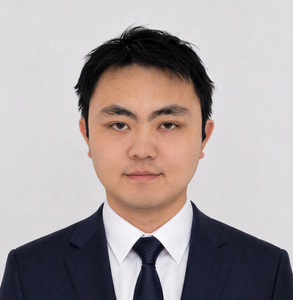
专题演讲嘉宾:苏乐
支付宝高级技术专家
by 苏乐
支付宝
高级技术专家大模型后训练面临训练与推理衔接复杂、显存占用高及计算路径差异影响策略优化等问题。本次分享介绍 AReno 训推一体架构的设计与技术选型,通过共享参数与计算组件,统一支持监督微调、偏好优化和在线强化学习。重点解析 MoE 路由记录与重放、变长样本打包、分页缓存,以及低比特优化器、QLoRA 与 MST 分块重计算的组合方案。在 DGX Spark 上,Ling-3.0-tiny 模型 16K 上下文实测中,QLoRA 结合 MST 将训练峰值显存从 37.785 GiB 降至 11.973 GiB,降低 68.31%。同时介绍 AReno Flow 如何贯通任务规划、运行诊断与服务部署,为有限资源下的大模型后训练提供工程参考。
演讲提纲
- 后训练瓶颈与架构选型
- 拆解采样、评分、数据组织、训练与阶段切换,以完整迭代耗时和阶段峰值显存定位瓶颈
- 区分 GPU 资源共置与参数共享,介绍生成、更新分阶段执行及共享参数原地更新机制
- 通过统一训练序列与损失入口,支持 SFT、DPO、GRPO/GSPO 和 PPO,复用底层执行能力
- 训推一致性与 MoE 路由重放
- 分析计算路径、累加精度与专家选择差异如何影响 logprob、概率比及策略更新
- 采样时记录每个 token、每层的专家索引,训练时重放相同选择,并根据当前得分重算路由权重
- 减少重复 top-k 造成的路由分叉,同时保留梯度传播,说明该方法的一致性边界
- 训练与推理执行优化
- 训练侧采用变长样本打包、注意力边界隔离、奖励与损失掩码对齐,结合微批和激活重计算控制开销
- 推理侧结合分页 KV 缓存、连续批处理与批量分桶图重放,提高资源复用效率
- 通过 TP/DP 协作及归一化、门控等算子融合,减少中间张量与重复访存
- 显存优化方法与实测案例
- 按显存来源组合选型:LoRA 减少可训练状态,QLoRA 压缩基座权重,MST 通过反向分块重计算降低长序列中间张量峰值
- 优化器状态按桶卸载,结合锁页主存、双桶预取与异步写回,复用 GPU 工作区
- DGX Spark 上,Ling-3.0-tiny 短序列实验中,QLoRA 较 LoRA 训练峰值显存降低 48.61%;16K 上下文下,QLoRA 叠加 MST 后从 37.785 GiB 降至 11.973 GiB,降低 68.31%
- AReno Flow 工程闭环
- 从自然语言需求生成可编辑的模型、算法、资源与执行配置
- 以训练阶段事件驱动耗时、指标、样本和日志诊断,保留配置与执行记录以支持复现
- 管理完整模型、适配器及量化元数据,贯通训练产物保存、恢复与服务部署
听众收益
- 形成训推一体架构的选型判断
- 理解资源共置、参数共享与统一执行接口的适用边界,结合现有技术栈,评估后训练系统的改造路径与成本
- 掌握显存优化的组合方法
- 按权重、优化器状态和中间张量定位瓶颈,理解 QLoRA、MST 及状态卸载的收益与代价,制定兼顾容量和迭代效率的方案
- 建立后训练系统的诊断思路
- 掌握 MoE 路由重放、训推概率差异分析及阶段指标关联方法,提高策略更新异常、显存峰值和性能瓶颈的定位效率
演讲亮点
- 最打动听众的是训推一体架构设计与有实测支撑的显存优化实践:既深入解析MoE路由重放如何减少训推差异,也展示QLoRA与MST如何协同降低资源门槛。在DGX Spark上,Ling-3.0-tiny模型16K上下文实验中,叠加MST后,QLoRA训练峰值显存由37.785 GiB降至11.973 GiB,降低68.31%。听众能获得具体的技术选型依据和工程经验,用于有限资源下的后训练实践。
关注主办方(InfoQ)
联系我们
交通指南
北京新云南皇冠假日酒店
Crowne Plaza Beijing Sun Palace
地址:北京市
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手