栾小凡是 Zilliz 合伙人和CTO,Milvus项目的主席,同时是 LF AI & Data 基金会技术咨询委员会成员。在加入 Zilliz 前,他在阿里云担任研发经理,负责 NoSQL 数据库 Lindorm 的研发工作。栾小凡拥有康奈尔大学计算机工程硕士学位。
从在线检索到离线挖掘:Zilliz On-Demand 如何为机器人与模型训练做数据策展
所属专题:Knowledge Engineering|让 Agent 理解企业
嘉宾 : 栾小凡 | Zilliz联合创始人 & CTO
讲师介绍
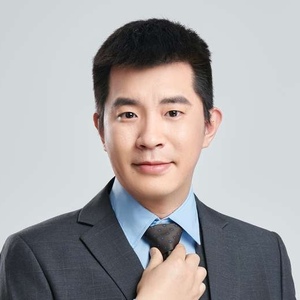
专题演讲嘉宾:栾小凡
Zilliz联合创始人 & CTO
议题介绍
演讲:从在线检索到离线挖掘:Zilliz On-Demand 如何为机器人与模型训练做数据策展
如果说数据是 AI 的化石燃料,那么埋得最深、储量最大的一层是非结构化数据:视频、图像、传感器流、机器人轨迹、agent 交互日志,占全球数据的 90% 以上。过去十年,Databricks 和 Snowflake 为那 10% 的结构化数据建起了完整的湖仓、计算和治理体系;而 90% 的非结构化数据至今没有对应的平台。向量数据库解决了其中最靠近用户的一小段,也就是在线检索,但真正的价值挖掘发生在离线:从 PB 级极度冗余的轨迹里找出千分之一的 corner case,从海量语料里去重、分层、构建评测集。传统向量数据库为毫秒延迟设计,常驻集群让"一周跑几次的大规模挖掘"成本高昂;数据湖和 Spark 能批处理,却没有向量索引,语义去重只能依赖 k-means 加暴力两两比对。化石燃料不经炼化无法使用,而今天的炼化链路被拆在两套系统里,数据反复复制,飞轮转不起来。
本次分享介绍 Zilliz On-Demand:数据、向量和索引常驻对象存储,计算按需拉起、用完释放,把 hard negative 挖掘、语义去重、聚类策展、评测集构建这类离线工作变成可复现的作业,并与在线检索共享同一份数据和索引。我们的目标是成为那 90% 数据的 Databricks。内容覆盖架构实现、面向机器人与模型训练团队的典型工作流,以及大 topK、量化与 recall、冷启动等工程取舍。
演讲提纲
- AI 的化石燃料:90% 的数据还没有自己的平台
- 数据是 AI 的化石燃料:模型能力来自对历史数据的"炼化",而不是数据本身;没有挖掘和策展的原始数据只是埋在地下的储量
- 全球数据 90% 以上是非结构化的:视频、图像、点云、传感器流、机器人轨迹、agent 交互日志,且增速远高于结构化数据
- 结构化那 10% 已经有了完整的平台:Databricks 和 Snowflake 用十年建起湖仓、计算引擎、Catalog 和治理;非结构化那 90% 还停留在"S3 桶 + 一堆脚本"
- 向量数据库只解决了最靠近用户的一段:在线检索。真正的价值挖掘在离线:机器人与自动驾驶轨迹、多模态训练语料、模型评测与 rollout 数据
- 这类数据的四个特征:量大(PB 级)、多模态、极度冗余、价值在长尾。一辆车一天 TB 级数据,有价值的 corner case 不到千分之一
- 数据飞轮的完整链路:采集 → embedding → 挖掘与策展 → 标注 → 训练 → 评测 → 部署 → 再采集
- 为什么这是"离线为主"的 workload:查询次数少但每次很重(topK 1K 到 100K)、按训练周期突发、延迟可以容忍分钟级,但对吞吐和成本极度敏感
- 脱敏案例:某自动驾驶团队的"人 + agent 协同"hard negative 挖掘平台,以及它在传统向量数据库上遇到的问题
- 现有基础设施为什么都不合适
- 向量数据库:为 QPS 和毫秒延迟设计,CU 7×24 常驻付费,而挖掘作业一周只跑几次;大 topK 时每个 segment 都要算满 K 再归并,成本随 topK 线性上涨;数据必须先导入,导入本身就是一次复制
- 数据湖 + Spark:能扫全量数据,但没有向量索引。行业现状是 embed → k-means → 簇内暴力两两比对做语义去重,pair 数随规模平方增长,也无法交互式地"拿一个场景找相似"
- 两套系统各存一份数据、各维护一套 embedding 和 schema;模型换一版 embedding,两边都要回填和重建索引
- 后果:挖出来的 corner case 回不到训练集,训练出的新模型回不到在线检索,在线反馈也进不了离线评测。炼化链路被拆成两段,燃料在管道里反复搬运
- Zilliz On-Demand 的核心实现
- 核心思想:数据、向量和索引常驻对象存储,计算按需拉起、用完释放;在线检索和离线作业是同一份数据的两种消费方式
- 统一湖存储与 External Table:原始帧、轨迹、传感器数据留在客户已有的湖里,直接挂载,不复制不迁移
- 湖原生索引:向量索引、全文索引、标量过滤索引作为湖上的文件存在,而不是某个常驻节点的内存状态
- 按需计算层与缓存:作业启动时把需要的索引和热数据加载到计算层,作业结束即释放;冷启动时间是这条路线的生死指标
- Snapshot:每一次挖掘、每一个评测集、每一份训练数据切分对应一个一致的数据版本,可复现、可对比、可回滚
- 大 topK 批量相似检索的工程取舍:分段算 K 与归并的瓶颈、量化(RaBitQ/SAQ 类方法)与 recall 的权衡、批量查询合并
- 基于 Spark 的离线算子:主键去重、基于真实 ANN 索引的语义近似去重、KMeans 聚类、离群样本挖掘、分层采样、VLM 批量打标与 UDF
- 在线引擎与 Spark 引擎的数据交换:Spark 产出新数据集、标签或 embedding → 构建索引 → Snapshot 发布 → 在线立即可见
- 面向机器人与模型训练的典型工作流
- 机器人与自动驾驶
- Corner case 挖掘:用一个失败场景做 query,在全部历史轨迹里批量找相似(hard negative 与 hard positive)
- 长尾采样:聚类后按簇大小反比采样,削掉巡航冗余、放大稀有场景
- 场景覆盖评估:新采集数据与现有训练集的分布对比,找出没覆盖的区域
- 人 + agent 协同:人给种子样本,agent 批量扩展、聚类、推荐标注队列
- 模型训练(预训练与后训练)
- 语料语义去重与质量分层
- 评测集构建与去污染:训练集与测试集的语义重叠检测
- rollout 与 agent trace 挖掘:从轨迹里找失败模式,构造 RL/SFT 数据
- Embedding 版本迭代:新模型发布后全量重算 embedding、重建索引,用 Snapshot 对比新旧效果
- 完整闭环(一张图):在线应用和机器人产生轨迹与反馈 → 直接沉淀到统一湖存储 → 按需拉起 Spark 挖掘、去重、聚类 → 产出数据集、标签、embedding 或索引 → Snapshot 验证后发布到在线系统和训练流水线
- 机器人与自动驾驶
- 总结与架构边界
- 90% 数据的 Databricks:不是用数据湖替代向量数据库,也不是把向量数据库做成数据湖,而是让非结构化数据第一次拥有"存储、索引、在线检索、离线计算、版本"一体的平台
- 适合:批量、突发、大 topK、成本敏感的挖掘和策展作业;不适合:毫秒级在线服务
- 下一步:curation 算子的开放、GPU 算子加速、与训练框架的数据接口
听众收益
- 了解如何从 PB 级视频、图像、机器人轨迹及 Agent 交互日志中,挖掘长尾样本、Corner Case 和高价值训练数据,构建从原始数据到高质量数据集的完整链路
- 了解如何利用对象存储、湖原生向量索引与按需计算,实现语义去重、聚类策展、Hard Negative 挖掘和评测集构建,降低大规模数据处理的计算与存储成本
- 了解如何通过统一数据存储、索引和 Snapshot 机制,打通数据采集、挖掘、标注、训练、评测与在线检索,提升数据复用效率和 AI 数据飞轮的运转效率
关注主办方(InfoQ)
联系我们
交通指南
北京新云南皇冠假日酒店
Crowne Plaza Beijing Sun Palace
地址:北京市
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手