主要研究智能体系统、AI自进化以及大模型后训练相关技术。发表学术论文四十余篇,拥有十余项国际专利,获 AAAI 2026 杰出论文奖、WAIC 2026 青年优秀论文提名奖。长期担任 NeurIPS、ICLR、ICML 和AAAI等国际会议的领域主席。长期支持微软内部的模型研发以及产品技术转化,相关技术应用于 Office、Azure 等微软核心产品。主导的开源项目累计获得超过2万 GitHub Stars。
讲师介绍
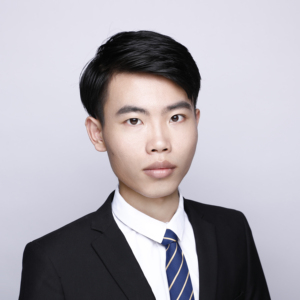
专题演讲嘉宾:杨一帆
微软亚洲研究院高级研究员
议题介绍
演讲:闭环 AI 自我进化:从 Skill、Harness 到模型训练与评估
本次分享结合一系列研究工作,探讨递归自我改进(RSI)的关键问题与解决方案。在技能与执行层面,SkillOpt 依据执行反馈更新可复用技能,HarnessOpt 协调工作流、工具、记忆与恢复机制的改动;在训练与评估层面,EnvOpt 随学习者的变化调整可执行训练环境,支持模型迭代训练,EvalOpt 则基于人类偏好改进评估与反馈策略,以更好地支持开放式任。
RetriEvolver 展示了自我演进在异构检索系统中的应用成效。分享还将结合实验结果与失败案例,讨论如何明确改进对象、以证据指导改动并验证效果,据此保留有效改进、积累经验。
演讲提纲
- 递归自我改进:从执行经验到能力提升
- 改进对象:技能、执行系统、训练环境与评估机制各自解决什么问题
- 闭环设计:从任务反馈中提出改进、验证效果并积累经验
- 设计取舍:选择优化切入点,兼顾改进效果、优化成本与稳定性
- Skill 与 Harness:技能与执行系统的自我改进
- SkillOpt:依据执行反馈优化可复用技能
- HarnessOpt:协同改进工作流、工具、记忆与恢复机制
- RetriEvolver:HarnessOpt 在异构检索系统中的应用实践
- 模型训练与评估:优化学习过程本身
- EnvOpt:随学习者能力变化调整可执行训练环境,支持模型迭代训练
- EvalOpt:基于人类偏好改进评估与反馈策略,支持开放式任务
- 总结与展望
听众收益
- 理解 Skill、Harness、模型训练与评估层面的自我改进方法及其适用范围
- 获得从任务反馈到效果验证的闭环设计思路,判断哪些改动值得保留和复用
- 结合自身系统识别优化切入点,规划可逐步实施、可验证的演进路径
关注主办方(InfoQ)
联系我们
交通指南
北京新云南皇冠假日酒店
Crowne Plaza Beijing Sun Palace
地址:北京市
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手