来自蚂蚁集团平台工程与技术风险部,在技术风险领域深耕 9 年,曾负责智能变更管控、无人值守发布等平台的架构设计与落地。自 2023 年起聚焦大模型与 Agent,探索将 Agent 应用于 SRE 的知识整理、变更管控和应急定位等工作,在控制技术风险的同时,帮助 SRE 提升效率。
Self-Evolving Agents 的底座:蚂蚁集团 Ontology 的设计与实践
所属专题:Self-Evolving Agents|从经验学习到可控进化
嘉宾 : 俞灏宣 | 蚂蚁集团技术专家
讲师介绍
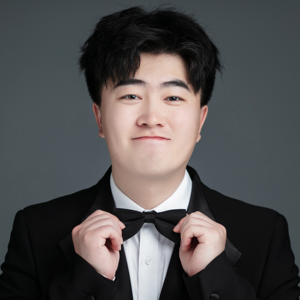
专题演讲嘉宾:俞灏宣
蚂蚁集团技术专家
议题介绍
演讲:Self-Evolving Agents 的底座:蚂蚁集团 Ontology 的设计与实践
企业 Agent 要持续提升任务能力,需要不断更新对业务的理解,并将任务中的发现沉淀为可复用的知识。然而,企业事实分散在代码、数据库和各类平台中,业务持续变化,单次对话中的经验也难以跨任务积累。如何让 Agent 的业务理解持续演进,并验证每次改进是否有效?
本次分享将介绍蚂蚁集团 AntOntology 的设计与实践,阐述如何通过统一的业务对象、属性与关系,连接分散的企业事实,为 Agent 提供可发现、可查询、可追溯的业务上下文。进一步结合 Agent 辅助本体挖掘、领域审核、分层评测与失败归因,介绍业务知识从发现、验证到发布和复用的持续演进机制。最后通过实际案例,讨论 Ontology 如何与 Skill、Agent 执行系统及权限治理协作,为 Self-Evolving Agents 构建可积累、可验证的企业知识底座。
演讲提纲
- 企业 Agent 的成长:从通用能力到业务认知
- 理解瓶颈:业务语义分散、跨系统关系缺失、任务经验难以复用
- 进化对象:企业知识、业务关系与任务方法
- 蚂蚁集团 Ontology 的设计与构建
- 统一语义:以对象、属性和关系组织业务知识,按需连接权威数据源
- 辅助构建:Agent 挖掘候选知识,经证据追溯、领域审核与验证后使用
- 从任务反馈到持续进化的工程闭环
- 反馈驱动:从真实任务中发现知识缺口,完善本体并沉淀 Skill
- 效果验证:结合接口探测、语义与推理评测、失败归因和回归验证,检验改进效果
- 工程实践与落地经验
- 应用案例:排障、业务上下文查询与周期巡检
- 设计取舍:语义一致性、知识时效性、运行时权限,以及自动更新与人工审核的平衡
听众收益
- 掌握企业 Agent 知识底座的设计方法。 理解 Ontology 与 RAG、Memory、Skill 的分工,学会通过业务对象、属性和关系组织跨系统事实,为所在团队设计可共享、可持续维护的业务上下文
- 获得 Agent 持续积累业务知识的工程实施路径。 借鉴代码与数据源挖掘、证据溯源、领域审核及能力发布流程,明确自动化与人工审核的职责,规划新业务领域的接入和知识更新机制
- 建立评估和改进 Agent 能力的方法。 利用分层评测与执行轨迹,区分知识缺口、工具异常和规划问题,定位建设瓶颈,并通过回归验证判断改进是否有效,为技术选型和研发投入提供依据
演讲亮点
- Agent 既使用业务知识,也参与知识建设
- 展示 Agent 如何从代码、数据库和既有关系中挖掘业务对象,形成带证据的本体候选,经领域审核与评测后供后续任务复用,让“持续进化”对应具体的工程过程
- 把分散的企业事实组织成可查询的业务上下文
- 通过统一的对象、属性与关系,连接跨系统标识和权威数据源,并通过 CLI 与 Skill 向不同 Agent 提供共享能力。结合 Trace 排障等案例,说明这层业务语义如何帮助 Agent 组织查询路径、关联证据
- 用分层评测解释 Agent 为什么失败、应该改哪里
- 展开本体探测、对象与关系语义评测、跨域多跳任务评测,结合完整执行轨迹区分知识缺口、接口异常和规划问题,使改进有依据、效果可验证。
- 提供可供听众借鉴的落地方法
- 分享本体建模、证据管理、专家审核、能力发布与回归验证中的具体做法,同时说明自动化的适用范围及人工治理环节,帮助听众判断如何在自己的企业场景中实施
关注主办方(InfoQ)
联系我们
交通指南
北京新云南皇冠假日酒店
Crowne Plaza Beijing Sun Palace
地址:北京市
Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频
如您在购票过程中遇到问题,请扫码咨询票务小助手