目前负责GMI Cloud面向全球场景大规模跨云异构算力的Maas系统架构设计和研发工作。曾就职于百度、三一重工、面壁智能等国内一线互联网和大模型企业,担任AI基础设施和产品的架构师。专注于AI基础设施和云原生技术10+年经验,在大规模的算力调度、异构算力管理、云原生基础设施等方面有丰富的实践经验。
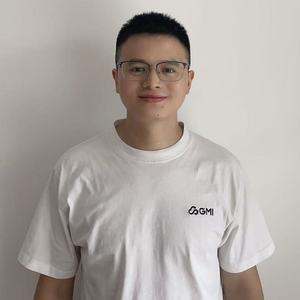
专题演讲嘉宾:汪小康
GMI Cloud资深架构师
by 汪小康
GMI Cloud
资深架构师随着 AI 应用在各行业加速渗透,全球化落地过程中核心瓶颈日益凸显。推理效率不足、GPU 集群稳定性波动,成为制约技术规模化落地的关键痛点。为破解这一难题,很多MaaS(模型即服务)平台应运而生,凭借其资源弹性调度与大规模API调用能力,解决了AI企业的问题。然而随着MaaS平台的发展,企业又再次面临成本高昂的挑战。一方面,高端GPU资源极度稀缺,MaaS平台很少有充足且高端的算力来支持推理和优化;另一方面,对于MaaS平台来说,市场上GPU云供应商众多,标准不统一导致选择困难与迁移成本高昂。同时,对于AI企业来说,全球化业务需要在多地域部署AI推理服务,但分散的资源管理增加了基础设施建设的复杂度与成本。
演讲提纲:
1. 看到问题:AI应用出海热,全球扩容、推理需求爆发
2. 提出方案:集成全球模型的MaaS平台——GMI Cloud Inference Engine
3. 众多MaaS平台同遇新难题:全球「高性价比算力资源」获取难、管理复杂度高
4. 解决难题:Inference Engine 2.0架构全新升级——统一调度平台深度解析
听众收益:
1. 了解MaaS平台底层的多云GPU资源整合方案:了解如何打破云厂商壁垒,构建统一的异构资源管理平台,降低迁移成本与技术风险
2. 学习全球化AI推理部署架构:深入理解多地域集群管理、就近路由、流量智能分发等关键技术,满足全球业务低延迟需求
3. 获取实战级调度系统设计经验:学习两级调度决策模型、资源拓扑感知、故障自动重调度等生产级调度系统的设计与实现方法
4. 提升资源利用率与降低成本:通过案例了解如何将GPU利用率从行业平均45%提升至75%以上,实现资源的高效利用
关注主办方(InfoQ)
联系我们
交通指南
北京石景山万达嘉华酒店
Wanda Realm Beijing
地址:北京市石景山区石景山路甲18号院

Copyright © 2026, Geekbang Technology Ltd. All rights reserved. 极客邦控股(北京)有限公司 | 京 ICP 备 16027448 号 - 5 京公网安备 11010502039052号 | 产品资质

微信咨询

电话咨询
联系电话:13269078023

领取往期热门演讲视频

如您在购票过程中遇到问题,请扫码咨询票务小助手